生产级强化学习(RL)里最危险的故障,往往不是任务崩溃,而是任务照常运行,优化的却是一条系统实际上从未生成过的轨迹。
问题是这样出现的:rollout 引擎从模型中采样 token,训练端随后重新计算这些 token 的概率(log-prob),再据此算梯度。如果训练端重新分词某个工具调用,得到的 token ID 和采样时不同;或者混合专家(MoE)层在训练端选中了不同的专家,那么即便权重完全相同,两边描述的也已经是两个策略。内核、数值精度和 batch 形状则会造成第三种偏差:数值偏移。全异步执行(训练端更新权重的同时,生成仍在继续)还会带来第四种偏差:样本来自较旧的权重版本。
Miles v0.1 没有提出新的损失函数。它的主要贡献,是把这种训推不一致(train–rollout mismatch)当作一个核心的系统问题来处理:把“rollout 引擎和训练端跑的是同一个策略”拆成几条可以逐项检查的具体保证,再在这个基础上构建全异步调度、低精度执行、内存卸载和万亿参数模型的权重同步。
本文综合了论文、下方嵌入的八分钟演讲、配套的 38 页幻灯片以及 Miles 源代码。阅读前提是了解 LLM、GPU 和基础 RL:策略、奖励,以及近端策略优化(PPO)、组相对策略优化(GRPO)这类算法;不要求你看过 RL 训练系统的内部实现。各节层层递进:
- §1–2:训练循环,以及两边可能出现分歧的四种方式。
- §3–4:针对 token、MoE 路由和数值的修复。
- §5–7:支撑速度与规模的机制:全异步训练、低精度、内存和权重传输。
- §8–9:两种训练后端、RL 之外的训练方法,以及 GLM-5.2 端到端案例。
- §10–11:源码透露的工程取向,以及分阶段引入 Miles 的路径。
配套资料
视频
在 YouTube 上打开视频。快速跳转:00:00 概览 · 01:28 训推不一致 · 03:07 低精度 · 03:49 全异步 · 05:15 权重更新 · 07:17 GLM-5.2 案例研究。
幻灯片
1. 系统一览:三个阶段、四个核心对象
传统的 LLM 强化学习就是两步来回循环:先生成一批简短回答,再更新模型。智能体 RL 把每个回答拉长成一条长时间运行的链路:模型进行多轮对话、调用工具、等待沙箱返回,再接着生成。与此同时,rollout 要求低延迟,训练端要求高吞吐,而超大规模 MoE 必须横跨许多 GPU。
Miles 的办法是把整个任务拆成边界清晰的三个阶段:
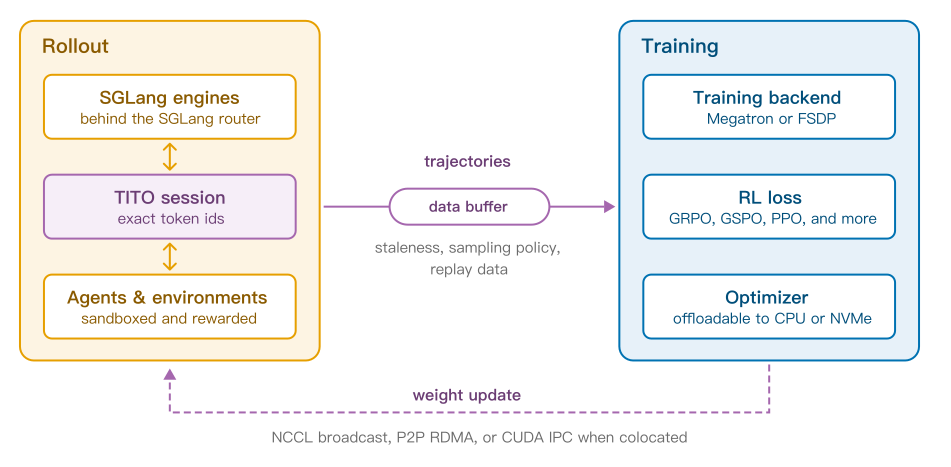
- Rollout。SGLang 推理引擎生成轨迹。在智能体 RL 中,每个 rollout session 都连接自己独立的环境,由环境执行模型的动作并给出奖励。
- 训练。训练端基于 NVIDIA Megatron-LM 或 PyTorch FSDP(Fully Sharded Data Parallel,全分片数据并行),读取已完成的轨迹组,计算 RL 损失并更新策略。
- 权重更新。每个训练步之后,Miles 把新权重发给 rollout 引擎,同时尽量少打断正在进行的 rollout。
这三个阶段不必轮流执行。如果按部就班地交替,训练端要等最慢的那条轨迹,之后引擎又要等优化器。第 5 节介绍的全异步模式让引擎在训练端工作时继续生成。
这个循环里有四个对象很容易混淆:
- Prompt(提示):从数据集中抽取的一项任务。
- Trajectory(轨迹):策略的一次完整尝试,可能横跨多轮交互。
- Group(组):同一个 prompt 的多条轨迹。GRPO 等算法在组内比较奖励,奖励高于组内平均水平的尝试才算好。
- Session(会话):服务层看到的一次多轮对话。一个 session 可以产生一条或多条轨迹(第 3 节会说明什么情况下产生多条)。
举个具体例子:prompt 是“让这个失败的测试通过”。策略做了几次尝试,这些尝试构成一个 group。最简单的情况下,每次尝试就是一个 session:模型在多轮交互中读文件、在沙箱里跑测试、修改代码。这个 session 最终产出一条轨迹。
驱动这三个阶段的同步主循环很短。每个 rollout 步依次:
- 收集一批 rollout 数据;
- 用这批数据训练;
- 到了保存间隔就存 checkpoint;
- 把新权重发回 SGLang;
- 到了评估间隔就触发评估。
源代码有意让这一层保持接近伪代码,把复杂性下沉到边界清晰的组件里。
实现细节
- 这个循环位于
train.py,它会拒绝--fully-async;异步驱动是train_async.py(第 5 节)。 - 当训练端和 rollout 引擎共用 GPU 时,循环还会在每个阶段前后把模型状态和缓存搬上、搬下 GPU(
--offload-train、--offload-rollout;第 7.1 节)。 - 最后一个 rollout 步之后,除非还有一次评估要跑,循环会跳过权重更新。
有一个细节关系到正确性:在第一次优化器更新之前,Miles 会先执行一次权重更新,把训练端刚加载好的权重推送给 rollout 引擎。于是 SGLang 的起点是走过训练端自身加载与转换路径的权重,而不是另外独立加载的一份 checkpoint,两边从一开始就持有完全相同的权重。
Disk-delta 传输是唯一的例外:它的第一次更新不发布任何内容,两边改为从磁盘上的同一份 checkpoint 起步(第 7.2.4 节)。还有一个可选的预检 --check-weight-update-equal,可以在这次初始同步之后立即比对引擎权重(第 7.2.5 节)。
2. 四类不一致
策略梯度的数学有一个前提:训练端打分的,正是 rollout 引擎采样出来的那些 token,而且用的是采样时的同一个策略。在生产系统里,这个前提至少可能在四个地方失守。Miles 把每一处都当作一条独立的约束,各用一套机制来处理。
最简单的体检指标是逐 token 的比率。rollout 引擎每采样一个 token,都会记下自己给它的 log-prob,记作 $\ell_t^{\mathrm{roll}}$。更新之前,训练端用更新前的权重对同一个 token 重新算一遍 log-prob,记作 $\ell_t^{\mathrm{train,old}}$。理想情况下两者相等:
\[m_t = \exp\left(\ell_t^{\mathrm{train,old}}-\ell_t^{\mathrm{roll}}\right)=1\]说得直白些:rollout 给某个 token 的概率是 0.40,训练端算出来也是 0.40,那么 $m_t=1$。如果训练端算出的是 0.44,$m_t=1.1$,这就说明算这个 token 的梯度时用的策略,和实际生成它的策略有了细微差别。第 4.2 节会再详细讨论这个比率。
下表列出这四个地方各自会出什么问题,以及 Miles 如何应对:
| 层面 | 哪里出错 | Miles 的应对 | 代价或局限 |
|---|---|---|---|
| Token | 文本解析、工具调用 JSON 重排,或重新套用聊天模板,改变了 token 序列 | TITO(Token-In-Token-Out)session 服务端保留原始 token ID(第 3 节) | 当前 session 服务端不支持图像或视频输入 |
| 路由 | MoE 的 top-k 专家选择对微小数值误差十分敏感 | R3(Rollout Routing Replay,路由重放)重放 rollout 时的专家分配(第 4.1 节) | 长序列需要额外的存储和传输 |
| 数值 | 内核、精度、batch 形状或并行布局不同 | 截断重要性采样(TIS)或 clip-or-pop(越界即丢弃,第 4.2 节),或 true-on-policy 模式(第 4.3 节) | 校正无法消除不一致;严格对齐会牺牲吞吐,且只注册了稠密 Qwen3 0.6B/4B |
| 时间 | 全异步模式下,轨迹来自较旧的权重 | 为每段 token 打上权重版本标签,在消费时测量陈旧度,并可选地设上限(第 5 节) | 训练仍是 off-policy 的;只有设置了陈旧度上限,滞后才有界 |
这几种机制不能互相替代,因为它们各管一个不同的等式。按 token $t$ 写出来,四条约束是:
\[z^{\mathrm{roll}}_{<t}=z^{\mathrm{train}}_{<t},\qquad A^{\mathrm{roll}}_{j,t}=A^{\mathrm{train}}_{j,t},\qquad \ell^{\mathrm{roll}}_t=\ell^{\mathrm{train,old}}_t,\qquad v_t=v_{\mathrm{current}}.\]- token 相同。 $z_{<t}$ 是位置 $t$ 之前的 token 前缀。两边看到的必须是完全相同的 token ID,光是文本相同还不够。这一条由 TITO 保证。
- 路由相同。 $A_{j,t}$ 是 MoE 第 $j$ 层为 token $t$ 选中的专家集合,例如专家
{2, 7}。这一条由 R3 保证。稠密模型没有路由,这条约束对它不适用。 - log-prob 相同。 $\ell_t$ 是采样出的 token 的 log-prob。在 true-on-policy 对齐覆盖的配置下,这一条由它保证。
- 权重版本相同。 $v_t$ 是生成 token $t$ 时的权重版本。全异步执行有意打破这一条;异步 buffer 负责测量违背的幅度,设置上限时会丢弃超出上限的 group。

前三条约束层层递进:路由记录只有对应同一个 token 才有意义;log-prob 也只有在 token(对 MoE 模型来说还有路由)一致之后才可能对得上。但每一层仍是单独的保证:token 一致推不出路由一致,路由一致也推不出数值一致。第四条与前三条无关:即使 token、路由和数值全都精确一致,也不能让一条旧轨迹变成当前策略的轨迹。
TIS 和 clip-or-pop 不建立上面任何一个等式。它们做的是限制剩余的策略比率偏差对梯度的影响。这部分剩余偏差包括数值漂移,以及全异步执行下的权重陈旧。
本文还有两种机制容易被误认为是在修复不一致。更快的点对点(P2P)或磁盘增量(disk-delta)权重传输(第 7 节)可以缩短版本延迟,但没法校正已经陈旧的样本。On-Policy 蒸馏(OPD,第 8 节)改变的是学习信号,并不能让 rollout 和训练端重新变回同一个策略。
3. TITO:不要把 token 还原成文本后再猜一次
多轮智能体每一轮都要绕一圈:模型生成的 token 先解码成文本,交给 harness(负责解析回复、调用工具、拼装下一轮请求的智能体程序),下一轮再把文本重新分词成 token。这一圈可能有损。下一轮的模型以及之后的训练端看到的 token 序列,可能和模型当初真正采样出的不一样。TITO 的做法是:采样出的 token ID 一直留在服务端,永远不从文本重建。
哪里会出错。智能体通常通过 message API 和模型交互:模型生成 token,harness 拿到解析后的文本或工具调用,工具执行完,harness 再把完整消息历史发回来。解码、解析、重新序列化、重新分词这一串操作并不是恒等变换。常见的漂移方式有:
- harness 重写了工具调用的 JSON,键的顺序或空白不同,或者把缺省参数替换成
{}; - harness 丢掉了上一轮的 reasoning 文本;
- 聊天模板渲染出的轮次边界和模型实际输出的不一致,比如 stop token 后面多出一个换行。
任何一处变化都会改变 token ID,后果出现在两个地方:
- 下一轮 serving。假设第 1 轮的 prompt ID 是 $P_1$,采样出的 output ID 是 $O_1$。如果第 2 轮把整段对话重新分词,重建出的 prompt $\widetilde P_2$ 不一定以 $P_1\Vert O_1$(两段 ID 首尾相接)开头。于是,第 2 轮模型看到的历史,其实是引擎从未生成过的一段内容。
- 训练。如果数据管线再把对话渲染一遍,训练端打分的就是一条重建出来的序列,而不是 rollout 真正产生的 token 谱系。算出来的 log-prob 描述的是一条从未发生过的轨迹。
TITO 先修好轮次边界,再把同一条 token 谱系原样带进训练。只要求训练端用同一个分词器是不够的:它要分词的文本本身已经变了。
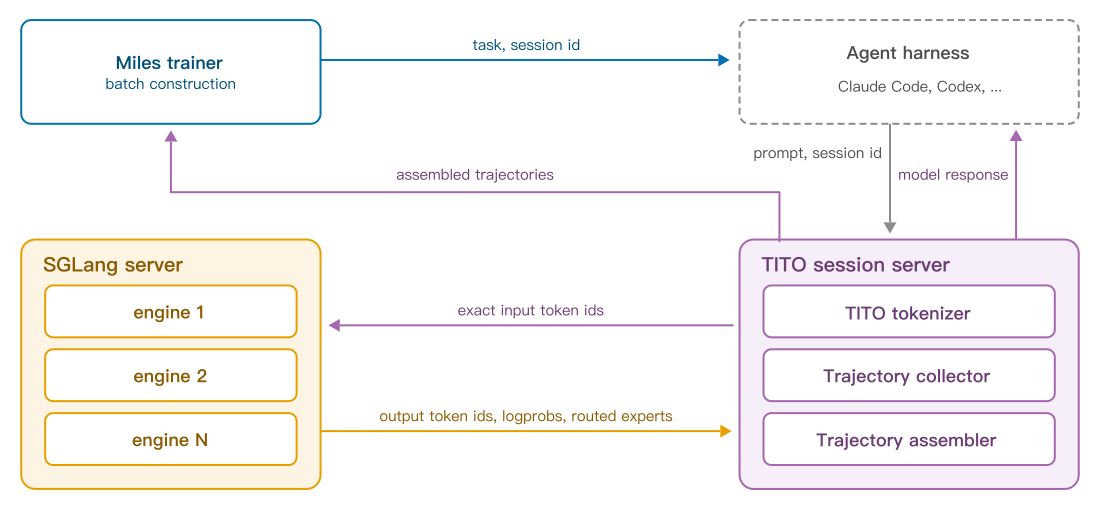
TITO 怎么做。TITO 让 session 服务端(位于智能体和 rollout 引擎 SGLang 之间)对 token 说了算。智能体每一轮仍然发送普通消息和完整历史,但这些消息只负责描述对话内容、帮助服务端找到可以复用的部分。用一次两轮工具调用来看整个流程:
- 第 1 轮。服务端根据初始消息 $M_1$ 完整渲染一次聊天模板,得到 $P_1$,把这些 ID 发给 SGLang。SGLang 采样出 $O_1$,并返回每个 output ID 及其 log-prob。
- 提交。服务端保存 token checkpoint $C_1=P_1\Vert O_1$,也就是下一轮要接着延伸的完整快照;同时为这一轮保存一份请求和响应记录,供之后组装训练样本。
- 第 2 轮。智能体发来完整历史 $M_2$:第 1 轮的全部内容,加上一条工具结果。服务端把这段历史和已存的 checkpoint 逐一比对,选出最深的可用 checkpoint(这里是 $C_1$),以它的 token 前缀为准,只对新追加的消息(这里是工具结果)和下一个 assistant 开头标记分词。智能体重放的 assistant 文本只用来定位 $C_1$,绝不会拿来重建 $O_1$。
- 收集。SGLang 采样出 $O_2$ 后,服务端提交 $C_2=P_2\Vert O_2$。训练端直接从保存的记录里读取服务端生成的 prompt ID、精确的 output ID 和 rollout log-prob,不再对最终对话重新分词。
令 $S_2$ 为接在已匹配的第 1 轮历史之后、按顺序追加的消息。第二轮的 prompt 为
\[P_2=\operatorname{merge}\!\left(C_1,\Delta_\tau(S_2)\right),\]其中 $\Delta_\tau$ 只对追加的消息做渲染和分词,merge 负责执行模型系列特有的边界修补,比如补上缺失的换行,或处理重叠的 stop 分隔符。
说白了:$P_2$ 就是第 1 轮那一行原封不动的 token,后面接上一段新分词的后缀,merge 负责把接缝处理好。两个真实的接缝例子:
- Qwen3:模板在每条消息后写
<|im_end|>加一个换行,但模型在<|im_end|>处就停了,不会采样出那个换行。merge把它补上。 - GLM-4.7:
<|observation|>和<|user|>既是 assistant 的 stop token,又是下一条消息的开头标记。merge把已存 token 行末尾的这个 stop token 去掉,由下一条消息自己的开头标记充当边界,保证边界只出现一次。
实现细节
论文把 checkpoint 和逐轮证据放在一起描述,源码则把它们拆成两个结构:
- Token checkpoint:完整快照 $C_t=P_t\Vert O_t$,供下一轮延伸。
SessionRecord:补全了各项参数的最终请求(input_ids中即 $P_t$)以及 SGLang 的原始响应。响应里有 output ID 与 log-prob 的配对(output_token_logprobs),配置启用时还有 routed experts 数据。训练样本由这些记录组装而成。
边界规则写在 TITO 分词器各模型系列的子类里(miles/utils/chat_template_utils/tito_tokenizer.py 中的 merge_tokens);基类只做简单拼接。

组装训练样本。训练端消费的正是 serving 时构建的那一行 token。以上面的两轮为例,组装出的样本如下:
| 片段 | 来源 | Loss mask |
|---|---|---|
| 原始 prompt $P_1$ | 智能体的初始消息 $M_1$,经模板渲染 | 作为上下文,不是预测目标 |
| $O_1$ | 策略采样 | 1 |
| 工具结果和下一个 assistant 开头标记 | 环境与模板 | 0 |
| $O_2$ | 策略采样 | 1 |
组装时,Miles 把每一轮的 output ID 与累计 checkpoint 对齐,只移除已注册的边界重叠(比如上面 GLM 的 stop token)。后续的用户消息和其他环境文本也和工具结果一样,loss mask 为 0。训练端因此拿到一条连续、逐 token 精确的序列:rollout log-prob 和 loss mask 索引的是完全相同的一批 token,训练端也不会把环境文本当成策略的输出。
实现细节
组装逻辑在 miles/rollout/session/samples/merge.py。对每条记录,它从请求中读取 input_ids,从 output_token_logprobs 读取 output ID,再把 output ID 与累计 checkpoint 贪心匹配。匹配不上的尾部 token 就是被下一轮模板吸收掉的那部分。它们的数量不能超过该模型系列注册的上限(GLM-4.7 为 1 个 token,最后一轮为 0),超出时组装会直接报错。
共享生成的归属在 sample picker 丢弃叶节点之后才计算,因此被丢弃的叶节点不会成为某段生成的归属者。
智能体不能改写 token。既然 token 行归服务端所有,智能体就不能自己提供 token ID,也不能提供指向这些 token 的偏移量。这样的请求会直接报错,而不是被悄悄修正。训练需要的采集选项(log-prob、元信息,以及运行配置开启重放时的路由数据)也由服务端自行设定,不管智能体请求了什么。
实现细节
当前服务端把拒绝和强制采集分开处理(miles/rollout/session/request_args.py):
- 返回 HTTP 400:客户端为
input_ids或logprob_start_len传入非空值;在训练 session 路径上,routed_experts_start_len同样如此。 - 由服务端强制设置:
logprobs=true、return_meta_info=true、no_stop_trim=false。路由和 indexer 的采集开关由运行配置推导。
论文把这两种情况概括为“智能体提供的 token 字段会被覆盖”;而在源码中,真正被覆盖的只有采集开关。
内置诊断。Miles 仍可以按聊天模板的标准方式把完整消息渲染一遍,与服务端持有的 token 行做比较,结果记为 tito_session_mismatch。这条标准分词结果永远不会替代 serving 或训练所用的序列。诊断结果这样看:
- Assistant 文本有差异是预期现象,恰好说明 TITO 保留了采样出的 ID,而没有用模板偏好的分词方式。
- Special token 或非 assistant 文本有差异,则说明聊天模板或边界 merge 出了问题。
不只是分词问题。后面有三个机制要按 token 索引数据,只有 rollout 端和训练端在同一位置上是同一个 token 时才正确。R3(第 4.1 节)需要每个 token 的专家路由;OPD(第 8.1 节)需要学生模型逐 token 的 log-prob;true-on-policy 模式(第 4.3 节)要求 rollout 引擎和训练端比较相同的 token。三者都依赖 TITO 保存下来的轨迹。
线性与分支式 session。session 存下的历史有两种增长方式,选哪种决定了一个 session 能产出几条训练序列:
- 线性(Linear):每个请求只能从末尾继续扩展。智能体可以回滚一个 assistant checkpoint 来重试最近一轮;更早处分叉的请求会被拒绝。一个线性 session 恰好产出一条训练序列。
- 分支式(Branching):历史保存为一棵仅追加的树,每个保留下来的叶节点都可以成为一条轨迹。这适合 Claude Code 这类在任务中途派生 sub-agent 或压缩上下文的编程 harness。这类 harness 事先不知道一个 session 会产出几条轨迹,线性规则无法支持它们。如果多个叶节点共享更早的一段生成,这段生成只在最早保留下来的叶节点上保持 loss mask 为 1,因此只贡献一次梯度,而不是多次。
实现细节
分支模式下,服务端把每个请求挂到“消息路径是该请求前缀”的最深 checkpoint 上;没匹配上的剩余部分开出一个新分支,分支永不删除。如果某个分支的最后一次生成因达到长度上限而停止,这个分支就不能再延伸。线性模式的回滚深度固定为一个 assistant 轮次(linear_trajectory.py 中的 MAX_ASSISTANT_ROLLBACK_STEPS = 1)。
怎样才算历史匹配。复用已存前缀之前,服务端会把每条重放的消息和该位置已存的消息做比较。消息匹配器决定这个比较有多严格:
strict是安全的默认选项。loose_tool_call只放宽工具调用参数在 JSON 序列化上的差异。role_content_only忽略工具调用,因而可能把不同的执行路径错误地合并。
最后一种设置为什么危险?工具调用那一轮的可见文本往往是空的,于是在 role_content_only 下,两次调用了不同工具的 assistant 轮次看起来完全一样。已存前缀胜出,训练端保留的历史里就出现了一次智能体从未发起过的调用。复用绝不能以削弱正确性检查为代价。
实现细节
匹配器通过 --session-message-matcher 选择(默认 strict),也接受指向自定义匹配器的可信 dotted import 路径。strict 只比较聊天模板会读取的字段:role、content、reasoning content 和 tool calls。loose_tool_call 仍要求调用 ID、函数名和顺序一致。role_content_only 把两段历史合并时,Miles 不会核对工具调用 ID,所以这种不一致不会有任何提示。
当前限制。TITO 仍然是一份与具体模型相关的契约。每个已注册的模型系列都有 CPU 测试,检查聊天模板是否满足 append-only(渲染更长的历史时,只会在较短历史的 token 之后追加,绝不改动已有 token),另外还有针对真实 GPU 推理的校验;通用 handler 只能尽力而为。session 路径目前也还不能承载图像或视频输入。
实现细节
模型系列指共享同一个聊天模板、同一对 reasoning 与工具调用 parser 的一组 checkpoint。Miles 从不根据 checkpoint 自动识别系列,而是由用户在启动时指定(--tito-model)。已注册的系列覆盖 Qwen3、GLM、Nemotron、Kimi、MiniMax、DeepSeek 和 Inkling,其他 checkpoint 会回退到通用 handler 并给出警告。只有 CPU 测试是不够的:模板单独看可能满足 append-only,一旦真实 parser 消费模型输出就可能出错。视觉-语言模型不经过 session 服务端,而是通过 SGLang 更底层的 token-in、token-out 接口直接驱动 rollout。
顺带的吞吐收益。session 有效后,同一个 session key 会把它的所有轮次固定在同一个 SGLang 引擎上;启用 DP attention 时,还会进一步固定到同一个数据并行(DP)rank。这个引擎的 KV cache(之前 token 在注意力层中的 key 和 value 缓存)里已经有对话前缀,所以每一轮只需 prefill 新增的后缀,而不必反复 prefill 完整历史。
4. R3、TIS 与 True-on-Policy:三个不同层面的答案
TITO 保证训练端打分的 token 正是 rollout 采样出来的那些。这是必要条件,但还不够:训练端仍可能给同样的 token 算出不同的概率。Miles 在三个层面处理剩下的差距:
- R3 让训练端把每个 token 送进 rollout 当时用过的同一组 MoE 专家。
- TIS 与 clip-or-pop 承认数值差距依然存在,只限制它能把梯度推偏多远。
- True-on-policy 模式让采样 token 的 log-prob 完全一致,但只适用于很少的几个模型。
4.1 R3 固定离散的 MoE 路由
在 MoE 模型里,每个 MoE 层的 router 会给所有专家打分,只保留得分最高的 $k$ 个。这个选择是离散的,分数上的一点点差异就可能换掉胜出的专家。R3 把 rollout 选中的专家记下来,让训练端直接复用,而不是重新选一遍。
看一个具体例子。假设 rollout 为某个 token 选择了专家 {2, 7},而几 bit 的浮点误差让训练端选成了 {2, 8}。于是专家 8 因为一个它从未参与生成的 token 收到了梯度,真正参与生成的专家 7 反而没有梯度。
这种误差会跨层、跨 token、跨训练步累积。每次更新得到的策略又会去采样下一批数据,偏差因此回灌到训练里。R3 论文报告,这类路由不一致会让 MoE 模型的 RL 训练严重不稳定,甚至直接崩溃。
形式化地说,对于 MoE 第 $j$ 层,令 $g_{j,t}$ 表示 token $t$ 的 router score。Rollout 会计算一个整数专家集合
\[A^{\mathrm{roll}}_{j,t} =\operatorname{TopK}\!\left(g^{\mathrm{roll}}_{j,t},k\right).\]R3 把这些 ID 序列化下来,替换训练端重新计算的 top-k 结果:
\[A^{\mathrm{train}}_{j,t}\leftarrow A^{\mathrm{roll}}_{j,t}.\]说白了:rollout 记下“token $t$、第 $j$ 层 → 专家 2 和 7”,训练端前向时直接用这份名单,不再自己做 top-k。

R3 固定的是专家成员关系,而不是整个路由计算。训练端仍会在重放的索引位置取自己算出的 router score,每个专家内部的算术也仍可能不同。所以 R3 既不保证 gate weight 相同,也不保证最终的 log-prob 相同;剩下的数值差异可能仍需要 TIS 或 true-on-policy 模式来处理。
实现细节
- 通过
--use-rollout-routing-replay开启 R3。SGLang 会在返回生成 token 的同时返回路由到的专家,训练端在前向时重放它们。 - TITO 的 session 服务端会把路由专家和 token ID、log-prob 一起记录下来,因此重放覆盖整段多轮 episode,而不只是单次 completion。
- 由于被替换的只有最后一步 top-k 选择,router 依然可导,照样能收到梯度。
重放本身很便宜,搬运却很贵。原始 payload 大小为
B_R3 = (tokens - 1) × layers × top-k × sizeof(int32)
当序列包含 32K token、模型有 60 层且 top-k=8 时,每条轨迹大约需要 60 MiB,这还不包括外围的序列化开销。这份数据要一直留在内存里,跟着轨迹一起传输,大小随序列长度增长,偏偏智能体 RL 的序列又特别长。
因此,是否启用 R3 应由每个 MoE recipe 自己权衡决定:
- 稠密模型没有专家路由,R3 对它们没有作用。
- 全异步训练还会引入其他差异,例如权重陈旧,这可能限制 R3 的边际收益。
- Miles 自带的若干 MoE recipe 开启了 R3。本文后面的 GLM-5.2 案例则关闭了 R3,用 TIS 控制剩余的不一致。
4.2 TIS 与 Clip-or-Pop 限制剩余的策略比率不一致
即使 token 相同、专家也相同,两个引擎算出的概率仍会有细微差别。Miles 在这一层不去消除差距,而是逐个采样 token 测量它,并限制离群 token 对更新的影响。
差距有两个来源。即便权重相同,SGLang 和 Megatron 也会因为内核、精度和 batching 方式不同而算出不同的 log-prob。同版本同步执行时,下面这个比率衡量的主要就是这种数值差异;全异步执行时,它还可能包含陈旧的 rollout 权重与训练端当前更新前权重之间的时间漂移。
这里有必要把这个系统层面的比率和优化器本身的比率分开。对于历史 $h_t$ 下采样的 token $x_t$,有三个概率:
- $\mu$:rollout 采样该 token 时记录的行为概率;
- $\bar\pi$:训练端更新前的策略,在同样的 token 上重新计算;
- $\pi_\theta$:本步正在优化的策略。
直观地说,$\rho_t$ 就是熟悉的 PPO/GRPO 比率,$m_t$ 是叠加在它上面的系统修正。在目标函数自身的 clipping 之前,$\rho_t m_t=\pi_\theta/\mu$,也就是拿当前策略直接和真正生成该 token 的策略相比。
Miles 先算出 policy loss,再把每个 token 的 loss 乘上以下两种不一致权重之一,其中 $l$、$u$ 是区间上下界:
\[w_t^{\mathrm{TIS}}=\operatorname{clip}(m_t,l,u), \qquad w_t^{\mathrm{pop}}=m_t\,\mathbf 1[l\le m_t\le u].\]- TIS 压低离群值的影响力,但该 token 仍参与梯度。
- Clip-or-pop 让区间内的比率原样通过,区间外的 token 权重置 0,从梯度中移除。

用默认区间 [0, 2] 举个小例子。假设 rollout 采样某个 token 时的概率是 0.20:
| 训练端概率 $\bar\pi$ | $m_t$ | TIS 权重 | Clip-or-pop 权重 |
|---|---|---|---|
| 0.30 | 1.5 | 1.5 | 1.5 |
| 0.60 | 3.0 | 2.0(截断) | 0(丢弃) |
| 0.02 | 0.1 | 0.1 | 0.1 |
比率总是正的,所以下界取 0 时只有上尾会受影响。两种方法都以偏差换取更低的方差,都不能让两个引擎变得一致。
Miles 会报告未裁剪的比率、被裁剪的比例和平均 |m_t-1|。先看清这个分布再决定怎么处理离群值,比只盯着平均 loss 更能说明问题。
实现细节
--use-tis打开修正。区间由--tis-clip-low(默认 0)和--tis-clip(默认 2.0)决定。- 内置的修正是 TIS。要用 clip-or-pop,需要把
--custom-tis-function-path指向icepop_function(它是一个自定义 correction,而不是独立的顶层模式)。 - 权重乘在目标函数自身 clipping 之后的逐 token policy loss 上。
- 两个函数记录同样的三个指标
tis、tis_clipfrac和tis_abs,因此用不同修正的运行可以直接对比。
4.3 True-on-Policy 试图消除差异
TIS 只是给差距造成的影响重新加权;true-on-policy 模式则直接处理差距的成因:让 rollout 和训练执行同样的计算,使两个引擎在支持的配置下对每个采样 token 算出完全相同的 log-prob。对外提供的 launcher 把它做成一个 --true-on-policy 开关,展开后是一份跨引擎的内核契约:
| 数值漂移来源 | 对齐规则 |
|---|---|
| Attention | Rollout 与训练使用相同的 FlashAttention-3 路径 |
| GEMM(通用矩阵乘法)与 batch 形状 | 使用 batch-invariant 内核 |
| 融合算子 | 禁用或替换无法匹配的 fused RoPE 和 bias-SwiGLU 路径 |
| 运行时非确定性 | 固定 cuBLAS、Transformer Engine、NCCL(NVIDIA 的 GPU 通信库)和 SGLang 的确定性设置 |
| 张量并行(TP) | 在需要时使用 TP-invariant row-parallel layer 与 reduction |
| Decode 与 prefill 打分 | 通过一次 prefill pass 对完整序列重新打分 |
其中 batch invariance 值得多说一句:rollout 引擎组 batch 的方式和训练端完全不同,所以矩阵乘法的结果不能依赖同一个 batch 里有多少请求。
上表六条规则全部到位后,在支持的配置下,Miles 报告的两个引擎之间的 log-prob 绝对差恰好为零。
这个结果很强,但适用范围很窄,而且这些限制会影响你该怎么用它:
- 模型覆盖。论文和当前源代码只为稠密 Qwen3 0.6B/4B 系列注册了 profile。对其他模型,Miles 会直接拒绝启动 true-on-policy 运行,而不是带着打折扣的保证跑下去。
- 相等的是什么。这项保证覆盖的是已采样 token 的 log-prob,而不是完整词表上的分布。
- 管不到的部分。它不处理旧权重带来的陈旧问题;这部分可以由第 5 节异步 buffer 的
--max-weight-staleness单独限制。 - 代价。确定性和 batch invariance 会放弃部分吞吐优化。在文档记录的 Qwen3-4B-Base 运行中,reward 曲线与基线吻合,但 rollout 耗时更长。
- 后端。论文描述了 Megatron 和 FSDP 两种集成,但在固定的源代码 revision 中,内置的 Megatron 参数路径暂时关闭,要等后续工作补齐。FSDP 才是能跑通的路径。
因此,最好把 true-on-policy 理解为一份范围很窄的严格内核契约和诊断工具。要用就有意识地打开,它不是所有生产负载都该默认开启的开关。
实现细节
- Launcher 开关对应训练端的
--true-on-policy-mode。在固定 revision 下,搭配--train-backend megatron会抛出NotImplementedError,并提示改用--train-backend fsdp。 - 论文称,已注册的 Qwen3 profile 在训练侧覆盖数据、张量、流水线和上下文并行。不过张量、流水线和上下文并行布局属于被关闭的 Megatron 路径;在这个 revision 下,能跑通的 FSDP 路径只支持数据并行。
5. 全异步:解耦带来吞吐,可观测性保障正确
同步循环里,生成和训练轮流进行,总有一边的 GPU 在空等。Miles 让两边在各自的 GPU 上同时运行。代价是训练端学习的数据来自稍旧的权重,所以 Miles 会度量数据有多旧、每一步都上报,并允许你给它设一个上限。
轮流执行为什么浪费 GPU。假设一个 batch 里大多数轨迹两分钟就跑完,但有一条智能体 episode 要跑二十分钟。先跑完的 rollout GPU 只能空等这条长尾轨迹,训练端也必须等 batch 凑齐才能开始。等训练端跑优化器时,又轮到 rollout 引擎空等。长上下文和工具调用类任务,每个 batch 都有很大一部分时间耗在这些空泡里。
Miles 怎样把两边解耦。使用 train_async.py 和 --fully-async 时,rollout 与训练分别跑在独立的 GPU 池上,中间用一个有界 buffer 连接。如果配置成训练端与 rollout 引擎共用 GPU 的 colocated 模式,Miles 会直接拒绝启动全异步训练。后台 worker 始终让固定数量的轨迹处于生成中,训练端需要 batch 时就从 buffer 里取已经完成的数据。
默认的补位规则按 sample 粒度工作:
- 每完成一条轨迹,就释放一个位置(一个“sample credit”)。
- 累计到
n_samples_per_prompt个 credit 后,worker 再提交一个完整的 prompt group。 - 训练端始终消费完整的 group,因为 GRPO 这类组内相对的目标函数需要整组数据来计算 advantage。
这样,即使轨迹长度相差一个数量级,在途轨迹数也能保持在预算附近。如果按 group 粒度补位,一条慢轨迹会让整组占用的位置一直空不出来,直到它结束。
实现细节
--rollout-submission-granularity可选sample或group;全异步模式默认sample。- 在途预算默认是
rollout_batch_size个 group;设置了--async-max-concurrent-samples时,改为该值除以n_samples_per_prompt后向下取整(该值不得小于n_samples_per_prompt)。 - buffer 最多容纳
floor(--async-data-buffer-capacity-factor × rollout_batch_size)个 group(系数默认 2.0)。buffer 满了以后,放入新 group 会阻塞,直到训练端取走一个。 --async-unused-samples-handler决定被中止或过于陈旧的 group 如何处理:drop(默认)直接丢弃,retry把 prompt 退回去重新生成。缺少 reward 或被用户过滤器拒绝的 group 一律丢弃。- 权重更新时在途请求的处理方式由
--pause-generation-mode决定(默认retract,也可选in_place)。全异步模式不接受abort:生成一刻不停,若选abort,每次权重更新都会把所有在途生成全部杀掉。 - buffer 只暴露
put、get和一个指标接口,因此可以通过 import 路径(--custom-async-data-buffer-path)换成自己的选择器。
仍然需要等待的地方。全异步并不等于“什么都不用等”。安装新权重仍会暂停 rollout;如果评估与 rollout 共用引擎,评估也会暂停新的生成。默认情况下,权重更新时仍在途的请求会先被撤回(retract),再在新权重上继续生成,所以一条长轨迹里可能混有两个甚至更多策略版本生成的 token。异步执行换来的是主要计算阶段的重叠,代价则体现为陈旧度(staleness):
staleness = current published rollout/engine version - oldest token version in the group
取组内最旧 token 的版本,是刻意保守的做法:一个 group 永远不会被当成比它最旧的 token 更新鲜。失败、超时和用户自定义过滤器在 put 时检查,因为 group 一旦生成完,这些结论就不会再变;陈旧度则在 get 时检查,因为数据在队列里等待期间还会继续变旧。
度量“旧”的三种方式。一条长轨迹本身就可能横跨多个发布给 rollout 的权重版本,只用一个数字会丢掉有用的信息。令 $v_{\min}$ 和 $v_{\max}$ 分别表示 group $G$ 中生成 token span 所带的最旧和最新权重版本,$v_c$ 表示训练端消费该 group 时当前已发布的 rollout 版本。Miles 可以区分:
\[S_{\mathrm{old}}=v_c-v_{\min},\qquad S_{\mathrm{post}}=v_c-v_{\max},\qquad \Delta_{\mathrm{gen}}=v_{\max}-v_{\min}.\]- $S_{\mathrm{old}}$ 是用于过滤的保守值。
- $S_{\mathrm{post}}$ 衡量最新 span 生成之后这个 group 又旧了多少,比如在队列里等待的那段时间。
- $\Delta_{\mathrm{gen}}$ 反映生成过程中发生了几次权重更新。
举个例子:一条轨迹前半段在版本 12 下解码,后半段在版本 13 下解码,被消费时当前版本是 14。于是 $S_{\mathrm{old}}=2$,$S_{\mathrm{post}}=1$,$\Delta_{\mathrm{gen}}=1$。直白地说:这个 group 最多落后两个版本,其中一个版本的滞后来自排队等待,另有一次更新发生在生成途中。

token 加权的陈旧度描述的是典型 token,而不只是最坏情况。它等于 $v_c$ 减去按 token 数加权的平均版本。如果上面那条轨迹有 300 个 token 来自版本 12、100 个来自版本 13,平均版本就是 12.25,token 加权陈旧度为 1.75。
两个容易忽略的细节。第一,--max-weight-staleness 默认不设置。有界队列能提供背压(队列满了 rollout 就得等),却不能保证数据新鲜度。配置了上限之后,只有在 get() 时 $S_{\mathrm{old}}$ 严格大于上限,group 才会被拒绝。以上面的例子来说,--max-weight-staleness 1 会拒绝这个 group,上限设为 2 则会放行。
第二,这里的单位是已发布的 rollout 权重版本,未必是 optimizer step;通常只有在 --update-weights-interval=1 时两者才一一对应。没有版本来源信息的 span 不计入陈旧度统计;一个 group 如果完全没有带版本的 token,也永远不会因为陈旧而被拒绝。所以 weight_version_sample_coverage 同样值得关注。
看懂队列。最有用的诊断指标往往就是 queue_size:
- 长期接近零:瓶颈在 rollout,训练端在等数据。
- 长期顶在容量上限:瓶颈在训练端,排队的数据越来越旧。
stale_groups_filtered突增:生成算力正在产出永远不会被训练用到的数据。
这些队列计数器和前面的陈旧度指标结合起来,就把“异步更快”变成了一个可以检查的运行状态:能看出瓶颈在哪个阶段,也能看出训练数据有多新鲜。
实现细节
所有 buffer 指标都在每个训练 step 上报,前缀为 rollout/fully_async/。
| 指标 | 含义 |
|---|---|
avg_staleness、max_staleness |
本 step 消费的 group 的 $S_{\mathrm{old}}$ |
avg_post_generation_staleness、max_post_generation_staleness |
本 step 消费的 group 的 $S_{\mathrm{post}}$ |
avg_generation_version_span、max_generation_version_span |
本 step 消费的 group 的 $\Delta_{\mathrm{gen}}$ |
token_weighted_staleness |
本 step 消费的 group 的 token 加权陈旧度 |
weight_version_sample_coverage |
本 step 消费的 sample 中带有版本来源信息的比例 |
buffer_avg_staleness、buffer_max_staleness |
仍在等待的 group 的 $S_{\mathrm{old}}$ |
queue_size |
buffer 中等待的 group 数 |
aborted_groups_filtered、stale_groups_filtered |
因生成被中止而在 put 时丢弃的 group 数,以及因超过上限而在 get 时丢弃的 group 数 |
论文的指标表包含 queue_size、各项 $S_{\mathrm{old}}$ 指标和两个丢弃计数;生成后陈旧度、版本跨度、token 加权陈旧度和覆盖率这几项只在源码中出现。
异步评估。评估遵循同一原则。Miles 可以复用 rollout 引擎、使用专用 GPU 集群,或者把任务交给外部 backend。每个返回的分数都归属到被评估权重对应的 step,延迟另行记录,所以晚了好几个 step 才回来的分数也会记在正确的 step 上。专用集群还会校验每个引擎的权重版本,防止一个分数悄悄混合了多个 checkpoint。
6. 低精度不是一种 Dtype,而是一份四阶段契约
低精度数值格式能加速矩阵乘法:精度每减半,GPU tensor core 的峰值算力大约翻一倍。RL 里的风险在于,训练端和 rollout 引擎可能按不同规则量化同一份权重。这样一来,两边从同一个 checkpoint 算出的是不同的策略,差异逐层累积,一项为了省显存、提速度而做的改动,最终变成了梯度里的训推不一致。所以 Miles 把精度当作一份契约,所有接触权重的阶段都必须遵守。
先统一几个术语。Dtype(data type,数据类型)指 tensor 存储时采用的数值格式。BF16(bfloat16)是标准的 16 位浮点训练格式,这里作为基线。FP8 和 FP4 分别是 8 位和 4 位浮点格式,NVIDIA 分别从 Hopper 和 Blackwell 开始提供硬件支持。分块(block)格式为每一块数值共享一个缩放因子(scale),从而扩大窄格式能表示的数值范围。
四个阶段。契约覆盖权重被转换或使用的每一个环节:
- Checkpoint 转换。
- 训练端 forward pass。
- 在线权重导出:每次权重更新时,把训练端的权重转换成 rollout 引擎的格式。
- SGLang rollout。
端到端的 MXFP8 与 NVFP4 recipe 共享一个 bit-exact 的 quantizer,所以训练和 rollout 的内核看到的量化值完全相同。少数 tensor 保留 BF16,因为它们的收缩轴(contraction axis)对不齐一维的缩放块。论文点名的有最后几层 transformer、共享专家,以及多头潜在注意力(multi-head latent attention)中的投影。在这些 recipe 中,配置的 BF16 tensor 和 layer 例外必须在四个阶段保持一致;只在某一个阶段生效的覆盖设置会破坏契约。
| 格式 | Block 大小 / scale 格式 | 成熟度 | 论文中的硬件范围 | 论文中测试过的模型 |
|---|---|---|---|---|
| BF16 | — | 基线 | A100 及更新的 NVIDIA GPU;受支持的 AMD GPU | 全部 |
| FP8 blockwise | 128×128 / FP32 | GA(正式可用) | Hopper、Blackwell、MI350X/MI355X | Qwen3-4B、Qwen3-30B-A3B、DeepSeek-V4 |
| MXFP8 | 1×32 / UE8M0 | Beta | Blackwell | Qwen3-30B-A3B、DeepSeek-V3.2 |
| NVFP4 (E2M1) | 1×16 / E4M3 + per-tensor FP32 | Beta | Blackwell | Qwen3-30B-A3B |
怎么读 block 这一列:MXFP8 让连续 32 个 FP8(E4M3)值共享一个 UE8M0 scale(只有 8 位指数,所以是 2 的幂),E4M3 指 4 位指数、3 位尾数。NVFP4 给每 16 个 4 位值(E2M1,即 2 位指数、1 位尾数)配一个 E4M3 scale,这些 scale 外面再套一个 per-tensor 的 FP32 scale。
实现细节
- MXFP8 在 rollout、forward pass 以及权重梯度和数据梯度两类 GEMM 中都保持这一格式,配置的例外保留 BF16。
- NVFP4 按 token 缩放激活值,使量化误差不受 batch 组成的影响。Miles 把 gate 和 up 投影放在一起量化,这样 rollout 中融合后的 GEMM 只用一个外层权重 scale。recipe 未覆盖的 tensor 保留 BF16,rollout 使用 BF16 KV cache。
- NVFP4 还有两项可选改进,通过环境变量而不是命令行 flag 开启。Dequantized backward:把 forward 用过的 NVFP4 值反量化回 BF16,再用它们做 backward GEMM;只影响训练端。Four-over-six 对每个 block 的最大值分别尝试 4 和 6 两个 FP4 幅值,保留误差更小的那个;由于它会改变量化值本身,训练端的 Transformer Engine 内核和 SGLang 的 FlashInfer 内核都要同时开启。
哪些组合可行。通常有效的组合,要么是“训练端与 rollout 使用相同格式”,要么是“BF16 训练搭配量化 rollout”。NVFP4 是例外:所有接触权重的阶段都必须对其量化,因此不支持 BF16 训练端 + NVFP4 rollout。
除了表中的格式,论文还提到 INT4 量化感知训练,以及一种“BF16 训练、FP8 serving”模式;新架构刚接入时,这种模式更容易跑起来。论文中的 GLM-5.2 案例用的正是这种更实用的组合:BF16 训练,搭配 FP8 serving 权重和 KV cache。
如何验证一套 recipe。真正可复用的经验,与其说是某一行配置,不如说是这套验证顺序:
- 共享 quantizer。
- 对齐例外 tensor。
- 逐 tensor 校验权重更新。
- 在相同的已采样 token 上比较 log-prob。
- 在线监控重要性比率。
论文用第 4 步验证这些 recipe,两个引擎分别是 SGLang 和 Megatron-LM。在目前测过的配置上,reward 曲线与 BF16 基线贴得很近,rollout 时间也明显缩短。同样的量化换到别的模型上可能表现不同,而且 MXFP8 和 NVFP4 仍处于 Beta 阶段。
7. 内存与权重同步:让 1T 模型真正跑起来
到了万亿参数规模,一次训练能不能跑起来、跑得动,取决于两个工程问题。第一,训练状态比 GPU 显存还大。第二,每个训练 step 之后,新权重必须足够快地送到一整批 rollout GPU 上,不能让生成停下来干等。第 7.1 节讲内存,第 7.2 节讲权重传输。
7.1 两种卸载,对应两种时间尺度
GPU 的高带宽显存(HBM)要装下模型权重、梯度和优化器状态。装不下时,就得把一部分状态放到别处。Miles 在两种时间尺度上把状态移出 GPU:训练 step 之间,以及单个 step 之内。
- step 之间:
--offload-train。训练 actor(持有模型、梯度和优化器状态的训练进程)暂停期间,它的权重、梯度 buffer 和优化器状态一起离开 GPU,把显存让给其他进程,比如 rollout 引擎。Megatron 可以卸载到 CPU 内存或本地磁盘;FSDP 目前只支持主机内存。 - step 之内:
--stream-optimizer-state-to-disk。前向和反向传播都不读优化器状态,所以 Miles 把它留在磁盘上,等到优化器更新时才按 bucket 逐个加载并更新。
优化器状态通常是最大的一块。FP32 master weight 每个参数占 4 字节,Adam 的两个矩估计各占 4 字节,合计约每参数 12 字节。对 1T 参数的模型来说,仅优化器状态就约 12 TB。超大模型即使分片之后也可能装不进 HBM;GLM-5.2 训练中,每个 rank 要从本地磁盘流式读取约 279 GB。
两种机制还可以叠加使用。论文报告,在 Qwen3-30B-A3B 上启用流式优化器后,actor 卸载时间从 24 s 降到 5.2 s,重新加载时间从 8.9 s 降到 1.3 s,原因是已经在磁盘上的状态在 actor 被换出时不必再搬一次。代价是 checkpoint 保存变慢,而且恢复时必须保持相同的并行布局。
实现细节
- 卸载的默认值取决于部署方式。colocated(同卡部署,rollout 引擎与训练端共用 GPU)时,
--offload-train默认开启;disaggregated(分离部署,两者各用一批 GPU)时默认关闭。带 critic 的 PPO 也默认换出 actor,因为 Miles 总是把 actor 和 critic 放在同一批 GPU 上。 - Megatron 在显存分配器层面卸载,权重、梯度和优化器状态作为一整块移动。走磁盘路径时,它通过固定大小的锁页 staging buffer 流式写出,主机内存占用有上界。
- 开启流式的训练无法从未开启流式时写下的 checkpoint 恢复;Miles 会直接拒绝恢复,而不是悄悄让 Adam 从第 0 步重新开始。Miles 会把流式状态同步复制到 checkpoint 目录,所以保存更慢。
7.2 权重传输:只准备一次,再按拓扑搬运
每个训练 step 之后,训练端都要把一个完整的新策略版本交给所有 rollout 引擎,它们才能用新权重生成。训练端和 rollout 不在同一批 GPU 上时,这次交接可能占掉 step 的大头:在下文的测量里,广播 1T 参数的 Kimi K2 要将近一分钟。
一次权重更新包含两项不同的工作:
- 准备:从训练端的分片布局中重新拼出可直接用于 serving 的 tensor。
- 搬运:把它们送到每个 rollout 引擎,保证大家看到的是同一个完整版本。
Miles 把这两项工作分开。在 Megatron 上,广播、P2P 和磁盘增量都消费同一批准备好的分桶,磁盘增量之后再走一套围绕存储设计的独立发布流程;FSDP 有一个单独的、更简单的广播 updater。训练端和 rollout 同卡部署时,交接通过 CUDA IPC(同一块 GPU 上的跨进程显存共享)在本地完成,不涉及任何网络传输。
下文会反复用到几个术语:
- 并行方式。TP 把每个权重矩阵切到多张 GPU 上;PP(流水线并行)把层切成若干 stage;EP(专家并行)让每张 GPU 持有 MoE 层中不同的一部分专家;ETP(专家张量并行)再把单个专家切开。
- 通信底座。广播走 NCCL。RDMA(远程直接内存访问)让一台机器直接写入另一台机器已注册的内存,不需要对端 CPU 参与。
- 格式。“HF”指 SGLang 所期望的 Hugging Face checkpoint 命名与布局。

7.2.1 共享的分桶流水线
大模型有成千上万个 tensor。Miles 不会每个 tensor 调用一次 rollout 引擎,而是把转换好的 tensor 装进限定大小的分桶(bucket),默认 512 MiB,桶满后整个交给选定的传输方式。
对于普通参数,每个 Megatron pipeline stage 会:
- all-gather 自己的 TP 分片,拼成完整 tensor;
- 把 Megatron 的命名和布局转换成 HF/SGLang 的表示;
- 追加到当前 bucket,桶满就 flush。
有些 tensor 必须一起走。权重和它的量化 scale 放在一起;SGLang 必须原子加载的模型特定参数组也放在同一个 bucket 里。
路由专家要单独再走一遍这条流水线,做自己的 ETP/EP gather,因为在 EP 下每个 rank 持有的是不同的专家,而不是同一个 tensor 的一片。Miles 在 EP gather 之前填充专家 bucket,gather 会把它的大小放大 EP 倍。EP = 8 时,gather 前看起来是 512 MiB 的 bucket,gather 后会变成 4 GiB。所以 Miles 在判断何时 flush 时,会把 gather 前的字节数乘以 EP 并行度,让 gather 后的 bucket 保持在名义大小附近。
各个 pipeline stage 拥有互不重叠的参数,各自独立准备,这正是流水线能扩展到很多 stage 的原因。不过仍有两处会让它们同步:阶段边界上的生命周期 barrier,以及广播在每次 flush bucket 时为保证 collective 顺序而持有的一把锁。在这些点上,一个慢 stage 会拖住其他所有 stage。
7.2.2 广播:简单、通用,规模大了就冗余
训练端和 rollout 用不同 GPU 时,默认的传输方式是广播(broadcast)。每个 pipeline stage 由一个训练 rank 把每个 bucket 发给所有 rollout GPU。
对每个 bucket,Miles 先通过控制通道发出 tensor 的名称、dtype 和 shape,再通过一个 NCCL group 广播数据本身(这个 group 包含该 stage 的发送方和所有 rollout rank),然后等待 collective 完成。
广播不需要为每个模型编写目标端的重新分片逻辑;训练端和 rollout 已经共享 NCCL 网络时,它效果很好。它的弱点在于扇出(fan-out):一张只持有八分之一专家的 rollout GPU,照样会收到全部专家。增加 rollout 副本只会增加流量,每个 pipeline stage 仍然只有一个发送方。
实现细节
每个 pipeline stage 有自己的 NCCL group,名为 miles-pp_{pp_rank},只有该 stage 中 DP = TP = 0 的 rank 负责广播。元数据走 HTTP。非专家参数和专家参数分开装桶。当 pipeline stage 多于一个时,一把全局的 ticket lock 让各次 bucket flush 串行执行,避免并发广播导致 NCCL 死锁。
7.2.3 P2P RDMA:只发送目标真正需要的分片
P2P 传输把“一个发送方、所有人都收”换成“多个发送方、每个目标只收自己那一片”。多个训练 rank 同时通过 RDMA 直接写入 rollout rank 的内存。gather、格式转换和分桶都和广播一样。
与拓扑相关的工作在初始化时一次做完:
- 传输计划。计划把 source 映射到 target。前
min(sources, targets)个分配是一对一的;其余 target 均匀分给各个 source,以限制每个发送方要维护的 RDMA session 数量。 - 目标元数据。每个 source 查询自己 target 的内存注册信息和并行布局元数据。
- CPU 副本。source 按照目标 rank 的布局,在 CPU 上构建一个 SGLang 模型副本。这个副本从不参与推理生成;它的
weight_loader就是 SGLang 分片与融合规则的可执行定义,发送方因此不必自己重新实现这些规则。 - 一块 staging buffer。一块可复用的锁页(pinned)主机内存注册到 RDMA 传输引擎上。所有 target 副本都复用它,因此 staging 内存保持恒定,不会随引擎数量增长。
更新时,转换好的 HF tensor 经过 CPU 副本,被严格按照 target 期望的方式重新分片。Q/K/V projection 这类融合参数会先暂存,等所有组成分片都到齐再处理。随后 source 发出批量 RDMA 写入;最后一组 target 的写入放到后台线程池执行,与下一个 bucket 的准备重叠。
扩展性分析能说明 P2P 什么时候占优。设 source rank 数量为 $M$,训练端 pipeline 深度为 $p$,rollout 的专家并行度为 $e$:P2P 能调用的聚合发送带宽约为广播的 $M/p$ 倍,而每个 MoE target 只接收本地专家,收到的数据约少 $e$ 倍。举例来说,64 个 source rank、$p=4$ 时,发送带宽约为 16 倍;$e=8$ 的 rollout GPU 只需接收约八分之一的专家字节。集群宽度和专家分片方式,比单纯的参数量更重要。
本文锁定的源码版本记录了一组比论文三行结果更广的 H100-80GB 测试。所有运行都用 1 GiB bucket,表中时间是稳定阶段第 3–12 步的平均值;变化为正表示 P2P 更慢。
| 模型 | 每侧节点数 | 广播 | P2P RDMA | 变化 |
|---|---|---|---|---|
| GLM-4.7-9B-Flash | 1 | 2.51 s | 4.23 s | +68.6% |
| GLM-5,4 层测试版 | 1 | 0.73 s | 1.26 s | +72.2% |
| Qwen3-30B-A3B | 2 | 2.67 s | 2.16 s | −19.1% |
| GLM-4.5-Air | 4 | 5.00 s | 2.64 s | −47.3% |
| Qwen3-235B-A22B | 8 | 10.75 s | 3.16 s | −70.6% |
| GLM-5 744B-A40B | 16 | 58.30 s | 8.48 s | −85.5% |
| Kimi K2 1T | 32 | 53.28 s | 7.23 s | −86.4% |
单节点时 P2P 更慢:一个节点拿不到额外的聚合带宽,P2P 却每次更新都要付出 CPU 重新分片和锁页内存 staging 的成本。从每侧两个节点起它开始占优;到每侧 16–32 个节点时,它能把接近一分钟的广播缩短到 7–8 秒。这些是传输窗口的测量,不是端到端训练加速,所以 P2P 仍应先 benchmark 再采用。
实现细节
- 论文表格收录的是 2、16、32 节点这三行。每一行中训练端和 rollout 的集群规模都相同。
- 计时从暂停生成的调用返回时开始,到更新调用退出时结束,不包含中止请求的时间。
- Kimi K2 的 checkpoint 每次传输后都要在 GPU 上重新量化一次(约 884 ms),这段时间也计入了它的 P2P 时间。
P2P 能覆盖的配置也更少。在 commit 3439ec751 中,它需要受支持的 Megatron-to-SGLang 权重映射,以及 rank 之间可以直接互通。启动时会拒绝同卡部署(colocation)、LoRA(低秩适配,见第 8 节)、Megatron Bridge(Megatron 直接加载 HF checkpoint 的组件,见第 8 节),以及 prefill–decode(PD)分离部署(prompt 的 prefill 和 token 的 decode 跑在不同服务器上)。rollout 的 pipeline 并行度不为 1 的情况尚未测试,同样会直接报错。
在这个 revision 里,部分失败的后台 RDMA 写入只会记日志,不会作为错误抛出,所以一次更新可能在某些 tensor 根本没送到的情况下照样完成。正因如此,在依赖 P2P 之前,先跑一遍预检 --check-weight-update-equal(见第 7.2.5 节)尤其重要。
实现细节
- 目前有权重映射的模型包括:Qwen2 与 Qwen3 稠密系列、Qwen3-MoE、GLM4-MoE 系列,以及 DeepSeek-V3/V3.2 的衍生模型(包括 GLM-5 和 Kimi K2)。
- 最后一组 target 的后台写入由一个等待步骤统一收尾;它捕获每个失败的 future 后只记日志,不会重新抛出。
7.2.4 磁盘增量:发布一个版本,而不是发送整个模型
磁盘增量(disk-delta)面向另一种边界:训练端和 rollout 无法共享 NCCL 或 RDMA 网络,但每台主机都能访问共享存储,并能在本地 NVMe 上保存一份完整 checkpoint。训练端不发送模型,只发布相对上一个版本变化了的字节,每台 rollout 主机再据此修补自己的本地副本。
差分针对的是规范化 checkpoint 的字节,而不是 $W_v-W_{v-1}$ 这样的 tensor 数值差。记 $B_v$ 为第 $v$ 版的 checkpoint 字节,$i$ 为字节位置:
\[D_v^{\mathrm{xor}}=B_v\oplus B_{v-1}, \qquad D_v^{\mathrm{overwrite}}=\{(i,B_v[i])\mid B_v[i]\ne B_{v-1}[i]\}.\]直白地说:某个字节从 0x3C 变成 0x3D,XOR 增量里存的是 0x01;所有没变的字节都变成 0x00,几乎可以压缩到零。overwrite 增量则只列出变化的位置和它们的新值。
它的生命周期带有明确的版本号:
- 快照(Snapshot)。第一次更新不发布增量,所以在这条路径上,SGLang 的起点是磁盘上的 checkpoint,而不是训练端推送的权重(即第 1 节提到的例外)。训练 rank 从同一份规范化的本地 HF checkpoint 读取字节基线,每台 rollout 主机也把这份 checkpoint 在本地物化为第 0 版,因此两边的基线逐字节相同。训练端还会按这份 checkpoint 的张量名、dtype、形状和字节大小检查自己导出的每个 tensor,任何不匹配都会让任务在训练开始前失败。增量从第二次更新才开始。
- 差分与压缩。之后的每次更新按规范化 HF 名称 gather tensor。CPU worker 把每个 tensor 与上一个快照逐字节比较,用 Zstandard 压缩变化的数据;没变的 tensor 不进入产物。
- 发布。每个
weight_vNNNNNN/版本都记录它依赖的 base、编码方式、压缩与 checksum 格式,以及 tensor 到分片的映射。数据分片里存放压缩后的变化,以及目标状态的摘要。 - 拉取与修补。每台 rollout 主机修补自己的本地完整 checkpoint,并校验版本谱系,以及修补后 tensor 的 checksum,而不只是校验传过来的增量。
- 重载与激活。只有修补成功后,Miles 才暂停生成、重新加载 SGLang、推进引擎的权重版本,然后恢复生成。
只有第 5 步会暂停生成。第 1–4 步都是 CPU 和存储上的工作,可以与生成重叠,所以最后的重载才是激活边界。
有两道保险,确保 rollout 不会读到不完整的版本。索引文件最后写:分片完成 flush、fsync 和原子 rename 之后才写它,所以它的出现就标志着一个完整版本。另外,如果两个 pipeline stage 发布了同一个被复制的 tensor、checksum 却不一致,发布会在任何引擎重载之前失败。
实现细节
- 用
--update-weight-transfer-mode=disk-delta选择磁盘增量。必需的 flag:--update-weight-disk-dir指向训练端和 rollout 共享的存储,--update-weight-local-checkpoint-dir指向 rollout 主机本地目录(例如 NVMe),--hf-checkpoint必须是本地目录,因为基线是从它的 safetensors 字节初始化的。 - 有变化的 rank 各自把变化写成一个
model-XXXXX-of-YYYYY.safetensors文件;rank 0 写model.safetensors.index.json,其中记录版本、base 版本、增量编码、压缩格式和 checksum 格式。
两种编码在体积和重试安全性之间取舍:
| 编码 | 存储的数据 | 重试属性 | 结果 |
|---|---|---|---|
xor(默认) |
new_bytes XOR old_bytes,再压缩 |
非幂等 | 必须且只能对声明的 base 应用一次;应用两次会恢复旧字节 |
overwrite |
变化的位置及其新的绝对值 | 幂等 | 产物更大,但可以安全重试 |
两者都是不看 dtype 的字节操作,因此 tensor 名称、dtype、shape 和字节布局必须与 base 完全一致。
磁盘增量目前只支持 Megatron,并要求本地 HF safetensors 基线、共享的发布存储,以及 rollout 端的本地 checkpoint 目录。它不支持同卡部署、LoRA、PD 分离部署和 hot restart。它的收益取决于实际变化的字节有多少、压缩效果如何,并不是每个 optimizer step 都一定产生很小的增量。部署时要关注 perf/update_weights_density(变化字节占比)和 perf/update_weights_wire_bytes(写出的字节数)。
7.2.5 如何选择传输方式
没有哪种传输方式在所有场景下都最好,关键看训练端和 rollout 共用的是 GPU、高速 GPU 网络,还是只有共享存储。
| 部署方式 | 推荐路径 | 原因 |
|---|---|---|
| 训练端与 rollout 共用 GPU | 同卡模式下使用 CUDA IPC | 不需要网络传输 |
| 单节点上的独立 GPU,或规模适中的共享 NCCL 网络 | 广播 | 配置和主机 staging 开销最低;覆盖面最广 |
| 具备直接 RDMA 且有受支持映射的大规模多节点集群 | 先对 P2P 做 benchmark | 多发送方和按目标分片的收益可能超过 staging 开销 |
| 没有公共 GPU 网络,但有共享存储和 rollout 本地 NVMe | 磁盘增量 | 发布压缩后的变化字节,并可在生成继续时提前准备 |
| FSDP、远程 LoRA 或 PD 分离部署的 rollout | 当前实现中使用广播 | P2P 和磁盘增量不是这些配置的通用路径 |
无论选哪种传输,改变的都只是同步成本,策略语义不受影响。更新更快可以缩小训练端与 rollout 之间的版本差距,但正确性仍然要求激活一个完整的版本,并在每段模型生成的 token 上记录这个版本。一条长轨迹完全可能横跨多次发布。
为了抓住悄悄漏写 tensor 的传输,Miles 提供了一个可选的运行前检查 --check-weight-update-equal。第一次更新之前,它先用随机数据填满 rollout 端的 tensor;同步之后,再把每个预期的 tensor 与训练端的副本逐一比较。没写到的 tensor 会留着随机噪声,不可能因为旧值碰巧相同而蒙混过关。
实现细节
这项检查只在训练开始时运行一次,并且只在 Miles 自己的持续集成(CI)测试中自动开启。它默认要求逐位完全相等;也可以改为容许量化往返带来的舍入误差,容差由量化格式推导得出。只存在于 rollout 端的 tensor(例如推理专用的 KV cache scale)会被跳过。
8. 两种训练器,以及 RL 之外的 Recipe
Miles 把 rollout 引擎、训练端和权重更新路径都做成可复用的共享组件,不只为 RL 服务。这带来两个结果:一是训练后端(training backend,在 GPU 上持有并切分模型的那一层)可以替换,循环的其余部分不用动;二是同一套组件可以重新组合,跑全参数 RL 以外的后训练任务。
Miles 提供两种训练后端:NVIDIA Megatron-LM 和 PyTorch FSDP,两者都能从 HF checkpoint 起步。两者的 rollout、loss 和权重更新接口完全相同,选哪个取决于模型和规模:
| Megatron-LM | FSDP | |
|---|---|---|
| 并行方式 | TP × PP × CP × EP × ETP,加上 DP | replicate × shard(HSDP) |
| 模型输入 | Megatron distributed checkpoint,或通过 Bridge 直接加载 HF | 直接读取 HF 目录 |
| 磁盘卸载 | 支持 | 不支持 |
| LoRA | 支持,并提供经过验证的 recipe | 当前不支持 |
| 最适用场景 | 超大 MoE、复杂并行、多节点生产工作负载 | 快速接入新的 HF 架构;中小规模实验 |
Megatron-LM 是默认后端;跨多节点的大型 MoE 运行需要的正是它的五个模型并行轴(CP 指上下文并行)。FSDP 放弃这些轴,只做数据并行维度上的分片,换来的好处是能原样加载 HF 目录,不需要转换步骤,也不用写架构参数。
实现细节
- 用一个启动参数
--train-backend选择megatron(默认)或fsdp。 - HSDP(hybrid sharded data parallel,混合分片数据并行)在组间复制模型、在组内分片,也就是表中的“replicate × shard”。
- Megatron-LM 同样不需要离线转换:Megatron Bridge 可以直接读取 HF 目录。Megatron checkpoint 写出后与并行方式无关,之后改并行布局也无需重新转换。
- FSDP 一列中的“不支持”指当前的 FSDP 后端 还没实现该功能,不代表 FSDP 这种技术本身做不到。
同一套组件还能组合成其他后训练任务,各自按需复用其中的部分组件:
- SFT(监督微调):没有在线 rollout 引擎。数据流水线直接生成 token ID 和只覆盖 assistant 回复的 loss mask,同时复用训练器、并行机制和 checkpoint 设施。
- LoRA RL:LoRA 冻结基础模型,只学习一个由低秩矩阵组成的小 adapter;Miles 只训练和同步这个 adapter。同卡部署通过 CUDA IPC 传递;分离部署使用 NCCL。实验性的 multi-LoRA 支持让多个 adapter 共享同一个基础模型,目前只支持分离部署的 rollout。
- Miles-Diffusion:把相同的 generate → train → update 结构扩展到图像和视频扩散,其中一条轨迹就是一条完整的去噪路径。
8.1 OPD:在学生模型真正访问的状态上提供密集教师反馈
传统蒸馏让学生模型在教师写好的文本上训练。可这些文本学生自己很少写得出来,推理时它一旦偏离,就会进入教师从未示范过的状态。On-Policy 蒸馏把角色反过来:由学生模型写回复,再由更强的教师模型给其中每个 token 打分。这样学生在自己的状态分布上学习,而且每个回复 token 都能拿到信号,不必等到结尾才拿到一个奖励。
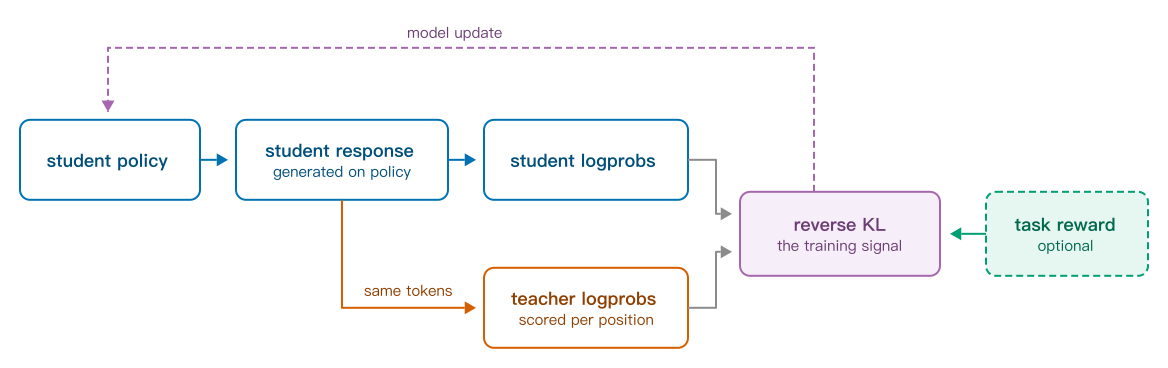
具体来说,教师只打分、不生成。它读取学生实际产生的前缀和 token ID,给出自己选中每个 token 的可能性。
令 $h_t=(x,y_{<t})$、$p_t=\pi_{\mathrm{old}}(\cdot\mid h_t)$、$q_t=\pi_T(\cdot\mid h_t)$。如果学生打分方(scorer)与行为策略一致,即 $y_t\sim p_t$,sampled-token OPD 记录
\[\hat d_t=\log p_t(y_t)-\log q_t(y_t), \qquad \mathbb E_{y_t\sim p_t}[\hat d_t]=D_{\mathrm{KL}}(p_t\Vert q_t).\]用白话说:对学生实际选中的 token,比较旧学生和教师各自有多“意外”。举个例子:学生给这个 token 的概率是 0.6,教师给的是 0.2,则 $\hat d_t=\log 0.6-\log 0.2\approx 1.10$;两个数对调,$\hat d_t\approx -1.10$。
正负号说明谁更偏爱这个 token(为正是学生,为负是教师)。所以单个 $\hat d_t$ 可以是负数,尽管它的期望是 KL 散度、永远非负。由于学生分布是第一个参数,这是反向 KL。
这个期望等式只在 token 真的采样自 $p_t$ 时成立,也就是 rollout 分布 $\mu$ 等于 $p_t$。数值不一致或异步陈旧都可能破坏这一条件;TIS 可以限制行为策略比率,却不能让二者重新相等。

Miles 没有另加一个蒸馏 loss,而是把教师信号折算进 advantage。它先用 GRPO、PPO、GSPO(Group Sequence Policy Optimization,组序列策略优化)或其他估计器算出常规的 token advantage,再应用
\[A_t^{\mathrm{train}}=A_t^{\mathrm{task}}-\beta_{\mathrm{OPD}}\hat d_t.\]log-ratio 为正,该 token 的 advantage 下降;为负则上升。沿用上面的例子,取 $\beta_{\mathrm{OPD}}=1$:被学生高估的 token,advantage 减少约 1.10;教师更偏爱的 token,advantage 增加约 1.10。
旧学生与教师的分数都是 detach 过的输入,梯度仍然只经过常规的 policy loss,不存在第二个可微的教师 loss。任务奖励是可选的:设为零就是纯蒸馏,保留则是以任务奖励为基础的 OPD。
实现细节
--use-opd开启 OPD,并要求同时设置--opd-type(sglang或megatron,见下表)。--opd-kl-coef就是 $\beta_{\mathrm{OPD}}$,默认 1.0。- 这一步在所配置的 advantage 估计器之后、advantage 归一化之前执行;因此开启
--normalize-advantages时,OPD 项会和任务 advantage 一起归一化。 - 在 sampled-token 路径上,“旧学生” log-prob 默认取训练端重算的值,开启
--use-rollout-logprobs时取 rollout 引擎记录的值;top-K OPD 的这一项在 rollout 阶段就已算好。 - OPD 要求逐 token 的 advantage;advantage、学生 log-prob 与教师 log-prob 之间长度或形状不一致时会直接报错。
教师放在哪里,决定了分数何时到达。外部 SGLang 教师在处理 rollout 样本时打分,分数随轨迹一起送到训练端;进程内 Megatron 教师则在训练 step 内额外执行一次 forward pass。
| 教师部署方式 | 打分时机 | 优势 | 限制 |
|---|---|---|---|
| 外部 SGLang 教师 | Rollout 处理期间 | 可使用不同或大得多的架构;支持 top-K 和基于 metadata 路由的教师 | 必须与学生共享完全相同的 tokenizer/token-ID 映射;需要额外的 scoring service |
| 进程内 Megatron 教师 | 训练期间额外执行一次 forward pass | 无需外部教师服务 | 需要兼容的 Megatron 架构/checkpoint;占用额外训练器内存;只支持 sampled-token 路径 |
tokenizer 的限制来自设计本身:教师给学生的 token ID 打分,所以两个模型必须把同一个 ID 映射到同一段字符串。
实现细节
--opd-type=sglang把样本发往--rm-url上的教师。--opd-type=megatron从--opd-teacher-load加载教师 checkpoint;该参数在这一模式下必填,在 SGLang 模式下设置则会被拒绝。- Top-K 打分(
--opd-log-prob-top-k> 0)和多教师路由(--opd-teacher-urls)只接受--opd-type=sglang。
当 $\mu=p_t$ 时,sampled-token OPD 在每个位置上都是无偏但噪声较大的一次采样反向 KL 估计:整个词表里它只看了一个 token。Served-teacher 路径(即外部 SGLang 教师)可以多看几个:它选一个候选集 $C_t$(学生 top-K、教师 top-K、交集、并集或对称差),并计算
\[\widetilde d_t^{(K)}= \sum_{v\in C_t}w_t(v) \left[\log p_t(v)-\log q_t(v)\right].\]权重可以取学生概率、教师概率,或者均匀分配。例如选学生 top-5、按学生概率加权时,每个位置都在学生最可能的 5 个 token 上比较两个模型,学生越偏爱的 token 权重越大。
这样用更多打分和传输开销换来更密集的监督,但 $C_t$ 之外的概率质量仍被忽略,所以它只是在选定支撑集上的近似(selected-support approximation),算不上精确的全词表 KL。在固定的源代码 revision 中,默认的基于 class 的 rollout 路径只支持教师 top-K 策略;其余策略需要已弃用的 v1 rollout 路径(见下方说明)。
实现细节
--opd-log-prob-top-k设定 $K$;取 0(默认)即 sampled-token OPD。--opd-top-k-strategy选择 $C_t$:only-student、only-teacher、intersection、union或xor(对称差),默认only-student。--opd-reward-weight-mode选择 $w_t$:student_p(默认)、teacher_p或none(均匀)。权重会在 $C_t$ 内重新归一化,xor例外:权重不归一化(直接用原始概率;none模式下每个 token 权重为 1)。- 基于 class 的 rollout 路径只支持
only-teacher。需要学生 top-logprob 的策略(包括默认的only-student)必须设置MILES_USE_LEGACY_ROLLOUT_V1=1,否则启动时参数校验就会失败。
多教师 OPD 是路由,不是 ensemble。每个样本 metadata 里的一个标签恰好选中一个教师,于是数学专家可以给数学 prompt 打分,代码专家给代码 prompt 打分。如果样本找不到匹配的路由,也没有配置默认教师,Miles 会直接失败,而不是悄悄选错教师。
实现细节
--opd-teacher-urls 接受 NAME=URL 形式的条目;--opd-teacher-key(默认 opd_teacher)指定存放教师名的 metadata 字段。保留名 default 兜底处理教师名缺失或未知的样本。格式错误或重名的条目会在启动时报错。
论文中的自蒸馏(self-distillation)结果很有价值,但适用范围有限。研究者先用五步 RLVR(基于可验证奖励的 RL)得到一个 Qwen3.5-35B-A3B 教师;学生从基础 checkpoint 重新开始,以零任务奖励训练五步,所以教师信号是唯一的训练信号。
在 DAPO 数学数据集中留出的 prompt 上,平均回复长度从 14,070 降至 6,132 token,减少 56.4%;准确率则从 84.0% 变为 85.2%。约 1.6 个百分点的标准误大于 1.2 个百分点的变化,因此证据支持的结论是“回复显著缩短,准确率没有可靠变化”,而不是准确率提升。而且这只是单次有记录的实验结果。
最后,OPD 和 true-on-policy(第 4.3 节)说的“on-policy”不是一回事:
- OPD 是算法意义上的 on-policy:学生自己生成用来训练的状态。
- True-on-policy 是数值层面的系统契约:rollout 与训练端必须在 sampled-token log-prob 上保持一致。OPD 并不保证这种数值一致。
9. GLM-5.2 744B:在 64 张 GB300 上的端到端案例
前面各节一次只考察一种机制。真正的生产训练要把它们同时打开:精确的多轮 token、异步调度、低精度 rollout、训推不一致校正,以及超大模型的权重更新。这个案例要回答的是:这些部件放到 744B 规模上,还能不能协同工作?论文给出的答案来自一次运行:训练一个在终端里解题的编程智能体。
全异步≤128 条进行中开启 TIS关闭 R3BF16 训练FP8 rollout + KV cache
GLM-5.2 是 MoE 模型。“744B 总参数、A40B 激活”的意思是:模型总共有 7440 亿参数,但每个 token 只会经过其中约 400 亿。
这次运行是怎么搭起来的
任务。每条轨迹就是一个智能体在命令行里解一道 terminal-bench-2 题目。每道题跑在独立的 Daytona 沙箱里,沙箱由该题的官方镜像构建,episode 结束即删除;Miles 通过 OpenEnv 连接器访问这些沙箱。一个 episode 在 30 轮或 1 小时后结束,以先到者为准。最终由题目自带的测试脚本给整个会话打分。
预算。模型每次回复最多 8,192 个 token。65,536 token 的上限针对的是智能体的整个多轮会话,而不是单次回复。一个训练 batch 有 64 条轨迹:8 道题、每题 8 次尝试,这样 GRPO 就能把每次尝试和同一道题的另外 7 次尝试相比较。
循环。64 张 GPU 分布在 16 个 GB300 节点上,每节点 4 张。8 个节点负责生成,8 个节点负责训练。两边并行运转,生成只在安装新权重或跑评测时暂停:
- 生成。8 个 rollout 引擎,每个生成节点一个,部署 FP8 版本的模型,并使用 FP8 KV cache。session 服务端跨轮次保存每个智能体的精确 token(TITO,第 3 节)。同时最多有 128 条轨迹在进行中。
- 缓冲。完成的轨迹 group 在全异步 buffer 中等待(第 5 节),直到训练端取走 64 条组成一个 batch。第 1 步中在途 128 条的上限与这个 batch 大小分开设置。
- 学习。训练端以 BF16 保存权重(第 6 节),计算 GRPO advantage,并用 TIS 校正剩余的训推不一致(第 4.2 节)。R3 关闭。
- 刷新。训练端把新权重广播给 rollout 引擎(第 7.2 节)。此外每 10 个 step,运行会暂停生成,用同一批引擎在一个不重叠的留出任务集上做评测。

32 张 GPU 怎么装下 744B 的训练端。决定训练侧切分方式的是显存,而不是速度。张量、流水线和上下文并行(TP2 × PP4 × CP4)用满了 32 张训练 GPU,只剩下一个数据并行副本(DP=1)。EP8 不会增加 GPU:它只是把专家分配到同样这 32 个 rank 上,如果再乘一次 8,就会误以为需要 256 张 GPU。
DP=1 是有代价的。没有第二个副本来分摊,每个 rank 要独自持有自己那份完整的优化器状态,约 279 GB,超过了单张 GB300 的显存。因此这次运行把优化器状态流式写到节点本地磁盘(第 7.1 节)。这样做是为了装得下,不是为了提速。
rollout 侧。每个生成节点运行一个 4 卡引擎,开启 DP-attention(DP4):注意力层按数据并行运行,4 张 GPU 各自服务自己的请求;专家则切分到这 4 张 GPU 上。8 个这样的引擎合计提供 32 个推理 DP rank。每个引擎还启用了多 token 预测(MTP):一个小型草稿模型在每次前向中提出多个候选 token。
完整运行配置
| 项目 | 配置 |
|---|---|
| 模型 | GLM-5.2,744B 总参数 / A40B 激活参数 |
| 硬件 | 64 × NVIDIA GB300;32 张用于 rollout / 32 张用于训练 |
| 环境 | terminal-bench-2、OpenEnv,每个 episode 使用一个 Daytona 沙箱 |
| 训练并行 | TP2 / PP4 / CP4 / EP8 |
| Rollout | 8 个 DP-attention 引擎(DP4),启用 MTP |
| 精度 | BF16 训练;FP8 rollout 权重 + FP8 KV cache |
| 长度与 batch | 最长 65,536 token;64 条轨迹 = 8 个 prompt × 每个 8 次尝试 |
| Episode 上限 | 30 轮或 1 小时;每次回复最多 8,192 token |
| 调度 | 全异步;最多 128 条轨迹在进行中;开启 TIS,关闭 R3 |
| 优化器状态 | 流式写到节点本地磁盘(--stream-optimizer-state-to-disk) |
| 权重更新 | 广播(--update-weight-transfer-mode broadcast) |
其余并行度为什么这样选:
- TP2 而不是 TP1。在 TP1 下,加载 checkpoint 时单个 rank 光是非专家权重就会撑爆显存。
- CP4。上下文并行把每条训练序列切到 4 个 rank 上,每个 rank 大约只保存四分之一的激活。
- PP4,且切分不均匀。模型的 78 层按 18 / 20 / 20 / 20 切分。GLM-5.2 的稀疏注意力在层间共享索引,所以每个流水线 stage 都必须从一个自行计算索引的层开始。
复现这次运行的启动脚本在 examples/experimental/openenv/glm52_tbench2/。它通过 import 路径类 flag(--custom-agent-function-path、--custom-rm-path)接入终端智能体和 reward,也就是第 10 节介绍的扩展机制。
这次运行展示了什么
一次运行100 个 step单一任务分布
这次运行回答了三个系统问题,并对学习效果给出一点迹象。
- 装得下吗?装得下。上述并行切分加上第 7 节的显存机制,让 744B 的训练端只占一半集群,另一半留给生成。
- 一个 step 多快?中位时长约 263 秒(前 30 个测量 step),此前 step 0 预热耗时 1,042 秒。
- 生成和训练真的重叠了吗?是的。按样本粒度补位(第 5 节)意味着一条轨迹一结束就启动新的一条,所以全集群同时约有 90–100 个请求在生成。这个数低于 128 的上限,因为等待工具调用的轨迹会占着名额但不生成。后续每一轮都会回到已经持有其前缀的那个数据并行 rank(第 3 节),因此前缀缓存命中率保持在 96%。
数值健康度。divergence 指标比较每个采样 token 的两个 log-prob:rollout 引擎报告的那个,和训练端重新计算的那个。它在 100 个 step 内平均为 0.0369,结束时接近起始值,说明这个差距没有随训练变大。剩余的差距由 TIS 在每次更新中校正。
Reward。原始 reward 是每道题的测试脚本返回的分数,尚未经过 GRPO 的组内中心化。它的九步移动平均在 100 个 step 内从 0.438 升到 0.556,论文把它作为观察结果报告,而不是作为测得的提升。
10. 源代码揭示的 Miles 工程理念
论文讲的是系统打算怎么做,代码展示的是它实际怎么做。本节先给出一张阅读地图,从常见问题直接指向回答它的文件,再总结代码里反复出现的三种工程习惯。
与其逐个目录阅读代码库,不如从你想回答的问题开始:
- 同步与异步循环在哪里分叉?
train.py·train_async.py - 谁掌管精确的多轮 token?
rollout/session/ - 在哪里衡量队列年龄并执行过滤?
fully_async_data_buffer.py
- TIS 与 clip-or-pop 有何不同?
corrections.py - OPD 在哪里给样本打分、在哪里施加反向 KL?
on_policy_distillation.py·opd.py - True-on-policy 约束了什么?
true_on_policy/
- 广播、P2P 与 disk-delta 在哪里实现?
weight_update/ - 低精度权重在哪里转换?
megatron_to_hf/processors/
把这些文件对照着读,有三种工程习惯尤为突出:
Rollout、generation、agent、reward、loss、校正、数据源和 buffer 都可以注入。应用逻辑可以替换,不需要 fork 框架。
像“全异步 + 同卡部署”这样的无效组合,会在启动时直接报错,而不会悄悄改变语义继续运行。
一条训练曲线、一个确定性测试、一个缩小规模的代理实验和一次 smoke test,提供的支持力度各不相同。
可替换边界的实际样子。每个扩展点都是一个接收 Python import 路径的 flag:只有运行时指定了,你的代码才会被加载,Miles 内部一行都不用改。第 9 节的 GLM-5.2 运行就是这样做的:它的终端智能体和 reward 都只是在命令行里指定的普通函数。rollout 栈还被拆成 agent、generation 和 rollout 三层,某个环境只需替换自己需要的那一层,其余照常复用。
实现细节
固定版本中按边界划分的部分 import 路径类 flag:
| 边界 | Flag |
|---|---|
| Rollout | --rollout-function-path |
| Generation | --custom-generate-function-path |
| Agent | --custom-agent-function-path |
| Reward | --custom-rm-path |
| Loss | --custom-loss-function-path |
| 重要性比率校正 | --custom-tis-function-path |
| 数据源 | --data-source-path |
| 全异步 buffer | --custom-async-data-buffer-path |
尽早失败的实际样子。如果某个配置组合兑现不了它的承诺,运行会在启动时就停下。全异步要求训练端训练的同时,生成也不能停,所以 --fully-async 与 --colocate 同时出现会直接报错。本文前面也出现过同样的习惯:true-on-policy 拒绝未注册的模型(第 4.3 节);多教师 OPD 一旦遇到匹配不到教师路由、又没有默认教师的样本,就立即报错,而不是悄悄挑一个教师(第 8.1 节)。
证据等级的实际样子。Miles-Diffusion 给每个 recipe 标上四个等级之一,等级只对应具体的脚本和拓扑,而不是整个模型家族:
- Fully gated(完全门控):跑过完整训练曲线,并且有针对该 recipe 本身、至少每晚运行一次的确定性端到端测试,所有已登记指标都与提交的基准完全一致。
- Proxy gated(代理门控):同上,只是每晚的测试运行的是一个有文档说明、缩小到单节点的代理版本。
- Verified(已验证):跑过完整训练曲线,但没有满足上面任一标准的确定性测试。
- Not verified(未验证):没有跑过完整训练曲线;smoke test 和短时间的调试运行不算数。
第 9 节对 GLM-5.2 结果的处理也是同样的纪律:一次运行就按一次运行来报告。
实现细节
论文还说明了这些可读性规则如何落地。格式和 import 顺序检查以 pre-commit hook 的形式存在,CI 会在每个 pull request 上重新运行。另有几个 hook 直接禁止 Miles 特有的反模式,并指出应改用的 API;例如 ban-mpu-get 会拒绝直接调用 mpu.get_*,因为两个训练后端共享同一个 ParallelState 对象。CI 还会跨运行保存每个测试的训练指标,并用历史记录检验每个新数值,从而发现单次运行看不出来的 reward 或 divergence 的缓慢漂移。
11. 从正确基线走向规模化:四阶段采用路径
Miles 的开关很多,每个开关要么影响训练端学到的数据,要么影响训练跑得多快。如果一次打开好几个,reward 曲线出了问题,你就分不清该怪哪一个。更稳妥的做法分四个阶段走。每个阶段结束前先通过一项检查再往下走,这样每出现一个新问题,嫌疑对象都只有一个。

第 2 阶段里与你的模型无关的部分,直接跳过即可。
- 从小模型、BF16 和同步调度开始。
- 验证 reward、样本、逐 token log-prob 和第一次权重同步。
- 使用
strictmatcher 加入 TITO。 - 建议达到以下条件再进入下一阶段:同一批 token 上,rollout 与训练端的 log-prob 高度吻合,且同步后的权重与训练端副本一致(
--check-weight-update-equal,第 7.2.5 节)。
- 对于 MoE,测量 R3 是否值得付出路由数据的传输成本。
- 对于低精度,把转换 → 训练端 → 导出 → rollout 作为一条完整链路验证。
- 建议达到以下条件再进入下一阶段:训练端与 rollout 的 log-prob 不一致(即第 4.2 节的比率指标)足够小,并且在训练过程中保持平稳。
- 只有在同步路径稳定后才启用全异步。
- 把队列长度、陈旧度、丢弃率和版本覆盖率作为上线标准。
- 建议达到以下条件再进入下一阶段:这些指标保持稳定,队列也没有一直顶在容量上限(第 5 节)。
- rollout 在同一节点内使用独立 GPU 时,优先用广播(同卡部署时则走 CUDA IPC)。
- 在大规模多节点集群上对 P2P 做 benchmark。
- 跨集群、需要经由共享存储中转时,使用磁盘增量。
Miles v0.1 并没有宣称某一种传输方式、dtype 或优化器永远最好。它最有价值的习惯,是为每个选择都写清楚:适合什么拓扑、在什么条件下会失效、该观察哪些指标、怎样验证。在强化学习里,一个错误可能要到数百个 step 之后才显现。所以,测量、限制并校正 rollout 与训练之间的差异,比任何单个吞吐数字都更有价值。