2026 年 8 月 25 日,Z.ai 同一天在 Hugging Face 上为两个模型创建了仓库:GLM-5.3 和 GLM-5.3-Flash。从纸面参数看,两者像一对兄弟:词表都是 154,880 个 token,上下文窗口都是 1,048,576 个位置;都用一个形状相同的小打分器(闪电索引器,32 个头,每头 128 维)挑出最相关的 2,048 个历史 token;都是混合专家(MoE)模型,每个 token 经 sigmoid 门控(每个专家的得分各自压到 0–1 之间,而不是在所有专家间做 softmax)送往 8 个专家。
细看却分处设计空间的两端。GLM-5.3 的架构一点没变。 它的 config.json 与 GLM-5.2 相比,只多了 FP8(8 位浮点)打包信息(外加更新的 transformers_version);模型卡也写明它“与 GLM-5.2 使用同一个基座模型,所有提升都来自后训练”。GLM-5.3-Flash 则几乎全变了。 它从一个全新训练的基座出发:45 层线性注意力与稀疏注意力混合,注意力层里没有旋转位置编码,残差流拆成四路并行,还自带视觉编码器。
本文逐层拆解这两个模型。全部依据都是公开资料,每条结论都注明出处:
- 配置文件: GLM-4.7、GLM-4.7-Flash、GLM-5、GLM-5.1、GLM-5.2、GLM-5.3 和 GLM-5.3-Flash 的
config.json。 - 模型卡: GLM-5.2、GLM-5.3 和 GLM-5.3-Flash。
- 论文: GLM-5 技术报告(arXiv 2602.15763)和 IndexCache 论文(arXiv 2603.12201)。后者描述的跨层共享技巧,就是 GLM-5.2 发布时所说的“IndexShare”。
- 代码: Miles 中开源的 GLM-5.3-Flash 训练实现(PR #2786 与
docs/models/glm/glm5-3-flash.md),我们在 Miles v0.1 深度解析中介绍过这个框架。
GLM-5.3 没有技术报告。讲到旗舰模型怎么造出来时,我们借助 GLM-5 技术报告,并会明确说明。参数拆分、缓存大小等由我们根据配置自行计算的数字,一律标注“按配置推算”;对证据的解读,一律标注为“我们的理解”。
阅读本文需要知道什么是大语言模型(LLM)、注意力和 Transformer 层,其余概念会在用到时介绍。各节层层递进:
- §1: 家族全景:从 GLM-4.7 到 GLM-5.3-Flash 的历次发布,以及两个新模型的并排对比表。
- §2: 744B 旗舰,先逐层导览 GLM-5.3 的 78 层,看参数都在哪;§3–6 再逐个拆开各部件(3D 模型:层堆叠)。
- §3: 多头潜在注意力(MLA):每层为每个 token 只缓存一份 576 个数的摘要,而不是完整的键和值;以及让逐个生成新 token 依然便宜的技巧(3D 模型:MLA)。
- §4: MoE 层:256 个专家,每个 token 用 8 个(3D 模型:专家之城)。
- §5: DeepSeek 稀疏注意力(DSA):闪电索引器、在 MLA 缓存上做稀疏注意力、DSA 怎么训练,以及 IndexShare(3D 模型:索引器、单个 DSA 层、注意力地形图)。
- §6: 长上下文、多 token 预测(MTP)和 FP8。
- §7: 既然架构没变,GLM-5.3 的提升从哪里来。
- §8: GLM-5.3-Flash 的全新混合架构:Kimi Delta Attention(KDA),从线性注意力一路讲到分块训练和逐 token 解码;然后是不带位置编码的注意力、池化索引器,以及流形约束超连接(mHC)(3D 模型:KDA)。
- §9: 两个模型的显存与计算量并排估算。
- §10: 开源 Miles 实现中的训练细节。
- §11: 现有资料还回答不了的问题。
1. 家族全景
GLM-5.3 和 GLM-5.3-Flash 是近一年密集发布中的最新两款。本节先把它们放回时间线,再用一张表并排对比。一句话概括:GLM-5 到 GLM-5.3 一直沿用同一副 744B 骨架,Flash 则是全新设计。
1.1 从 GLM-4.7 到 GLM-5.3-Flash
下面的动图按配置文件梳理了这条演进线。日期取自 Hugging Face 仓库的创建日期。

| 模型 | 日期 | model_type |
总参数 / 激活参数 | 层数 | 注意力 | 路由专家(top-k) | 上下文 |
|---|---|---|---|---|---|---|---|
| GLM-4.7 | 2025-12-22 | glm4_moe |
资料未给出 | 92 | 分组查询注意力(GQA),96 个 query 头 / 8 个 KV 头 | 160(top-8) | 202,752 |
| GLM-4.7-Flash | 2026-01-19 | glm4_moe_lite |
30B / 3B | 47 | MLA | 64(top-4) | 202,752 |
| GLM-5 | 2026-02-11 | glm_moe_dsa |
744B / 40B | 78 + 1 MTP | MLA + DSA,每层都有索引器 | 256(top-8) | 202,752 |
| GLM-5.1 | 2026-04-03 | glm_moe_dsa |
744B / 40B | 78 + 1 MTP | 配置与 GLM-5 相同 | 256(top-8) | 202,752 |
| GLM-5.2 | 2026-06-16 | glm_moe_dsa |
744B / 40B | 78 + 1 MTP | MLA + DSA + IndexShare(78 层中 21 层运行索引器) | 256(top-8) | 1,048,576 |
| GLM-5.3 | 2026-08-25 | glm_moe_dsa |
与 GLM-5.2 同一基座 | 78 + 1 MTP | 配置与 GLM-5.2 相同 | 256(top-8) | 1,048,576 |
| GLM-5.3-Flash | 2026-08-25 | glm5_next |
320B / 18B | 45 + 1 MTP | 34 层 KDA + 11 层 DSA(混合) | 288(top-8) | 1,048,576 |
表中每个模型还各有 1 个共享专家,处理所有 token。从上往下读,真正的架构跳变有三次,其余几次发布都保持原样:
- GLM-4.7 → GLM-5。 GQA(96 个 query 头共用 8 组 KV 头)换成了 MLA + DSA,模型更浅,专家更多。在我们读过的配置里,30B 的 GLM-4.7-Flash 是最早采用 MLA 的模型。
- GLM-5 → GLM-5.1。 结构上没有任何变化,两份配置只差
transformers_version一个字段。 - GLM-5.1 → GLM-5.2。 1M token 的上下文窗口配上更大的旋转基数(§6)、IndexShare(§5.6)、fp32 路由器(§4),以及 GLM-5.2 模型卡所说的改进版 MTP 层,接受长度最多提高 20%。
- GLM-5.2 → GLM-5.3。 架构再次不变,只是改以 FP8 发布(§6.3);模型卡把全部提升归功于后训练。
- GLM-5.3-Flash。 另起一支:全新训练的 320B 基座,线性注意力与稀疏注意力混合,mHC 残差流,外加视觉编码器。按其模型卡的说法,它是 GLM-5 系列第一个原生多模态模型。
许可证也变了。GLM-5.2 和 GLM-5.3-Flash 采用 MIT 许可证;GLM-5.3 的模型卡写的是 license: other,名称为 glm-5.3,具体条款不在我们读到的资料里。
数字从哪来
- 层数、注意力类型、专家数和上下文长度都取自各模型的
config.json(num_hidden_layers、num_nextn_predict_layers、n_routed_experts、num_experts_per_tok、max_position_embeddings)。 - GLM-5 的 744B / 40B 来自 GLM-5 技术报告和 Miles 的模型索引页;Miles 文档对 GLM-5.1 和 GLM-5.2 给出同样的数字。GLM-4.7-Flash 的 30B / 3B 来自 Miles 文档,GLM-5.3-Flash 的 320B / 18B 来自其模型卡。GLM-4.7 的规模在我们读到的资料中没有给出。
- GLM-5.3 模型卡没有给参数量。它与 GLM-5.2 共用基座,因此沿用 GLM-5.2 的 744B / 40B;这是从模型卡推出来的,模型卡本身没写这个数。
- GLM-5 技术报告说模型有 80 层;而从 GLM-5 到 GLM-5.3 的所有配置都是 78 个解码层加 1 个 MTP 层。本文以配置为准。
- 配置键
head_dim在 GLM-5.2 中从 64 变成 192,但它可能对应的 MLA 维度都没变。我们把它当作元数据处理。
1.2 GLM-5.3 与 GLM-5.3-Flash 并排对比
两个新模型的词表、上下文长度、索引器形状和路由方式都一样,其余几乎全不相同:
| GLM-5.3 | GLM-5.3-Flash | |
|---|---|---|
| 基座模型 | 与 GLM-5.2 相同 | 全新训练 |
| 总参数 / 激活参数 | 744B / 40B(沿用 GLM-5.2 基座;官方数字出自 GLM-5 技术报告) | 320B / 18B(模型卡) |
| 解码层 | 78(+1 MTP) | 45(+1 MTP) |
| 隐藏维度 | 6,144 | 4,096 |
| 注意力层 | 78 × MLA + DSA | 34 × KDA + 11 × MLA + DSA,排布为 [KDA, KDA, KDA, DSA] × 11 + 1 层 KDA |
| MLA 的 query / KV 秩 | 2,048 / 512 | 1,536 / 512 |
| query/key 头维度 | 256 = 192 维无位置 + 64 维 RoPE | 256,全部无位置 |
| 位置编码 | RoPE,rope_theta 8,000,000 |
无(NoPE) |
| 索引器层 | 21 层计算、57 层复用(IndexShare) | 11 层,每 4 个 token 只给一个池化键打分 |
| 索引器头数 × 维度 / 保留键数 | 32 × 128 / 2,048 | 32 × 128 / 2,048 |
| 前馈层 | 3 层稠密(0–2)+ 75 层 MoE | 3 层稠密(0–2)+ 42 层 MoE |
| 每个 MoE 层的专家 | 256 个路由专家 + 1 个共享专家,top-8 | 288 个路由专家 + 1 个共享专家,top-8 |
| 残差流 | 一路标准残差 | mHC,4 路 |
| 视觉 | 无(纯文本) | 24 层视觉 Transformer(ViT) |
| 许可证 | other(glm-5.3) |
MIT |
表中有两个术语需要先解释一句,后文会详细展开。RoPE(旋转位置编码)通过旋转 query 和 key 向量的一部分维度,告诉注意力每个 token 所在的位置;NoPE 指完全不用位置编码。索引器的“计算层”和“复用层”就是 IndexShare 的分工:计算层自己挑出 2,048 个 token,复用层直接沿用前面最近一个计算层的结果。
数字从哪来
- 所有结构类的行都取自两份
config.json。Flash 的键位于text_config和vision_config之下;层的混合方式见layer_types(34 个linear_attention、11 个deepseek_sparse_attention),NoPE 一行对应qk_rope_head_dim: 0、mla_use_nope: true,且没有rope_theta。 - 索引器相关的行:GLM-5.3 的
indexer_types列出 21 个full层和 57 个shared层;Flash 的 45 项全部是full,另加index_kpool: 4。Flash 只有 11 个 DSA 层带注意力索引器。 - 两份配置都带有 FP8(e4m3,128 × 128 分块)的
quantization_config。 - 参数一行只引用公开数字(GLM-5 报告、Miles 文档、Flash 模型卡)。我们按配置重新统计的结果与之接近,但计数口径不同;推算过程见 §2 和 §8。
1.3 两条主线
后文按一个简单的分工展开。GLM-5.3 讲的是训练: 它的架构就是 GLM-5.2 的架构,所以 §2–6 先讲清这套继承来的 744B 设计,§7 再追问新模型的提升从何而来。GLM-5.3-Flash 讲的是架构: §8 拆解它的全新混合设计,§9 比较两种设计在长上下文下各要付出多少代价。
两条主线在一处交汇:两个模型都只在大约四分之一的层上运行索引器,但路径不同。GLM-5.3 靠共享做到(78 层中 21 层,按配置推算为 26.9%),Flash 靠层的排布做到(45 层中 11 层,24.4%)。
2. GLM-5.3 的 78 层导览
一个 token 穿过 GLM-5.3 时会经历什么?它要走过 78 层,每层形状相同:先是注意力块,再是前馈块。层与层之间只有两处差别,本节就来指出它们在哪。
2.1 一个 token 的路径
- 嵌入。 token 的 ID 从一张 154,880 × 6,144 的表里取出一行。从这里开始,token 变成一个 6,144 维的向量,即隐藏状态。
- 第 0–2 层。 每层先做带 DSA 选 token 的 MLA 注意力,再过一个稠密的 SwiGLU 前馈网络(FFN,一种带门控的 MLP),中间宽度 12,288。
- 第 3–77 层。 注意力相同,但前馈块换成 MoE 层:256 个路由专家加 1 个共享专家,每个 token 访问 8 个路由专家和这个共享专家。
- 输出。 先做最后一次归一化,再由输出投影(
lm_head)把 6,144 维映射成 154,880 个词表分数。这个投影不与嵌入表共享权重(untied)。 - MTP 层(编号 78)。 额外一整个解码层,为投机解码(先廉价起草,再由完整模型一次性校验)多起草一个 token,详见 §6。
78 层用的是同一套注意力设计。MLA 把每个 token 留给后续注意力的内容压缩成一个小的潜在向量(§3);DSA 再让每个 query 最多只读 2,048 个历史 token,由一个叫闪电索引器(lightning indexer)的廉价打分器挑选(§5)。
实现细节
- 稠密层与 MoE 层的划分来自配置中的
mlp_layer_types(3 个dense、75 个sparse),与first_k_dense_replace: 3一致;tie_word_embeddings为false。 - MTP 层在 FP8 配置列出的模块名里是
model.layers.78。它有自己的注意力、索引器和 MoE 路由器,另有名为eh_proj、enorm、hnorm和shared_head.norm的模块。我们的理解(参照这些名字所指向的 DeepSeek-V3 式结构):eh_proj把归一化后的嵌入与归一化后的隐藏状态拼接起来(2 × 6,144),再映射回 6,144 维;该层与主模型共用嵌入表和lm_head。
2.2 哪些层运行索引器
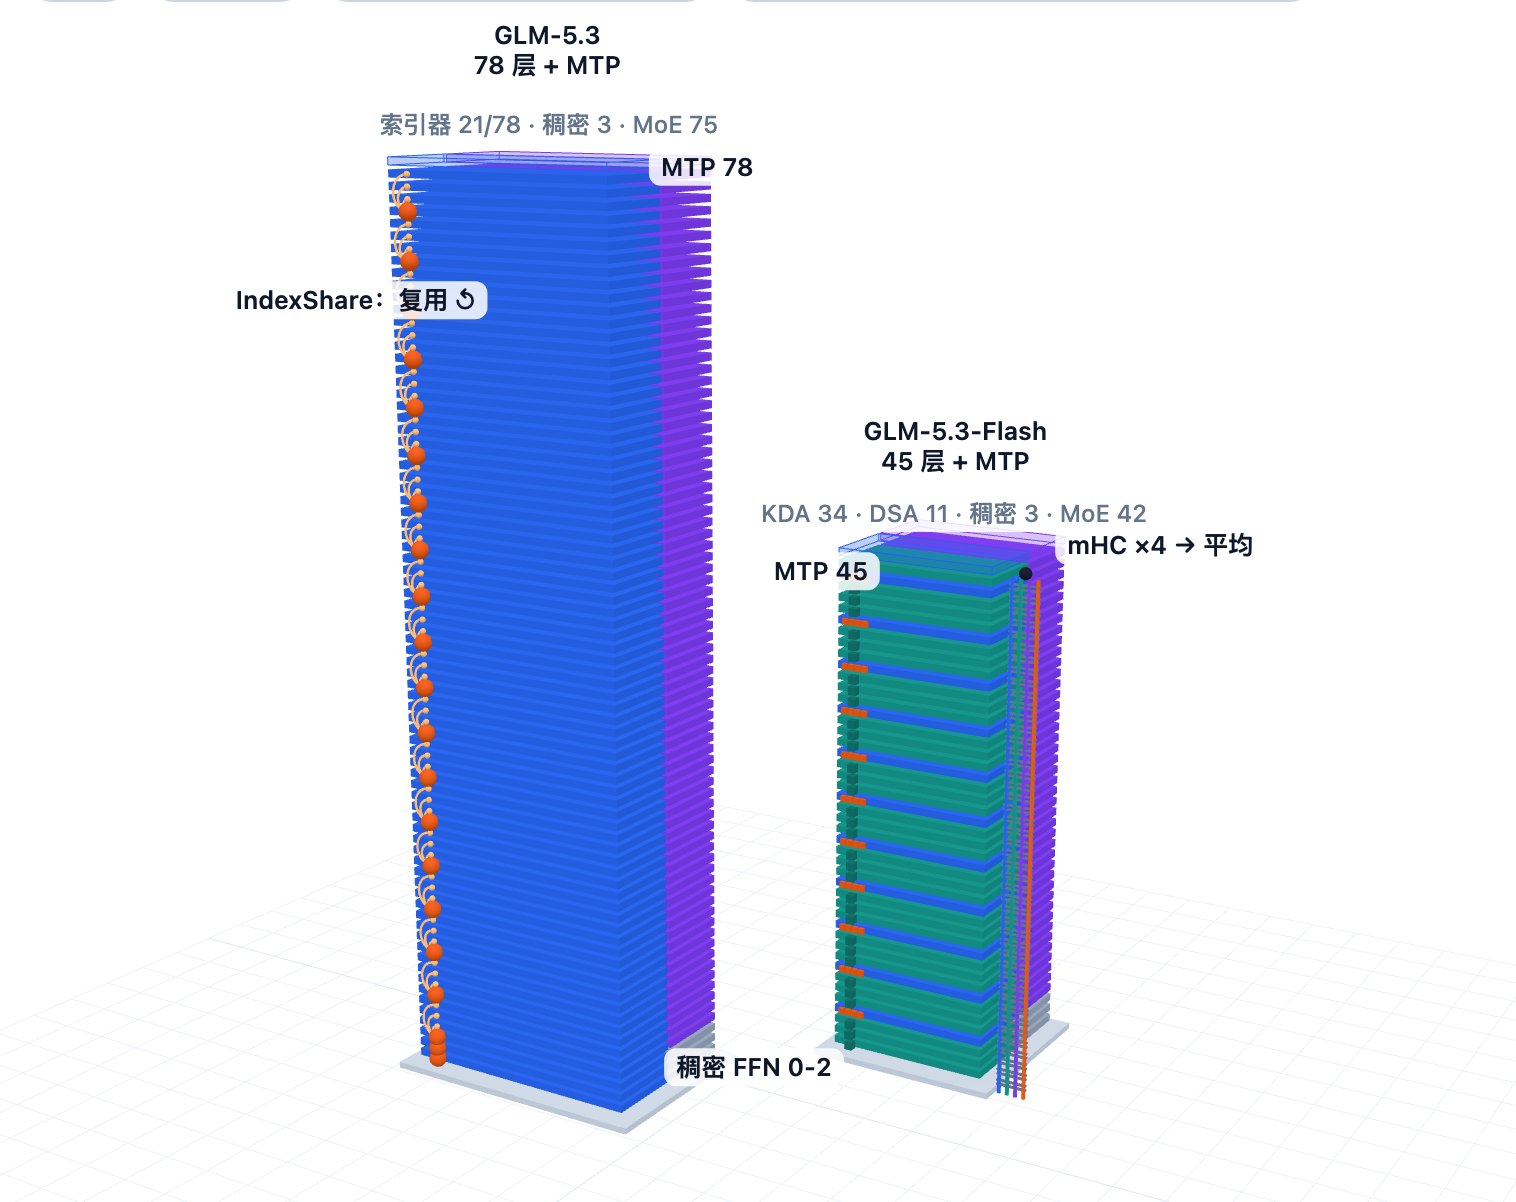
第一处差别在前馈块:第 0–2 层是稠密层,其余都是 MoE 层。第二处差别在索引器。GLM-5 和 GLM-5.1 每层都运行自己的索引器;从 GLM-5.2 起,78 层中只有 21 层这样做:
\[0,\ 1,\ 2,\ 6,\ 10,\ 14,\ \dots,\ 70,\ 74\]其余 57 层沿用前面最近一个索引器层的选择结果。前两层之后,规律稳定为四层一组:一层计算,三层复用。
\[\{0\},\ \{1\},\ \{2 \mid 3, 4, 5\},\ \{6 \mid 7, 8, 9\},\ \dots,\ \{74 \mid 75, 76, 77\}\]配置用两个数描述这条规律:偏移 3,频率 4。按上文的 0 起编号,第 $\ell$ 层运行自己的索引器,当且仅当
\[\ell \le 2 \quad\text{或}\quad (\ell - 2) \bmod 4 = 0 .\]所以第 6 层自己计算($6 - 2 = 4$),第 3 层不计算,沿用第 2 层挑出的 token。合起来是 2 个单独的层加 19 个四层组,共 21 个索引器层,73.1% 的索引器计算(78 次中的 57 次)就此省掉。为什么相邻层可以共用一份选择结果,§5 会解释。
实现细节
- 对应的配置键是
index_skip_topk_offset: 3和index_topk_freq: 4,外加显式的 78 项列表indexer_types(21 个full、57 个shared)。我们核对过,上面的公式能逐项复现这份列表。按配置自己的 1 起编号($L = \ell + 1$),规则写作 $\max(L - 3,\ 0) \bmod 4 = 0$。 - Miles 里同样的规则叫
is_skip_topk_layer(miles_plugins/models/glm5/glm5.py),注释说它对应glm-train-prod中的_get_skip_topk_flags。辅助函数source_compute_layer返回复用层所沿用的那个计算层。 - Miles 的 GLM-5.2 文档以 1 起编号列出计算层:1、2、3、7、11、…、75。
- 这里有个巧合:前三层既是全部的稠密层,也是开头的三个索引器层,两条规则的偏移都是 3。我们的理解是,这只是顺手的对齐;配置里两者分别设定(
first_k_dense_replace和index_skip_topk_offset),没有资料说它们相互绑定。
在下面的 3D 模型里,切换到只看 GLM-5.3,就能追踪索引器的分布规律;点按任意一层,可以查看它的层类型和按配置推算的参数量。
2.3 参数都在哪
GLM-5.3 几乎所有权重都在路由专家里,而任何一个 token 只用到其中一小部分。下表按配置推算;官方数字(GLM-5 技术报告)是总参数 744B、激活参数 40B。
| 组件(按配置推算) | 参数量 | 占 753.3B 的比例 |
|---|---|---|
| 路由专家(75 层 × 256 × 37.75M) | 724.8B | 96.2% |
| MLA 注意力(78 层 × 165.0M) | 12.9B | 1.7% |
| MTP 层 | 9.95B | 1.3% |
| 共享专家(75 × 37.75M) | 2.83B | 0.4% |
嵌入表 + lm_head |
1.90B | 0.3% |
| 稠密前馈(3 × 226.5M) | 0.68B | 0.09% |
| 闪电索引器(21 × 9.37M) | 0.197B | 0.03% |
| 路由器(75 层) | 0.118B | 0.02% |
| 全部(我们的统计) | 753.3B |
注意力加索引器还不到模型的 2%。§5 会讲到,索引器在长上下文预填充(一次性处理整段提示词的那一遍计算)中可能占掉大部分时间,但它只占权重的 0.03%。
激活参数是另一半故事。每个 MoE 层里,一个 token 只碰到 256 个路由专家中的 8 个,外加共享专家。按 GLM-5 技术报告的口径(计入 MTP,不计嵌入表和 lm_head),我们算出每个 token 激活 39.94B 参数,与官方的 40B 吻合。
为什么是 744B,而不是 753B?
GLM-5 技术报告(表 10)给出总参数 744B、激活 40B,并说明计入了 MTP 层,但不计词嵌入和输出层。我们的重新统计取决于口径:
| 口径(按配置推算) | 总参数 | 激活参数 |
|---|---|---|
| 我们统计的全部模块 | 753.3B | 41.84B |
GLM-5 报告口径:计入 MTP,不计嵌入与 lm_head |
751.4B | 39.94B |
计入嵌入与 lm_head,不计 MTP |
743.4B | 41.25B |
按报告自己的口径,激活参数对得上,总参数却比 744B 高出约 1%;最接近 744B 的反而是去掉 MTP 的口径。要么我们假设的张量形状与检查点略有出入,要么官方总数用的口径与文中所述不同。没有检查点的张量索引就无法定论,所以本文引用官方的 744B / 40B,把我们的数字视为误差约 1% 的复核。
我们的假设:MLA 与 MoE 层采用 DeepSeek-V3/V3.2 的模块形状;索引器形状与 Miles 一致(wq_b、wk、一个 LayerNorm、weights_proj);只有 21 个计算层和 MTP 层带索引器权重;共享专家与路由专家同样大小;除路由器的专家偏置外没有其他偏置。各归一化层(合计约 1M 参数)没有列入上表,但计入了总数。
3. MLA:只缓存 576 个数的摘要,不存完整的键和值
每生成一个 token,注意力层都可能回看之前的任何一个 token,所以模型要为每个 token 保留一份 KV cache(键值缓存)。上下文一长,显存主要就被它占满。MLA 由 DeepSeek-V2 论文提出,做法是:每个 token 在每层只存一个很短的压缩向量,需要时再从中还原各个头的键和值。在 GLM-5.3 里,这个向量只有 576 个数。
3.1 问题:每多一个 token,缓存就多一条
注意力像一次查表。最新的 token 生成一个查询(query),拿它和之前每个 token 的键(key)比对,再按得分把这些 token 的值(value)混合起来。历史 token 的键和值不会再变,与其每一步重算,不如存下来。这就是 KV cache:每个 token 每层一条,整段对话都要留着,每生成一个 token 都要再读一遍。
一条有多大?取决于注意力的设计:
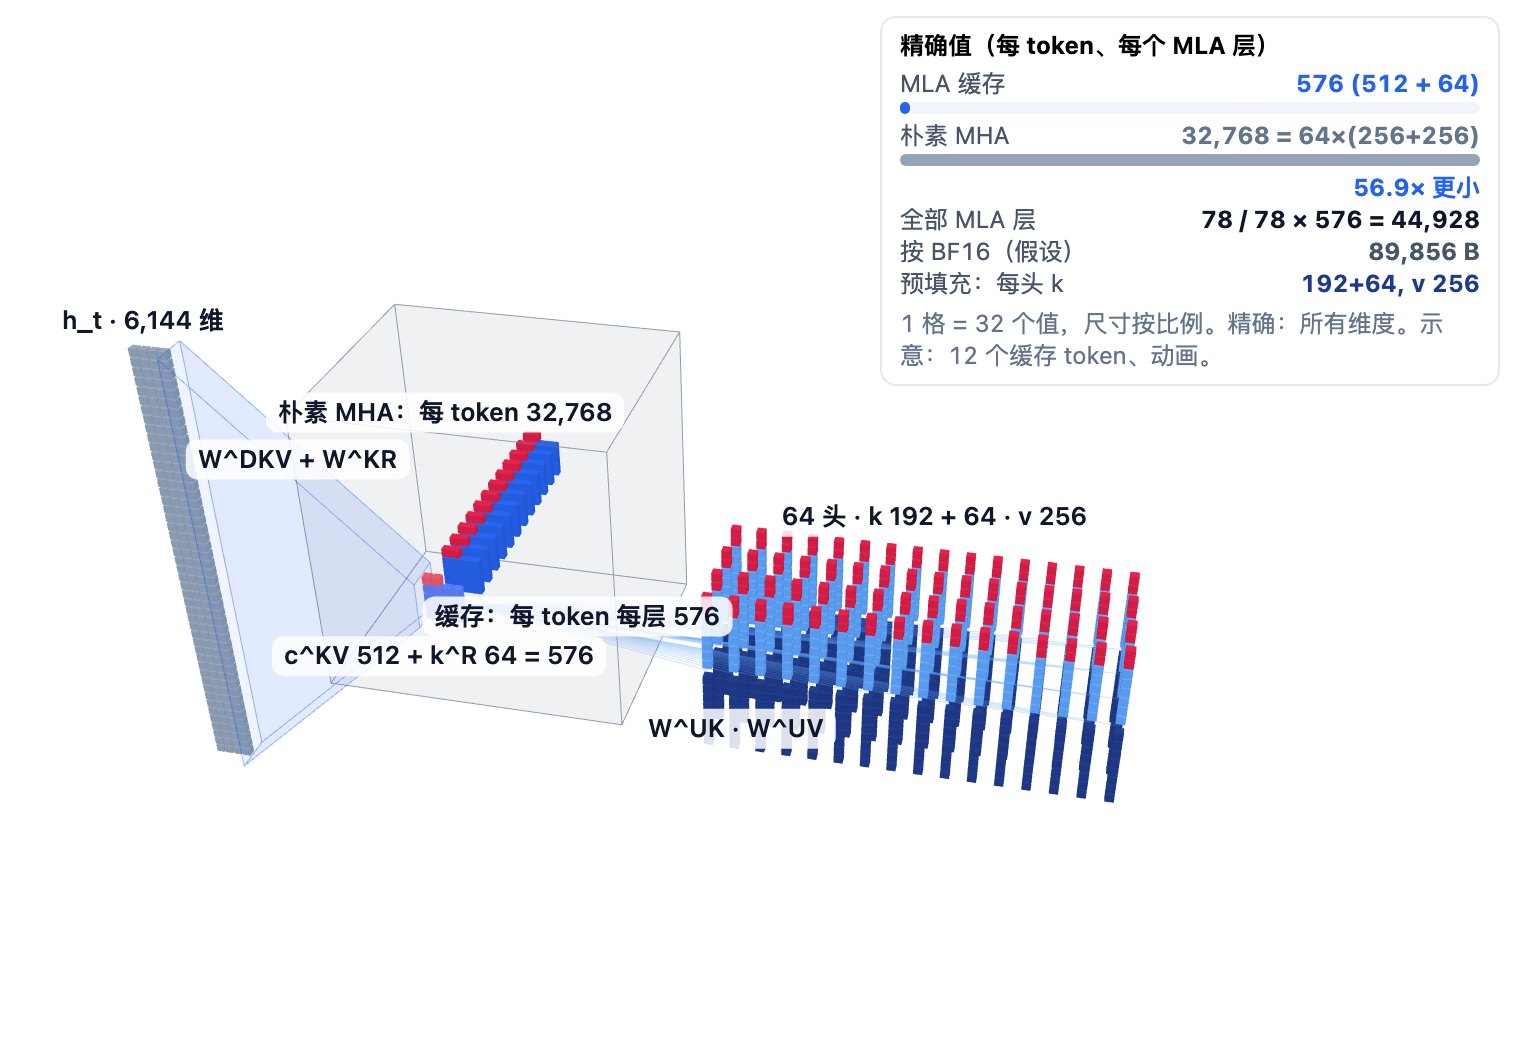
- 多头注意力(MHA)为每个头各存一份完整的键和值。DeepSeek-V2 论文把它写成每 token 每层 $2 n_h d_h$ 个数($n_h$ 个头,每头 $d_h$ 维)。按 GLM-5.3 的头尺寸(64 个头,键 256 维、值 256 维)算,就是 64 × (256 + 256) = 32,768 个数。
- GQA 让几个查询头共用一个键值头。GLM-5 报告的基线 GQA-8 有 8 个 128 维的键值头(2 × 8 × 128 = 2,048),即“2048 维 KV cache”。
- MLA 只存一个 512 维的潜在向量和一个 64 维的位置键,共 576 个数,64 个头共用。
| 缓存方案(每 token、每层) | 缓存的数值个数 | 占朴素 MHA 的比例(推算) | 数字来源 |
|---|---|---|---|
| 朴素 MHA:64 个头 × (256 K + 256 V) | 32,768 | 100% | 按 GLM-5.3 的维度推算 |
| GQA-8(GLM-5 报告的对照基线) | 2,048 | 6.25% | GLM-5 报告 |
| GLM-5.3 的 MLA:512 维潜在向量 + 64 维 RoPE 键 | 576 | 1.76% | 配置;报告称之为“576 维潜在 KV cache” |
78 层叠起来,MLA 每个 token 缓存 78 × 576 = 44,928 个数,按 bf16(16 位格式,每个数 2 字节)约 88 KiB(按配置推算)。朴素方案则要 78 × 32,768 = 2,555,904 个数,约为 MLA 的 57 倍(按配置推算)。§9 会把这些单 token 数字换算成百万 token 下的总量。
缓存变小,前提是效果不掉。主要证据来自 DeepSeek-V2 论文的消融实验:在两种规模的 MoE 模型上,MLA 的缓存只有 MHA 的 14% 和 4%,却在大多数报告的基准上得分更高。本节剩下的部分,讲 576 个数如何顶替 32,768 个数。
数字从哪来
- DeepSeek-V2 表 1 给出的每 token 缓存量:MHA 为 $2n_hd_hl$,$n_g$ 组的 GQA 为 $2n_gd_hl$,MLA 为 $(d_c+d_h^R)\,l$($l$ 为层数)。DeepSeek-V2 自己用的是 $d_c = 512$、$d_h^R = 64$,与 GLM-5.3 同为 576;论文按它 128 维的头尺寸,称这相当于“只有 2.25 组的 GQA”。
- DeepSeek-V2 表 9(消融):每 token KV cache,小 MoE 模型 MHA 110.6K、MLA 15.6K;大 MoE 模型 860.2K 对 34.6K。两种规模下 MLA 在 BBH、MMLU、CMMLU 上都更高;C-Eval 上小模型的 MLA 略低(50.9 对 51.6)。
- GLM-5.3 的数字用的配置键:
num_attention_heads64、qk_head_dim256、v_head_dim256、kv_lora_rank512、qk_rope_head_dim64、num_hidden_layers78。字节数按每个数 2 字节计;资料没有说明部署时缓存用什么精度存(可能是 FP8),DSA 索引器自己的键缓存(§5)也没有计入。
3.2 压缩:每个 token 一个潜在向量,按头还原
MLA 把“每个头的键和值都存下来”换成“只存一份简短摘要,键和值从摘要里推出来”。涉及的形状如下,矩阵一律写成 [输出 × 输入]。
kv_lora_rank),由 \(W^{DKV}\) [512 × 6,144] 加一次 RMSNorm 得到。写入缓存。qk_rope_head_dim),由 \(W^{KR}\) [64 × 6,144] 得到,所有头共用。写入缓存(§3.3)。q_lora_rank),见 §3.5。token $t$ 经过一层时,发生三件事:
- 下投影。 6,144 维的隐藏状态被压到 512 个数并做归一化:$c_t=\mathrm{RMSNorm}(W^{DKV}h_t)$。这个潜在向量不含位置信息。
- 写缓存。 潜在向量和同样由 $h_t$ 算出的 64 维 RoPE 键 $k^R_t=\mathrm{RoPE}(W^{KR}h_t)$ 一起写进缓存。这一对共 576 个数,就是这一层为该 token 存下的全部内容。
- 按需还原。 第 $i$ 个头从共享的潜在向量里还原出自己 192 维的内容键和 256 维的值,再把共享的 RoPE 键拼到键后面(这是训练/预填充时的视角;§3.4 会说明解码时省掉了这一步):
通俗地说:每个 token 不再写 64 组独立的键值对,而是写一张 576 个数的“便签”,64 个头各用自己的“镜片”去读。
举个玩具例子。设潜在向量只有 2 个数,$c=(1,2)$;头 1 的键矩阵三行分别是 $(1,0)$、$(0,1)$、$(1,1)$,得到的键是 $(1,2,3)$。头 2 的矩阵三行是 $(2,0)$、$(0,0)$、$(1,-1)$,键是 $(2,0,-1)$。算出了 6 个键分量,存下的只有 2 个数。代价是各头的键不能独立变化:64 × 192 = 12,288 个内容键数值,全是同样 512 个数的线性函数。MLA 赌的是 512 个方向够用,DeepSeek-V2 的消融检验的正是这一点。

实现细节
- 在 Miles(我们读过其 GLM-5 代码的开源训练框架,见 §10)中,$W^{DKV}$ 和 $W^{KR}$ 合成一个矩阵
linear_kv_down_proj,形状 [576 × 6,144],乘完再切成 512 维潜在向量和 64 维 RoPE 键(glm5/glm5.py)。与 DeepSeek-V2 的式 15 一致,RoPE 键由 $h_t$ 直接算出,而不是从潜在向量算。 - 64 个头的 $W^{UK}_i$ 和 $W^{UV}_i$ 放在同一个矩阵
linear_kv_up_proj里,形状 [64 × (192 + 256) = 28,672 × 512];潜在向量的 RMSNorm 权重也挂在这个模块上。 - 命名陷阱:在 Megatron 和 Miles 里,
qk_head_dim指 192 维的 NoPE 部分,qk_pos_emb_head_dim指 64 维的 RoPE 部分。Hugging Face 配置里同样的数字叫qk_nope_head_dim192 和qk_rope_head_dim64,而qk_head_dim是两者之和 256。
3.3 解耦 RoPE:位置走一条单独的小通道
注意力还得知道 token 在哪。RoPE 的做法是:把查询和键的维度两两配对,按 token 的位置旋转一个成比例的角度。位置 $t$ 的查询遇上位置 $j$ 的键时,两次旋转合成为一次按距离 $j-t$ 的旋转,于是得分取决于两个 token 相隔多远。
这恰恰和 MLA 冲突。§3.4 的解码技巧要把 $W^{UK}_i$ 挪到查询一侧。如果对还原出来的键 $W^{UK}_i c_j$ 做 RoPE,查询和 $W^{UK}_i$ 之间就夹着一个随两个 token 位置变化的旋转。每个缓存 token 需要的合成矩阵都不一样,合并就做不成了。DeepSeek-V2 论文说得很直白:这样一来,推理时“必须为所有前缀 token 重新计算键”。
MLA 的解法,论文称为解耦 RoPE(decoupled RoPE),是让两件事分开做:
- 内容放在每个头查询和键的 192 维部分。它从不旋转,所以可以合并。
- 位置放在另一个 64 维部分:每个头有自己的旋转查询切片 $q^R_{t,i}$,键这边只有一个 64 个头共用的旋转键 $k^R_t$。$k^R_t$ 直接由 $h_t$ 算出,旋转好之后才写进缓存,所以不存在要把矩阵越过它去合并的问题。
每个头完整的查询和键都是 256 维,192 维 NoPE(无位置编码)加 64 维 RoPE:
\[q_{t,i}=\big[\,q^C_{t,i}\,;\;q^R_{t,i}\,\big],\qquad k_{j,i}=\big[\,W^{UK}_i c_j\,;\;k^R_j\,\big],\qquad \mathrm{score}_i(t,j)=\frac{q^C_{t,i}\cdot W^{UK}_i c_j\;+\;q^R_{t,i}\cdot k^R_j}{\sqrt{256}}\]其中 $q^C_{t,i}$(192 维)和 $q^R_{t,i}$(64 维)是第 $i$ 个头的内容查询和旋转查询,由 §3.5 的查询潜在向量算出。
通俗地说:得分 = 内容匹配 + 带位置的匹配,只有后面那一小项涉及旋转。代价是每个 token 在缓存里多出 64 个数,所以一条是 576 而不是 512。
GLM-5.3 的 rope_theta 8,000,000(此前为 1,000,000)随 GLM-5.2 的 1M 上下文一起出现;rope_interleave true、无缩放项则从 GLM-5 起就是如此。§6 会介绍。
为什么旋转会挡住合并:一行推导
把位置 $p$ 处的旋转写成正交矩阵 $R_p$。如果对完整的键做 RoPE,内容得分就是 $(R_t q)^\top (R_j W^{UK}i c_j) = q^\top R{j-t}\, W^{UK}i c_j$。$R{j-t}$ 随每个缓存位置 $j$ 变化,而矩阵乘法不满足交换律,所以 $W^{UK}i$ 没法并成一个固定的、每头一份的查询矩阵。解耦之后,旋转只作用在 $q^R{t,i}$ 和 $k^R_j$ 上,内容项 $q^{C\top}_{t,i} W^{UK}_i c_j$ 中间什么也不夹。DeepSeek-V2 论文(第 2.1.3 节)用文字给出了这个论证,公式是我们的改写。
补充:Miles 按交错布局(rope_interleave true)施加 RoPE;它的 softmax 缩放是 $1/\sqrt{256}$ 乘以一个 YaRN mscale 系数的平方,该系数由运行时的旋转缩放设置算出。DeepSeek-V2 的式 18 用的是 $1/\sqrt{d_h+d_h^R}$。
3.4 解码技巧:把上投影“吸收”掉
如果每个解码步都把所有缓存的潜在向量还原成 64 份键和值,省下的就全赔回去了:缓存是小了,可每一步都要对整个前缀重做还原。MLA 用一个改写避开这一点,DeepSeek-V2 论文称之为把 $W^{UK}$ 吸收进查询、把 $W^{UV}$ 吸收进输出。说穿了就是矩阵乘法的结合律:
\[\mathrm{score}_i(t,j)\cdot\sqrt{256}=q^{C}_{t,i}\cdot\left(W^{UK}_i c_j\right)+q^{R}_{t,i}\cdot k^R_j =\underbrace{\left(W^{UK\top}_i q^{C}_{t,i}\right)}_{512\text{ 维}}\cdot\,c_j+\underbrace{q^{R}_{t,i}}_{64\text{ 维}}\cdot\,k^R_j\]对一个新 token,每个头做四件事:
- 查询只翻译一次。 192 维的内容查询乘上 $W^{UK\top}_i$,变成“潜在空间语言”里的 512 维查询,再拼上 64 维的 RoPE 查询,共 576 个数。
- 直接给每条缓存打分。 每个得分是与缓存里 $[c_j; k^R_j]$ 的一次 576 维点积。64 个头读的是同一条缓存。
- 混合潜在向量,而不是值。 softmax 加权求和直接作用在缓存的 512 维潜在向量 $c_j$ 上,它同时充当值。
- 最后只还原一次。 对这一个加权和乘上 $W^{UV}_i$ [256 × 512],再过输出投影。
通俗地说:还原从“每个缓存 token 一次”变成了“每个新 token 一次”。GLM-5 报告直接写明了开销:“解码时 MLA 要做 576 维点积,高于 GQA 的 128 维计算”。
为什么要用更多计算换更少字节?解码时每条序列每步只产出一个 token,通常大部分时间花在从显存读缓存上,计算单元在等数据。按我们的推算,以浮点运算次数(FLOPs)计,每个被关注的 token、每层:
| 解码注意力,一个新 token(推算) | FLOPs | 读取字节(bf16) | 每字节 FLOPs |
|---|---|---|---|
| 朴素 MHA:64 个头 × (256 K + 256 V) | 65,536 | 65,536 | 1.0 |
| 吸收后的 MLA:64 个头 × (576 打分 + 512 混合) | 139,264 | 1,152 | 约 121 |
MLA 的计算量约为 2.1 倍,读取的字节却少约 57 倍。在 DSA 下,每个查询最多关注 2,048 个 token(§5),所以每生成一个 token,一层的 MLA 部分只读约 2.4 MB 缓存;同样 2,048 个 token,朴素 MHA 要读 134 MB(按我们的推算)。在运行索引器的层上,还要另外扫描所有历史 token 的索引键(§5.3)。如果不吸收,把这 2,048 个潜在向量过一遍 [28,672 × 512] 的上投影,每层每 token 约要 60 GFLOPs;吸收后的注意力核心只要约 0.29 GFLOPs。
下面的 3D 模型展示两条路径:训练和预填充用的展开形式,以及解码用的吸收形式;它的 Flash 模式在 §8.4 再次用到。
假设与代码层面的细节
- 成本模型(我们的):FLOPs = 2 × 乘加次数;忽略 softmax、RoPE 和归一化;每个缓存数值 2 字节;忽略权重读取(同一批次共享)。MLA 每个被关注 token:$2\cdot64\cdot576 + 2\cdot64\cdot512 = 139{,}264$ FLOPs,$576\cdot2 = 1{,}152$ 字节。若稠密关注 131,072 个 token,同一层 MLA 读约 151 MB,朴素 MHA 读约 8.6 GB。
- 不吸收的代价:每步每个缓存 token $2\cdot512\cdot28{,}672 \approx 29.4$ MFLOPs,2,048 个 token 约 60.1 GFLOPs。
- 也可以真的把每个头的 $W^{UK\top}_i W^{UQ}_i$ 预先乘好,但在这些尺寸下两步做更省(按我们的推算,每 token 约 62.9 对 134.2 MFLOPs),因为 192 维的 NoPE 查询比 512 维的潜在向量窄。把 $W^{UV}_i$ 并进 $W^O$ 也是同理。Miles 在
glm5/glm5.py里保留了两步的einsum。 - Miles 训练时也用吸收形式:查询为 [token 数 × 64 × 576],键为 [token 数 × 576],送入稀疏 MLA kernel。DeepSeek-V3.2 论文同样把 DSA 实现在“MLA 的 MQA 模式”上(MQA 即多查询注意力,见 §5.2),每个潜在向量由所有查询头共享。Z.ai 是否这样训练 GLM-5.3,资料没有说明。
3.5 查询路径与参数量
查询同样先压缩,但理由不同。隐藏状态先下投影到 2,048 维(q_lora_rank),过一次 RMSNorm,再上投影成 64 个头 × 256 维:每个头 192 维 NoPE、64 维 RoPE。查询从不进缓存,所以这一步不省缓存;DeepSeek-V2 论文说,这样做是为了降低训练时的激活显存。§5 会看到,DSA 索引器读的正是这个 2,048 维的查询潜在向量。
把各部分拼起来,按我们的推算,一个 MLA 模块约 165.0M 参数:
| 矩阵 | 形状 [输出 × 输入] | 参数量(推算) |
|---|---|---|
| $W^{DQ}$,查询下投影 | 2,048 × 6,144 | 12.58M |
| $W^{UQ}$ + $W^{QR}$,查询上投影(合并) | 64 × 256 = 16,384 × 2,048 | 33.55M |
| $W^{DKV}$ + $W^{KR}$,潜在向量 + RoPE 键(合并) | 576 × 6,144 | 3.54M |
| $W^{UK}$ + $W^{UV}$,全部头(合并) | 64 × (192 + 256) = 28,672 × 512 | 14.68M |
| $W^O$,输出投影 | 6,144 × 16,384 | 100.66M |
| 每层合计 | 165.02M |
78 层约 12.9B,不到整个模型的 2%(§2.3)。大头是输出投影。负责写缓存、读缓存的矩阵都很小:生成每条 576 维缓存的下投影只有 3.54M 参数。一个 token 跑完这五个矩阵,每层约 330 MFLOPs,即参数量的两倍,与上下文长度无关。
数字从哪来
- 配置键(GLM-5、5.1、5.2、5.3 完全相同):
num_attention_heads64、num_key_value_heads64、q_lora_rank2048、kv_lora_rank512、qk_nope_head_dim192、qk_rope_head_dim64(所以qk_head_dim为 256)、v_head_dim256、attention_biasfalse。GLM-5 报告表 10 给 GLM-5 列的是 Q LoRA Dim 2048、KV LoRA Dim 512。 - 形状按 DeepSeek-V3 式投影、无偏置计算,与 Miles 的模块定义一致;归一化权重(几千个数)未计入。这些是我们的推算,不是官方数字。
- 两个 RMSNorm 作用在潜在向量($c^Q_t$ 和 $c_t$)上,沿用 DeepSeek-V2 在压缩潜在向量之后加归一化的做法。
3.6 GLM-5 的两处调整:Muon Split 与 MLA-256
MLA 的小缓存起初是有代价的。GLM-5 用 Muon 优化器训练,它会把每个权重矩阵的更新正交化;GLM-5 技术报告发现,用原始 MLA 时,576 维潜在缓存的效果“无法达到” GQA-8(缓存 2,048 维)的水平。报告为此介绍了两处调整,GLM-5.3 的文档对两者都只字未提。MLA-256 能从 GLM-5.3 的配置里看到;Muon Split 是预训练阶段的优化器配方,没有资料说明 GLM-5.3 所基于的 GLM-5.2 基座是否用过它。
Muon Split 不再对整块上投影矩阵 $W^{UQ}$、$W^{UK}$、$W^{UV}$ 做正交化,而是按头切开、各自正交化,让每个头的权重能以不同的幅度更新。报告的结论是 Muon Split 让 MLA“追平”了 GQA-8。细看表 1,结果有好有坏:MMLU 和 C-Eval 上 Split 领先(Hellaswag 和 RACE 上也小幅领先,下表未列),BBH、GSM8K 和 HumanEval 上仍然落后。报告还提到一个附带收益:用了 Muon Split,GLM-5 预训练期间注意力 logit 的尺度保持稳定,“无需任何裁剪策略”。
报告表 1 的部分数据
| 方案 | MMLU | C-Eval | BBH | GSM8K | HumanEval |
|---|---|---|---|---|---|
| GQA-8 | 61.2 | 60.0 | 53.3 | 47.6 | 38.5 |
| MLA | 61.5 | 59.7 | 48.9 | 46.2 | 33.5 |
| MLA + Muon Split | 62.5 | 62.1 | 51.8 | 45.0 | 36.7 |
| MLA-256 + Muon Split | 62.0 | 59.9 | 51.3 | 47.5 | 36.6 |
MLA-256 针对的是 §3.4 里的解码计算量。报告指出,DeepSeek-V3 的头数是按 H800 的 roofline 选的,换到别的硬件就不合适。于是 GLM-5 把头维度“从 192 增加到 256”,头数“减少 1/3”,这样“训练计算量和参数量保持不变,解码计算量下降”。表 1 最后一行显示它和 MLA + Muon Split 大致持平。
按我们的理解,头少之所以能省解码:在吸收写法下,每个头对每个缓存 token 都要做 $576 + 512$ 次乘加,与头维度无关,所以解码注意力每个被关注 token 的开销是 $2 \cdot n_h \cdot 1{,}088$ FLOPs,只随头数 $n_h$ 增长。报告把训练和预填充阶段的 MLA 称为“MHA 风格”,在这种展开形式下,头变宽正好抵消了头变少。举个假想的例子:如果 GLM-5.3 有 96 个头,每个缓存 token 要 208,896 FLOPs,而不是 139,264。
数字从哪来
- 报告表 10 给 GLM-5 写的是“QK Head Dim 192”,对应
qk_nope_head_dim;配置里完整的查询/键头维度是 192 + 64 = 256。我们的理解是“从 192 到 256”指完整的头(DeepSeek-V2 式的 128 + 64 变成 192 + 64),但报告没有明说。 - 报告没说 MLA-256 的头数是从多少砍下来的。GLM-4.5 有 96 个头(报告表 10),96 × 2/3 = 64,正好是 GLM-5.3 配置里的头数,所以按我们的理解,基线有可能是 96。这只是推测。
- “MLA-256”是报告里的叫法;GLM-5.3 的配置里只有各个维度。
3.7 MLA 接下来出现在哪
- DSA 跑在 MLA 之上(§5)。 闪电索引器最多挑出 2,048 个历史 token,§3.4 的吸收式 MLA 随后只关注它们那几条 576 维缓存。索引器在负责计算的层上另有一份小的键缓存。
- GLM-5.3-Flash 用的是 NoPE MLA(§8.3、§8.4)。 请记住这个 192/64 的切分:Flash 把它推到了极限,旋转部分的宽度是 0。它的缓存条目就是光秃秃的 512 维潜在向量,45 层里也只有 11 层保留这种缓存。
4. MoE:256 个专家,每次只用 8 个
MoE 层把一个大的前馈网络换成许多小网络,也就是“专家”,再由路由器为每个 token 挑出其中几个。GLM-5.3 几乎所有参数都在这里,但任何一个 token 只用到其中很小的一部分。
4.1 用数字看一层
GLM-5.3 的前馈模块分两种:
- 第 0–2 层(稠密):普通的 SwiGLU 前馈网络,6,144 → 12,288 → 6,144,每层约 226.5M 参数(按配置推算)。
- 第 3–77 层(MoE,共 75 层):256 个路由专家加 1 个共享专家。每个专家是一个小 SwiGLU 网络,6,144 → 2,048 → 6,144,参数量 3 × 6,144 × 2,048 ≈ 37.75M(按配置推算)。
每个 token 由路由器选 8 个路由专家,共享专家始终参与:
两组对比能看清其中的取舍(均按配置推算)。每个 token 在 MoE 层里做的前馈计算比稠密层还多(用到 339.7M 对 226.5M 参数),存储的权重却是稠密层的约 43 倍。75 个 MoE 层加起来,每个 token 激活的 9 个专家共约 25.5B;GLM-5 报告给出的激活参数总量约 40B(按配置推算为 39.9B)。
4.2 路由器怎样从 256 个里挑出 8 个
配置列出了路由器的各个部件(对应的键见下方实现细节):sigmoid 打分、每个专家带一个偏置的无辅助损失 top-k 方法 noaux_tc、权重重新归一化、缩放系数 2.5,以及 float32 路由器。按 DeepSeek-V3 对这些键的标准语义来读(这是我们的理解;路由器代码本身在 Megatron-LM 和 SGLang 里,我们没有核查),一个 token 的路由过程如下:
- 打分。每个专家 $i$ 各自得到一个 0 到 1 之间的分数 $s_i=\sigma(e_i^\top h)$,用 fp32 计算。
- 挑选。给每个专家加上偏置 $b_i$,取 $s_i+b_i$ 最大的 8 个。
n_group和topk_group都是 1,所以 256 个专家在同一个池子里竞争,没有分组限制路由。 - 加权。偏置在这一步去掉。胜出者的原始分数重新归一化到和为 1,再乘以 2.5。
- 合并。共享专家的输出加上 8 个路由专家输出的加权和,就是这一层的结果。
通俗地说:偏置决定谁拿到这个 token,原始分数决定每个胜出者贡献多少。举个例子:专家 41 得分 0.70、偏置 −0.10,专家 7 得分 0.62、偏置 +0.05。挑选时比较的是 0.60 和 0.67,所以专家 7 拿到名额。假如 8 个胜出者的原始分数之和为 4.0,专家 7 的权重就是 2.5 × 0.62 / 4.0 ≈ 0.39。
4.3 不靠辅助损失也能均衡
MoE 有个不易察觉的毛病:少数专家接走大部分 token,其余专家闲着。很多 MoE 模型会在训练目标里加一项辅助负载均衡损失。noaux_tc 则依靠挑选用的偏置:按 DeepSeek-V3 技术报告的做法(属于背景知识,不在我们的 GLM 资料里),负载过高的专家偏置被调低,负载不足的被调高,不需要第二个损失项,负载也能逐渐拉平。Z.ai 自己的偏置更新策略,我们手上的资料里没有。
GLM-5.3 的配置里根本没有辅助损失系数。显式的 moe_router_dtype: float32 键从 GLM-5.2 的配置开始出现。为什么这里在意精度?我们的理解是:top-8 的取舍取决于 256 个分数之间的细微差别,再叠加很小的偏置修正,精度一低就可能分不清。
下面的 3D 模型可以让你把 token 送进这样一个路由器。其中的分数和负载分布都是合成数据,用来演示机制,不代表 GLM-5.3 的真实路由。
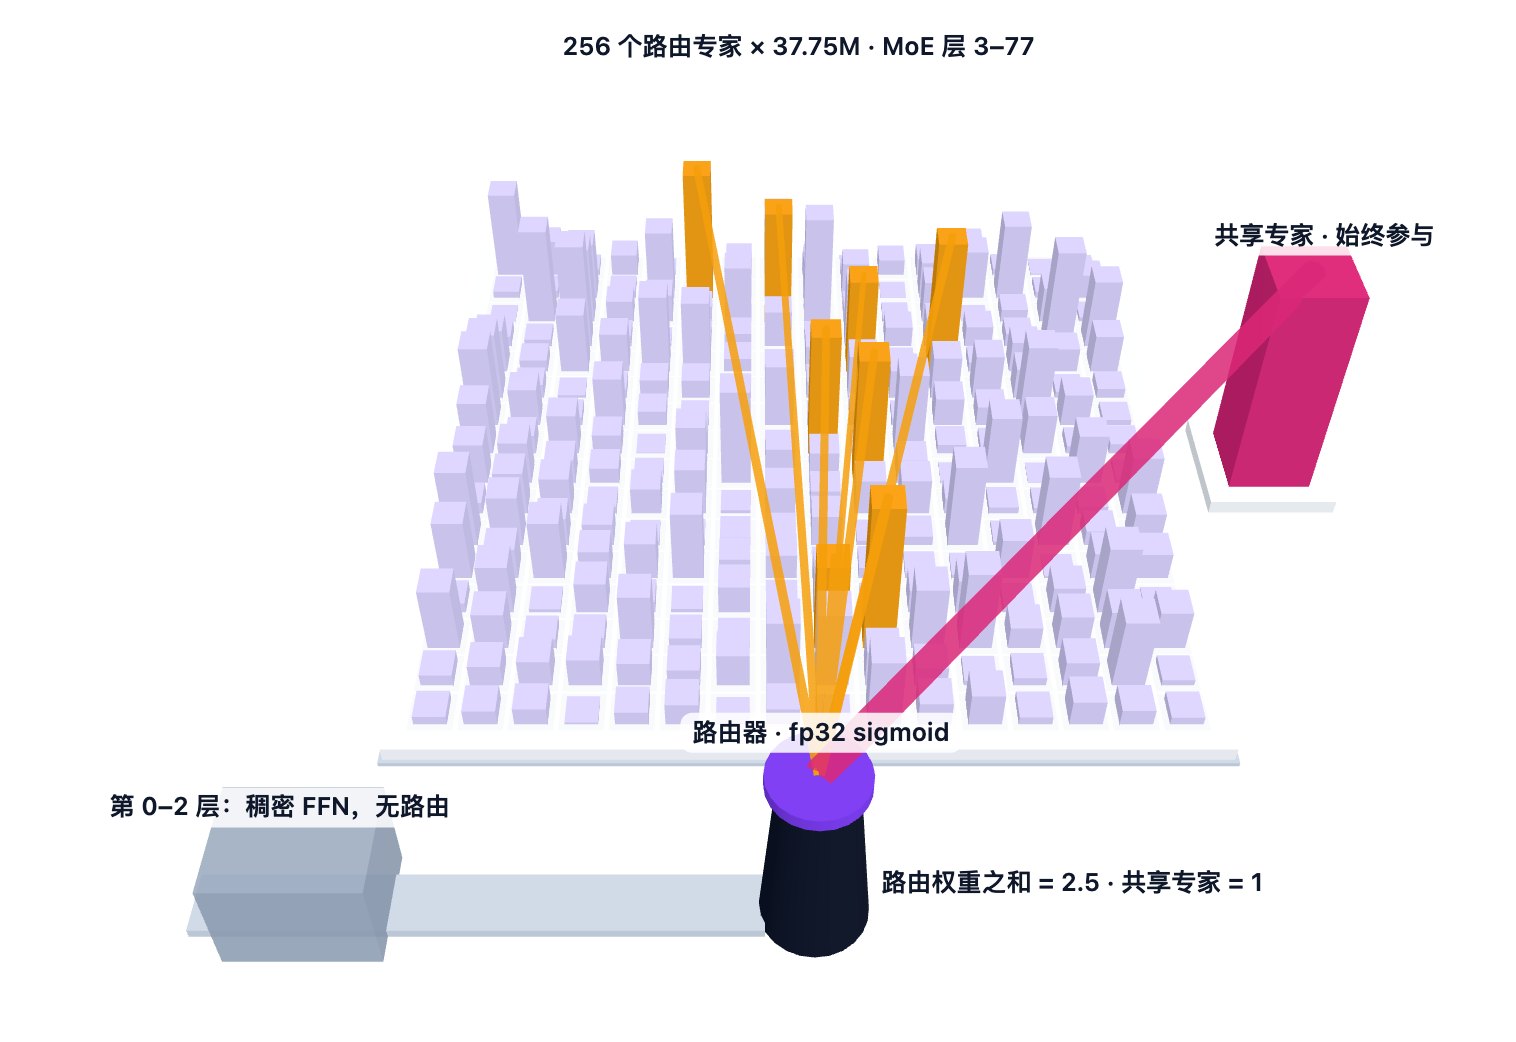
GLM-5.3-Flash 沿用同一套路由配方,但换成 288 个更小的专家,并新增两个配置键;§8.7 介绍这些差异,并在 Flash 模式下重看 3D 模型。
数字从哪来
- 配置键(GLM-5 到 GLM-5.3 未变):
first_k_dense_replace3、intermediate_size12288、n_routed_experts256、n_shared_experts1、num_experts_per_tok8、moe_intermediate_size2048、scoring_funcsigmoid、topk_methodnoaux_tc、norm_topk_probtrue、routed_scaling_factor2.5、n_group1、topk_group1。moe_router_dtypefloat32 从 GLM-5.2 起出现。mlp_layer_types把第 0–2 层标为 dense,第 3–77 层标为 sparse。 - 配置没有写共享专家的宽度。我们按 DeepSeek-V3 的惯例,假设它等于
moe_intermediate_size(2,048)。 - 每个 MoE 层 9.70B = 257 个专家 × 37.75M + 约 1.57M 的路由器(256 × 6,144 个权重 + 256 个偏置)。全模型的拆分(路由专家约 724.8B,占总量 96% 以上)见 §2。
- MTP 层(第 78 层)也是 MoE 层。在 FP8 检查点里,全部 76 个 MoE 层(第 3–78 层)的路由权重(
mlp.gate)和e_score_correction_bias都不做量化。
实现细节:Miles 在强化学习(RL)中如何处理路由
- Miles 的 GLM-5.3-Flash 模型脚本设置了
--moe-router-bias-update-rate 0,所以 RL 训练期间专家偏置保持冻结;它的 GLM-5 和 GLM-5.2 旗舰模型脚本(glm5-744B-A40B.py、glm5.2-744B-A40B_lora.py)也设了同一个参数。它的启动脚本还可以打开 rollout 路由重放(R3,--enable-r3→--use-rollout-routing-replay),让训练复用推理时选定的专家;代码注释写道“routing replay needs materialized topk ids”。 - GLM-5 报告提到 MoE 路由重放,只是在解释 DSA 索引器的 top-k 为何关系到 RL 稳定性时作为类比(见 §5.7)。
- 这些都是开源 Miles 实现里的选择,并不说明 Z.ai 是怎样训练 GLM-5.3 的。
5. DeepSeek 稀疏注意力与索引共享:只读 2,048 个 token,也少挑几次
上下文长到一百万 token 时,如果每个新 token 都要看一遍前面所有的 token,这一步就成了根本瓶颈。GLM-5.3 分两步绕开它。第一步,用一个便宜的打分器挑出最重要的 2,048 个历史 token,昂贵的注意力只读这些。第二步,相邻层挑中的 token 几乎一样,于是大多数层干脆直接沿用前面某一层的挑选结果。
5.1 为什么要稀疏注意力:DSA 的两个部件
稠密注意力的工作量与上下文长度成正比。位置 $L$ 上的 token 要拿查询和全部 $L$ 个缓存条目逐一比较,所以每个新 token 的成本随 $L$ 线性增长,处理整段序列则随 $L^2$ 增长。在 GLM-5.3 的吸收式 MLA 里(§3.4),一个头对每个缓存 token 要做一次 576 维点积来打分,再做一次 512 维加权求和来出结果。64 个头合计,每层每个缓存 token 要 69,632 次乘加(按配置推算)。
当 $L$ = 1,048,576 时,单单一层、每生成一个新 token 就要约 730 亿次乘加,这还没算模型的任何权重(按配置推算)。而 GLM-5 / GLM-5.2 共用基座的约 40B 激活参数(GLM-5 报告表 10),整个 78 层模型每个 token 也只要约 400 亿次乘加(每个权重一次,粗略推算)。也就是说,在一百万 token 处,一层稠密注意力的开销就超过了全部权重计算的总和。
便宜的替代方案都会丢信息。GLM-5 技术报告(arXiv 2602.15763)在 40 层的 GLM-9B 上测了其中两种:保留一半层为全注意力(1:1),并在 64K 长度上继续训练 190B token。
- 滑动窗口注意力(SWA): 每个 token 只看最近固定长度的窗口。
- 线性注意力: 用固定大小的循环记忆代替不断增长的 KV cache(§8.2)。
相对全注意力,RULER(一个长上下文检索基准)在 128K 上的变化如下:
| 变体(仍有一半层是全注意力) | RULER@128K 变化 |
|---|---|
| SWA Interleave(隔层滑动窗口) | −30.35 |
| SWA Pattern(搜索窗口层的位置) | −5.69 |
| GDN(Gated DeltaNet,一种线性注意力层) | −11.28 |
| SimpleGDN(报告提出的轻量 GDN 变体) | −8.25 |
即使留下一半稠密层,每个变体在细粒度检索上都有损失。报告的结论是,与这些方案不同,DSA 可以用在每一层;旗舰模型正是如此,78 层全用 DSA。读到 §8 时请记住这张表:GLM-5.3-Flash 确实用了线性注意力,但每四层里保留一层 DSA。
数字从哪来
- 每个缓存 token 的成本:64 个头 × (576 + 512) = 69,632 次乘加,算的是吸收式打分(512 维潜在向量 + 64 维 RoPE)加上对 512 维潜在向量的加权求和,与 Miles 的稀疏内核一致。softmax、各种投影和吸收矩阵都不计入,因为有没有稀疏它们都一样。69,632 × 1,048,576 ≈ 7.3 × 10¹⁰ 是我们的算术。
- 消融(表 5):GLM-5 报告 2.1.2 节。SWA 即滑动窗口注意力(报告免训练的表 4 用 4,096 token 窗口)。这些实验用的是 GLM-9B,不是 GLM-5。
DSA 的思路。 DSA 保留精确的注意力,只是让它少读一些。它出自 DeepSeek-V3.2(arXiv 2512.02556),是 V3.2 相对 DeepSeek-V3.1-Terminus 唯一的架构改动,靠继续训练加上。论文把它拆成两个部件:
- 闪电索引器(lightning indexer):便宜地给每个历史 token $s$ 打一个相关性分数 $I_{t,s}$,衡量它对当前查询 token $t$ 的价值(§5.2)。
- 细粒度 token 选择:只留下得分最高的 $k$ 个 token,正常的注意力只在它们的 MLA 缓存条目 $c_s$ 上计算(§5.3)。
用 V3.2 论文的记号,注意力输出 $u_t$ 为
\[u_t \;=\; \mathrm{Attn}\!\Big(h_t,\;\big\{\,c_s \;\big|\; I_{t,s}\in \mathrm{Top}\text{-}k\big(I_{t,:}\big)\big\}\Big)\]说白了:图书管理员先把整套目录翻一遍,抽出 2,048 本书;读者只精读这些。翻目录还是要碰到每一张卡片,所以每张卡片的成本必须远低于读一本书。GLM-5.3 用 $k$ = 2,048(index_topk),与 DeepSeek-V3.2 相同。在 1M token 的上下文里,一层只读 1,048,576 个 token 中的 2,048 个,约 0.2%(按配置推算)。
5.2 闪电索引器详解
索引器是一个迷你注意力层,只干一件事:给每个历史 token 算出一个数。对每个查询 token $t$,它用这个 token 自己的激活值算出三样东西;每个历史 token $s$ 只贡献一样:
| 部件 | 从哪里算 | GLM-5.3 形状 | 权重 |
|---|---|---|---|
| 索引查询 $q_{t,1..32}$ | MLA 的 2,048 维压缩查询(q_lora,§3.5),先做 RMS 归一化,再投影 |
32 头 × 128 | wq_b:2,048 → 4,096 |
| 头权重 $w_{t,1..32}$ | 该 token 的 6,144 维隐藏状态 | 32 个标量 | weights_proj:6,144 → 32 |
| 索引键 $k_s$ | 历史 token 的隐藏状态,投影后过 LayerNorm | 一个 128 维向量 | wk:6,144 → 128,外加 k_norm |
查询 token $t$ 对历史 token $s$ 的打分为
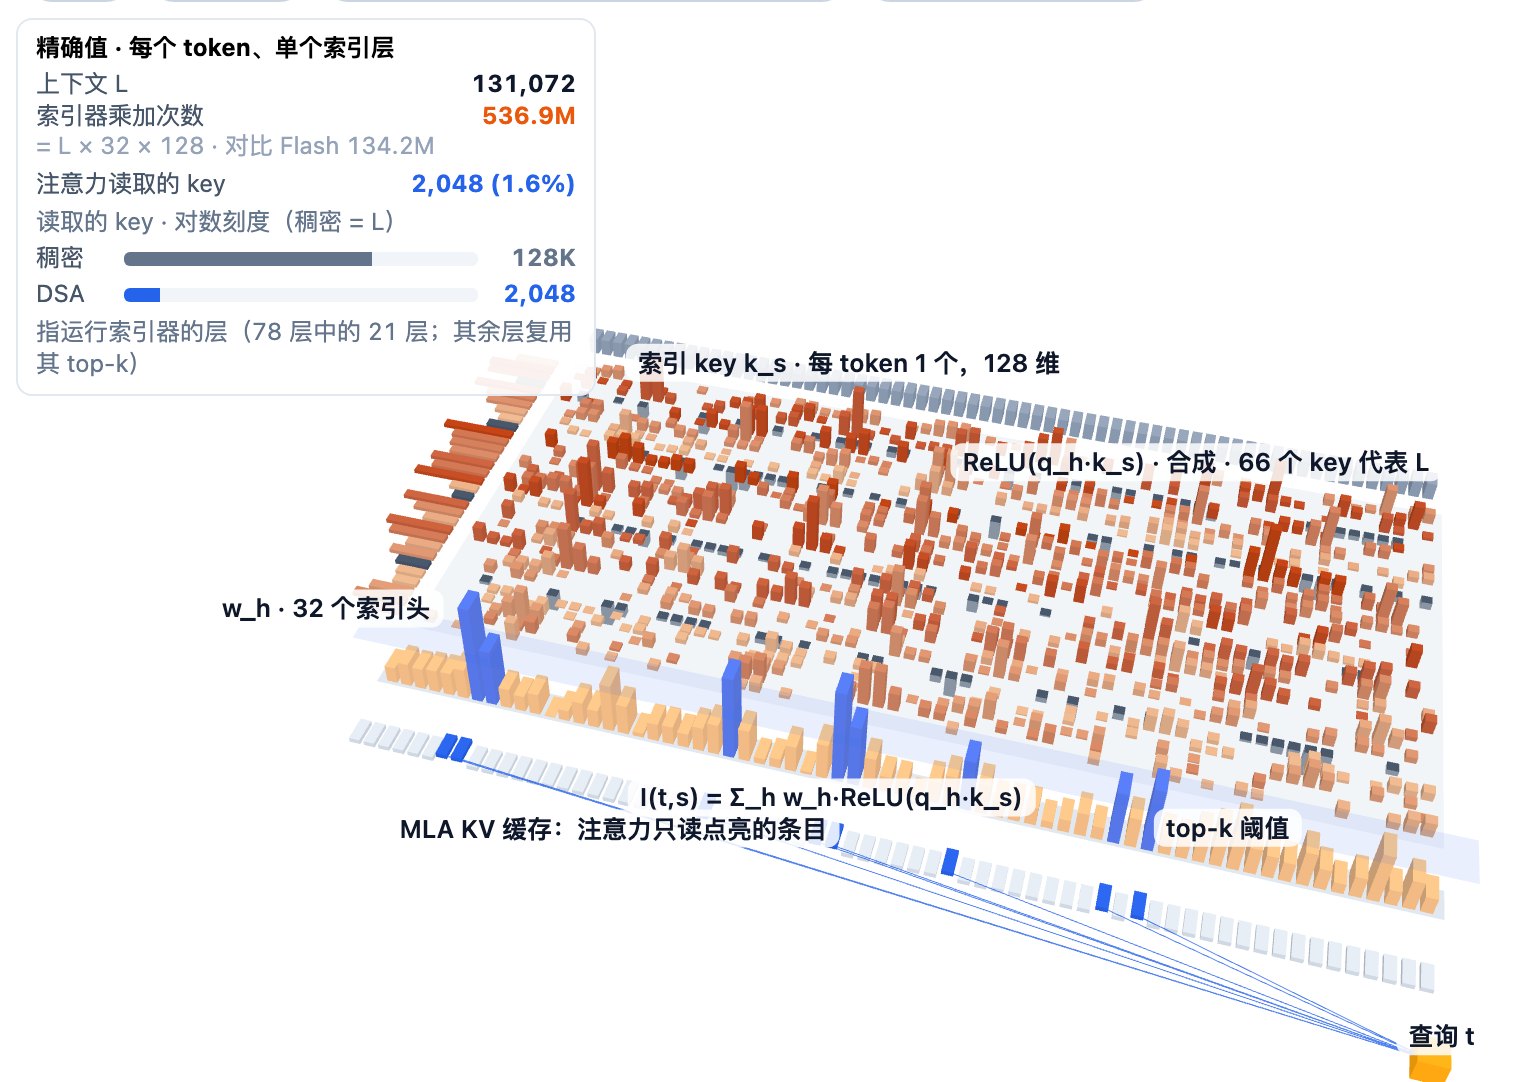
\[I_{t,s} \;=\; \sum_{j=1}^{32} w_{t,j}\;\mathrm{ReLU}\!\left(\mathbf{q}_{t,j}\cdot\mathbf{k}_{s}\right)\]说白了:32 个头(下标 $j$)各自把查询和这个 token 的键做一次 128 维点积,负数截成 0,再按这个查询自己的权重把各头加起来。对每个历史 token 都算一遍,排序,留下最好的 2,048 个。
一个小例子。 把索引器缩到 2 个头,给两个历史 token A、B 打分(数字为虚构):
| 头 1 点积 | 头 2 点积 | ReLU 之后 | 用 $w_t$ = (1.0, 0.5) 加权 | |
|---|---|---|---|---|
| token A | 0.8 | −0.3 | (0.8, 0) | 1.0 × 0.8 + 0.5 × 0 = 0.80 |
| token B | −0.5 | 0.9 | (0, 0.9) | 1.0 × 0 + 0.5 × 0.9 = 0.45 |
A 排在 B 前面。假如同一个查询的头权重换成 (1.0, 2.0),B 得 1.8 分,反超 A。各头的匹配没变,是权重决定了听哪个头的意见。

四个设计决定让这个打分器既便宜又称职:
- 每个 token 只有一个共用的键。 DeepSeek 的公式里 $\mathbf{k}_s$ 没有头下标,32 个索引头都和同一个 128 维键比较。索引器的形状就像多查询注意力(MQA,多个查询头共用一个键)。因此每个历史 token 只往索引键缓存里加 128 个数,MLA 则要 576 个。
- 用 ReLU 而不是 softmax。 DeepSeek-V3.2 只说选 ReLU 是“出于吞吐量的考虑”。我们的理解是:ReLU 每个元素只做一次比较,不需要指数运算,也不需要跨 token 归一化。这也意味着一个头只能给 token 投赞成票:匹配得差只记 0 分,不会扣分;头权重可正可负,决定每张票算多少。
- 头少、精度低。 论文指出索引器“头数很少,可以用 FP8 实现”。GLM-5.3 的 FP8 checkpoint 把
wq_b和wk存成 FP8 权重。至于推理引擎打分时用什么精度,我们的资料里没有写。 - 位置信息只占一半维度。 RoPE 只旋转每个索引查询和索引键 128 维中的 64 维,另外 64 维只比内容。这就是 V3.2 架构图里的“partially apply RoPE”。GLM 用的是和主干 MLA 同一张旋转表;我们的理解是,索引器因此可以偏向邻近或相对位置合适的 token。
成本有多少。 给一个历史 token 打分要 32 头 × 128 维 = 4,096 次乘加。稠密 MLA 对同一个 token 要花 69,632 次(§5.1),所以按每个 token 算,索引器便宜 17 倍,这还没算 FP8 带来的收益(按配置推算)。IndexCache 论文的描述说的正是这件事:头数少、用低秩投影和 FP8 运算,按每 FLOP 计比主干的 MLA“便宜一个数量级”(arXiv 2603.12201)。
不过每个 token 再便宜,总量仍随 $L$ 线性增长。索引器要给所有历史 token 打分,整段序列下来还是 $O(L^2)$;主注意力则从 $O(L^2)$ 降到 $O(Lk)$。这种不对称决定了长上下文下成本落在哪里(§5.3、§5.5)。
下面的 3D 模型演示一个查询的打分过程;它的 Flash 模式对应 §8.5。
实现细节
- 配置键(GLM-5 到 GLM-5.3 完全一致):
index_n_heads32、index_head_dim128、index_topk2048、indexer_rope_interleavetrue。GLM-5 报告表 10 同样列出 32 个、每个 128 维的索引头。DeepSeek-V3.2 论文没有写它自己的索引器尺寸,所以我们不把 32 × 128 算到 DeepSeek 头上。 - 张量形状参照 Miles 的 GLM-5 索引器(
miles_plugins/models/glm5/glm5.py)。四个模块里除了k_norm是带权重和偏置的 LayerNorm,其余都是无偏置线性层。每个索引器:wq_b8,388,608 +wk786,432 +k_norm256 +weights_proj196,608 ≈ 9.37M 参数(按我们的计数)。 - 缩放。 头权重用 fp32 计算,再乘以 $32^{-1/2}\cdot 128^{-1/2} = 1/64$,相当于把常见的 $1/\sqrt{d}$ 点积缩放和按头数开方的 $1/\sqrt{H}$ 归一化都并进了 $w_{t,j}$。上面的公式省略了这个常数。
- 梯度隔离。 索引器把输入全部 detach(压缩查询、共用的查询归一化权重、隐藏状态和旋转表),代码注释写着 “Share the norm with the indexer without sending indexer gradients into the attention parameters”。这就是 V3.2 “索引器单独优化”在代码里的样子(§5.4)。
-
RoPE 布局。 indexer_rope_interleave为 true 时,每个 128 维索引向量切成 [64 维无位置64 维旋转],旋转部分用相邻通道交错配对,和 GLM 主干 MLA 的做法一致。代码注释提到 “DeepSeek v3.2 indexer uses non-interleaved RoPE with rope dims first”。资料没有解释为什么不同。 - 打分内核。 Miles 改编了 TileLang 的 DeepSeek-V3.2 示例
fp8_lighting_indexer,但输入是 BF16、累加用 FP32,所以 Miles 里训练用的索引器是 BF16。它对每个头算 $\max(\mathbf{q}\cdot\mathbf{k}, 0)\times w$ 再对头求和,然后把查询因果窗口以外(以及所在打包文档以外)的键都设为 $-\infty$。查询按每块 8,192 行分批处理。 - FP8 的证据。 GLM-5.3 配置的量化方式是 FP8 e4m3、128 × 128 权重分块;
wq_b和wk不在modules_to_not_convert里,索引器的k_norm则保持不转换。 - 昇腾 NPU 上,GLM-5 报告描述了一个融合的 “Lightning Indexer” 内核,把“打分计算、ReLU 和 TopK 操作集成进同一个内核”。
5.3 token 选择:在 MLA 的共享潜在向量上做稀疏注意力
每个历史 token 都有了分数,挑选就很简单。对每个查询 token,这一层保留得分最高的 2,048 个,把它们的位置交给注意力内核。有三个细节让它和 MLA 配合得很好。
每个 token 一份名单,64 个头共用。 索引器的 32 个头最终汇成每对 $(t, s)$ 一个分数,所以每层每个查询 token 只有一份 top-2,048 名单。这个 token 的 64 个注意力头读的是同样 2,048 个条目,各头不单独挑选。
选中的是 MLA 的潜在向量。 每个入选位置指向 §3 里 MLA 缓存的一行:512 维潜在向量加 64 维旋转键 $k^R_s$,共 576 个数。内核把这 2,048 行取出来,原样套用吸收式 MLA(§3.4):每个头用一次 576 维点积给每一行打分,softmax 对 512 维潜在向量加权求和,最后再用 $W^{UV}_i$ 展开一次。稀疏只是把行的名单缩短了,每一行上的计算和稠密层完全一样。
为什么“MQA 模式”很关键。 DeepSeek-V3.2 解释了这个选择:“在内核层面,为了计算效率,每个键值条目必须被多个查询共享”,因此 DSA “基于 MLA 的 MQA 模式实现,每个潜在向量(MLA 的键值条目)由该查询 token 的所有查询头共享”。MLA 也可以跑 MHA 模式,先把每个潜在向量展开成各头的键和值;DeepSeek-V3.1-Terminus 训练和预填充用 MHA 模式,解码用 MQA 模式。
我们的理解是:MQA 模式下,取出的一行只加载一次,64 个头都能复用。换成 MHA 模式,2,048 个位置里每个位置都要为每个头准备展开后的键和值,取出的数据量要乘上头数。V3.2 论文还给了一个实际原因:DSA 要在 MLA 模型上继续训练,所以把它建在 MLA 上。
短序列仍是稠密的。 位置 $t$(从 0 数起)的查询只能看到 $t + 1$ 个 token。只要这个数不超过 2,048,所有 token 都能入选,DSA 就完全等于稠密因果注意力。在 Miles 里,用不上的 top-k 槽位得分为 $-\infty$,索引变成 −1,被内核屏蔽。所以每条序列的前 2,048 个位置都是稠密注意力,索引器在这里纯属额外开销。针对短上下文的预填充,DeepSeek 还专门实现了“一种带掩码的 MHA 模式来模拟 DSA”,以提高效率。
算一个例子。 取长文档里位置 100,000 上的查询。索引器给 100,001 个可见 token(含它自己)打分;内核取出其中 2,048 行潜在向量,约 2%,64 个头都在这些行上做注意力。查询 token 自己和其他 token 一样参与竞争,但不会被强制选入。
下面的 3D 模型跟着一个查询走完这条路径。
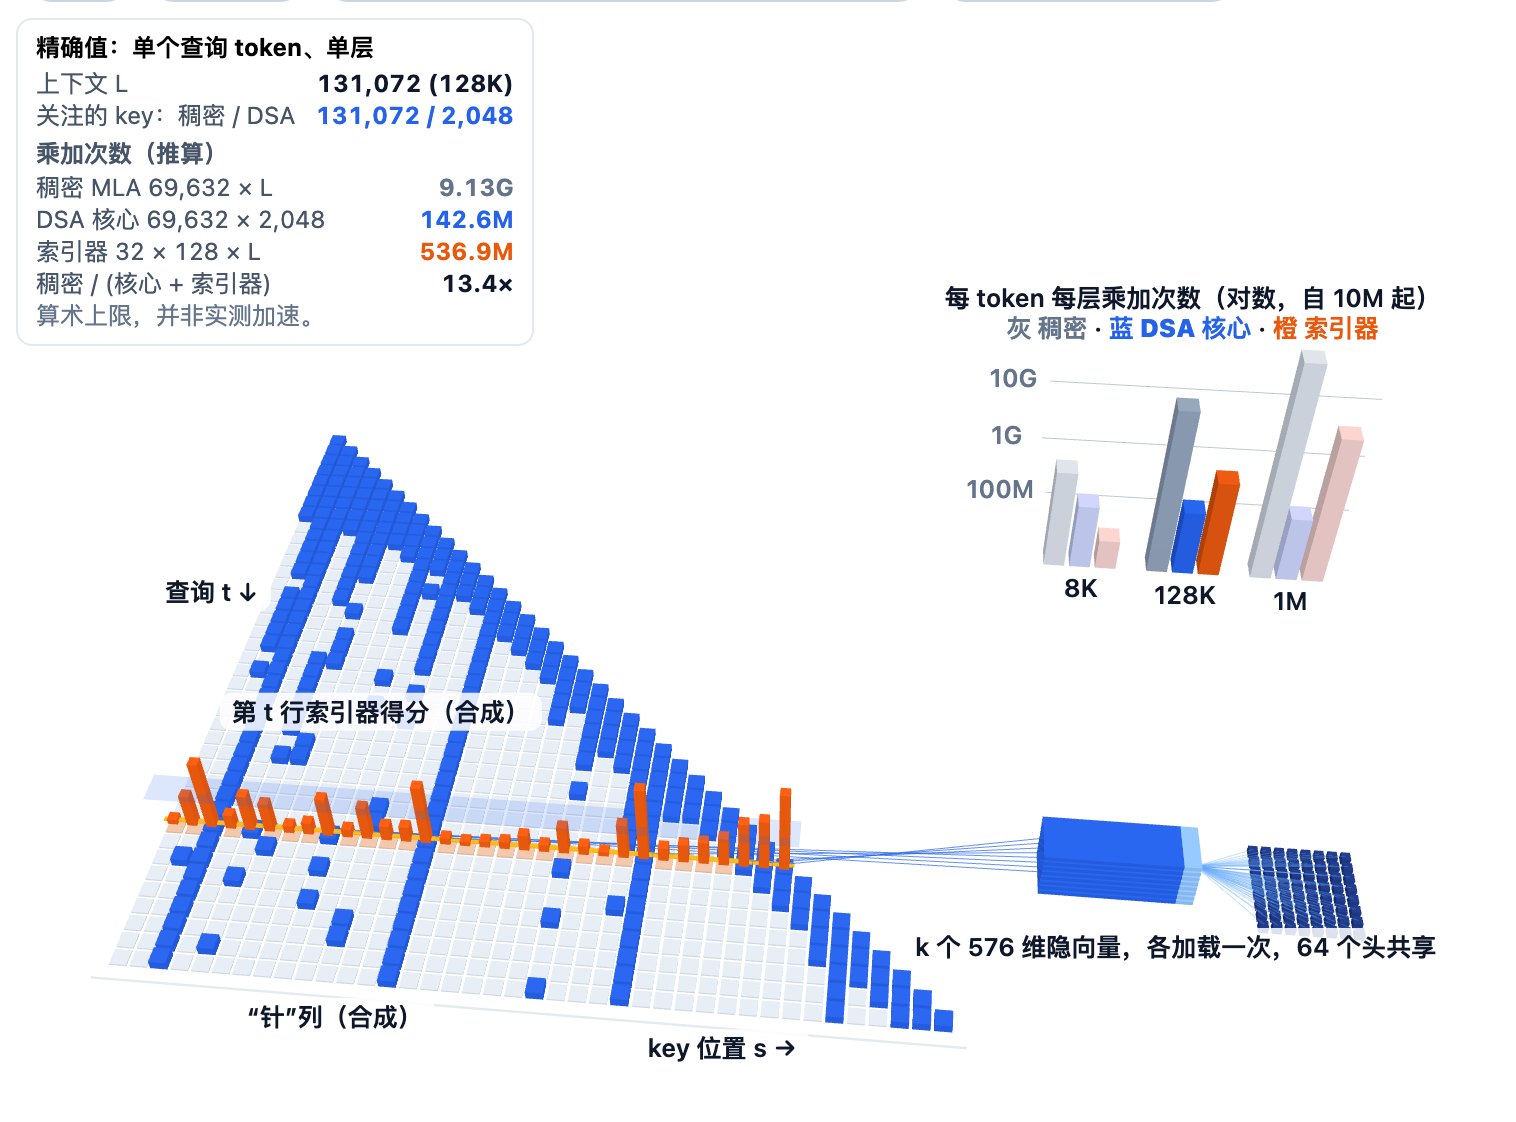
成本落在哪里。 上下文超过 2,048 之后,稀疏注意力的成本就不再变化:64 头 × 1,088 × 2,048 ≈ 1.426 亿次乘加(每层、每个查询 token)。索引器每多一个历史 token 就多 4,096 次乘加,所以在约 34,800 个 token 处反超稀疏注意力(均按配置推算):
| 上下文 $L$ | 稠密 MLA 注意力 | 索引器打分 | 稀疏注意力($k$ = 2,048) | 稠密 ÷(索引器 + 稀疏) |
|---|---|---|---|---|
| 8K(8,192) | 0.57G | 0.03G | 0.14G | 3.2× |
| 128K(131,072) | 9.13G | 0.54G | 0.14G | 13.4× |
| 1M(1,048,576) | 73.0G | 4.29G | 0.14G | 16.5× |
表中是每层、每个查询 token 的乘加次数,全部按配置推算。这些只是注意力计算量的算术上限,不是加速比。真实成本还取决于显存带宽、内核效率、批处理以及模型的其余部分。作为对照,GLM-5 报告援引 DeepSeek-V3.2 的经验,称 DSA 在长序列上把注意力计算量降低“大约 1.5–2 倍”,能“以一半的 GPU 成本处理 128K 上下文”。
这张表也暴露了问题:在 1M 处,索引器约占 DSA 注意力计算量的 97%。过了几万 token,DSA 的成本主要随这个便宜的打分器增长。§5.5 给出真实硬件上的测量,§5.6 是 GLM-5.2 的解法。
实现细节与显存流量
- Top-k。 Miles 默认后端就是普通的
torch.topk(logits, 2048);得分为 $-\infty$ 的位置变成索引 −1。另有可选的 FlashInfer 后端,带确定性开关。Miles 把index_topk = 2048写死在代码里,没有从配置读取。 - 稀疏内核。 每个头吸收后的查询宽 576,键值缓存只有一组、每行 576 宽(代码注释里的示例是 query_absorbed [96, 16, 576]、kv [96, 1, 576]:一张卡上的 16 个头共用同一组 576 宽的 KV)。TileLang 的
SparseMLA内核断言键宽 576、值宽 512,要求 top-k 数是 64 的倍数;遇到索引 −1 时加载 0、分数记为 $-\infty$,并且不给索引回传梯度。输出随后再乘 $W^{UV}$(einsum("thm,hdm->thd", out, w_vc))。 - 昇腾。 GLM-5 报告还描述了一个融合的 “Sparse Flash Attention” 内核,从 KV cache 中挑出 top-k token 并并行计算稀疏注意力。
- 解码时的显存流量(按配置推算;假设缓存为 bf16,资料没有写明)。稠密解码每层读 $L$ × 1,152 字节的潜在缓存;DSA 读 2,048 × 1,152 字节的入选潜在向量,外加 $L$ × 256 字节的索引键。8K 时少 2.1 倍,128K 时少 4.2 倍,1M 时少 4.5 倍。因为索引键本身也随 $L$ 增长,这个比值不会超过 1,152 / 256 = 4.5 倍;索引键若用 FP8,上限翻倍。我们的理解是:限制 DSA 解码收益的是索引键的大小,而不是 $k$。
- 算术。 2,048 / 1,048,576 = 0.195%;平衡点 1.426 亿 / 4,096 ≈ 34,800 个 token。两者都是我们算的。
5.4 DSA 怎么训练:先稠密预热,再稀疏训练
DSA 不是从零训练出来的。DeepSeek-V3.2 和 GLM-5 都从一个稠密 MLA 模型出发,用一段简短的继续预训练把它切换到稀疏注意力。难点在于:新初始化的索引器什么都不懂,如果马上用它随机挑出的 token,模型就会看错地方。
办法是先让索引器模仿。稠密模型其实已经“知道”哪些 token 重要,答案就写在它的注意力权重里。DeepSeek-V3.2 的配方分两个阶段。
阶段 1:稠密预热。 注意力保持稠密,除闪电索引器外所有参数都冻结。对每个查询 token $t$,把主注意力在所有头上的分数加起来,再沿序列方向做 L1 归一化,得到分布 $p_{t,:}$。索引器用 KL 散度(Kullback–Leibler divergence)损失去拟合它:
\[\mathcal{L}^{I}=\sum_t D_{\mathrm{KL}}\!\Big(p_{t,:}\;\Big\|\;\mathrm{Softmax}\big(I_{t,:}\big)\Big)\]说白了:如果 64 个注意力头合起来把 30% 的权重给了第 812 个 token、10% 给了第 40,000 个 token,索引器就会被推着给第 812 个 token 打更高的分。softmax 只出现在这个损失里;推理时分数只是拿来排序。DeepSeek 这一阶段跑了 1,000 步,每步 16 条 128K token 的序列(共 2.1B token),学习率 1e-3。
阶段 2:稀疏训练。 打开 top-k 选择,训练全部参数,让模型适应每个查询只看 2,048 个 token。索引器继续拟合 KL 目标,但只在入选集合 $S_t$(它挑出的 2,048 个位置)上计算:
\[\mathcal{L}^{I}=\sum_t D_{\mathrm{KL}}\!\Big(p_{t,S_t}\;\Big\|\;\mathrm{Softmax}\big(I_{t,S_t}\big)\Big)\]两部分各学各的信号。DeepSeek 的原话是:“我们把索引器的输入从计算图中 detach,单独优化。索引器的训练信号只来自 $\mathcal{L}^I$,主模型则只按语言建模损失优化。”阶段 2 跑了 15,000 步,每步 480 条 128K token 的序列(共 943.7B token),学习率 7.3e-6;V3.2 的后训练也同样用稀疏注意力。
我们对这种分工的理解:top-k 选择本身不可微,语言模型损失本来也教不了索引器。KL 损失教它排好序,主干则学会和挑出来的结果共处。
§5.3 的 DSA 3D 模型为这两个阶段各提供了一个模式。
GLM-5 怎么改用这套配方。 GLM-5 沿用同样的两个阶段,起点是“中期训练结束时的基座模型”,此前一直用稠密 MLA:
| DeepSeek-V3.2 | GLM-5 | |
|---|---|---|
| 起点 | V3.1-Terminus 基座,上下文已扩到 128K | 中期训练结束时(稠密 MLA) |
| 预热 | 1,000 步 × 16 × 128K ≈ 2.1B token,学习率 1e-3 | 1,000 步 × 14 × 202,752 ≈ 2.84B token,学习率 5e-3 → 2e-4 |
| 稀疏阶段 | 943.7B token,学习率 7.3e-6 | 20B token,沿用中期训练的数据和超参数,学习率恒定 1e-5 |
GLM-5 的稀疏阶段约为 DeepSeek 的 2%(按我们的计算)。报告写道:“虽然训练预算比 DeepSeek-V3.2(943.7B token)小得多,我们发现它足以让 DSA 模型追平原始 MLA 模型的表现。”
证据。 报告表 3 在 128K 上对比了 MLA 与 DSA 基座,包括两项“大海捞针”式检索测试(多查询、多值)和两个问答数据集:
| 128K 测试 | MLA | DSA |
|---|---|---|
| MQ-NIAH | 100.0 | 100.0 |
| MV-NIAH | 95.5 | 97.0 |
| SQuAD | 79.7 | 86.0 |
| HotpotQA | 66.3 | 63.0 |
大体打平,DSA 有的任务领先,有的落后。用同样的监督微调(SFT)数据训练之后,报告称“两个模型在训练损失和评测基准上打平”。
报告还说 DSA“在构造上就是无损的”。这句话应当看作作者的表述:对每个查询,top-k 选择确实丢掉了一些 token。
同一份报告里一个更小的实验,既说明了第二阶段为什么重要,也说明差距仍在哪里。GLM-4.7-Flash(30B,MLA)先做了 1,000 步只训练索引器的预热,再做 150B token 的联合训练。在 RULER 上,只做预热时 128K 掉了 7.86 分;联合训练找回了大部分,在 16K 到 64K 上反而比原模型高 0.49 到 1.72 分,但 128K 上仍落后 0.35 分。
GLM-5.3 的情况我们不知道。 没有任何资料描述 GLM-5.3 的 DSA 是怎么训练的。GLM-5.3 和 GLM-5.2 共用基座模型,而 GLM-5.2 的模型卡也没有讲它的 DSA 训练。上面的配方是 GLM-5 的。Miles 框架做的是 RL 后训练,没有复现这两种 KL 损失;它让索引器不参与 RL 更新(见 §10;GLM-5 自己的 RL 做法见 §5.7)。
数字从哪来
- DeepSeek-V3.2 配方:V3.2 论文 2.1 节(式 3、式 4,学习率、步数、token 总数)。1,000 × 16 × 131,072 ≈ 2.1B 和 15,000 × 480 × 131,072 ≈ 943.7B 与论文给出的总数一致。论文没有说明阶段 2 里 $p_{t,S_t}$ 是否在 $S_t$ 上重新归一化。
- GLM-5 配方:GLM-5 报告 2.1.1 节和附录 A(学习率调度)。预热 token 总数(1,000 × 14 × 202,752 ≈ 2.84B)和 20 / 943.7 ≈ 2.1% 是我们的算术。GLM-5 这一节没有明说预热阶段只训练索引器;报告在 GLM-4.7-Flash 实验中把“只训练索引器的预热”称为“标准 DSA 配方”。
- 表 6(RULER,GLM-4.7-Flash 加 DSA):128K 上原模型 79.21,只做预热 71.35,联合训练 150B token 后 78.86。相对原模型:16K +0.86,32K +0.49,64K +1.72,128K −0.35。
- 报告称 DeepSeek-V3.2-Exp 证明了“长上下文中 90% 的注意力条目确实是冗余的”,以及 1.5–2 倍的数字,都是 GLM-5 的说法;我们在 V3.2 论文里没有找到。
- Miles:GLM-5 和 Flash 两条路径里都没有索引器 KL 损失(索引器分数算出来、做完 top-k 就丢弃);
--freeze-indexer参数会把索引器各投影的requires_grad设为 False。
所以 DSA 每个查询只读 2,048 个 token,质量几乎不受影响。问题在于,索引器本身仍要为每个查询给全部 $L$ 个历史 token 打分,所以它还是 $O(L^2)$。在 GLM-5 和 GLM-5.1 里,78 层每层都独立跑一遍索引器。§5.5 和 §5.6 讲的就是这笔开销。
5.5 索引器何时成了瓶颈
稀疏注意力让读变便宜了:不管上下文多长,每个查询最多读 2,048 个 token。挑却依然昂贵,因为索引器每一层都要给所有历史 token 打分。按 GLM-5.3 的尺寸,§5.3 的算术把交叉点放在约 35K token 处;在一个更小的 DSA 模型上实测,趋势一致。
IndexCache 论文在一个 30B 的 DSA 模型(由 GLM-4.7-Flash 改造,47 层)上量过这件事。按图中标注读数,预填充延迟里索引器的占比从 10K token 时约 27% 涨到 200K 时约 80%;解码阶段则从约 27% 涨到约 41%。照这个读数,在 200K 时,这个“便宜”的打分器占用的预填充时间超过了模型其余部分的总和。
同一篇论文也找到了可以砍掉的浪费。比较各层选出的 2,048 个 token,相邻层有 70–100% 的选择是重合的,有些连续层还形成彼此高度重合的簇。如果第 7 层要挑的 token 和第 6 层几乎一样,第 7 层就不需要自己的索引器。
数字从哪来
- 延迟占比:IndexCache 论文引言中的性能剖析图。数值(10K/60K/120K/200K 下预填充 27/50/68/81%,解码 27/31/38/41%)是我们从 PDF 抽取出的图中文字读到的,数值与柱子的对应关系属于我们的理解。
- 重合度:IndexCache 附录 A,重合度 = T(i) ∩ T(j) 的大小除以 2,048,在 47 层模型上对 768 条 200K 长度样本取平均。最前与最后几层之间的重合度最多约 0.4。
5.6 索引共享:每四层共用一个索引器
解决办法是 GLM-5.2 引入的,GLM-5.3 原样继承。GLM-5.2 模型卡把它叫作 IndexShare;卡片链接的论文(arXiv 2603.12201,作者来自清华与 Z.ai)把同一方法叫作 IndexCache。核心思路两句话就能说完:
- 计算层(论文称 Full,记作 F;即 §1.2 表中的“计算”层)跑自己的索引器,挑出前 2,048 个 token,并把这份索引列表存进缓冲区。
- 复用层(论文称 Shared,记作 S)没有索引器,直接沿用前面最近一个 F 层的列表。
推理时这只多了“一个条件分支”。缓冲区只存当前这份索引张量,每到一个 F 层就被覆盖,所以论文说它“除了标准 DSA 已分配的显存之外,不需要额外的 GPU 显存”。
下面的 3D 模型展示复用层在整个堆叠中的位置。
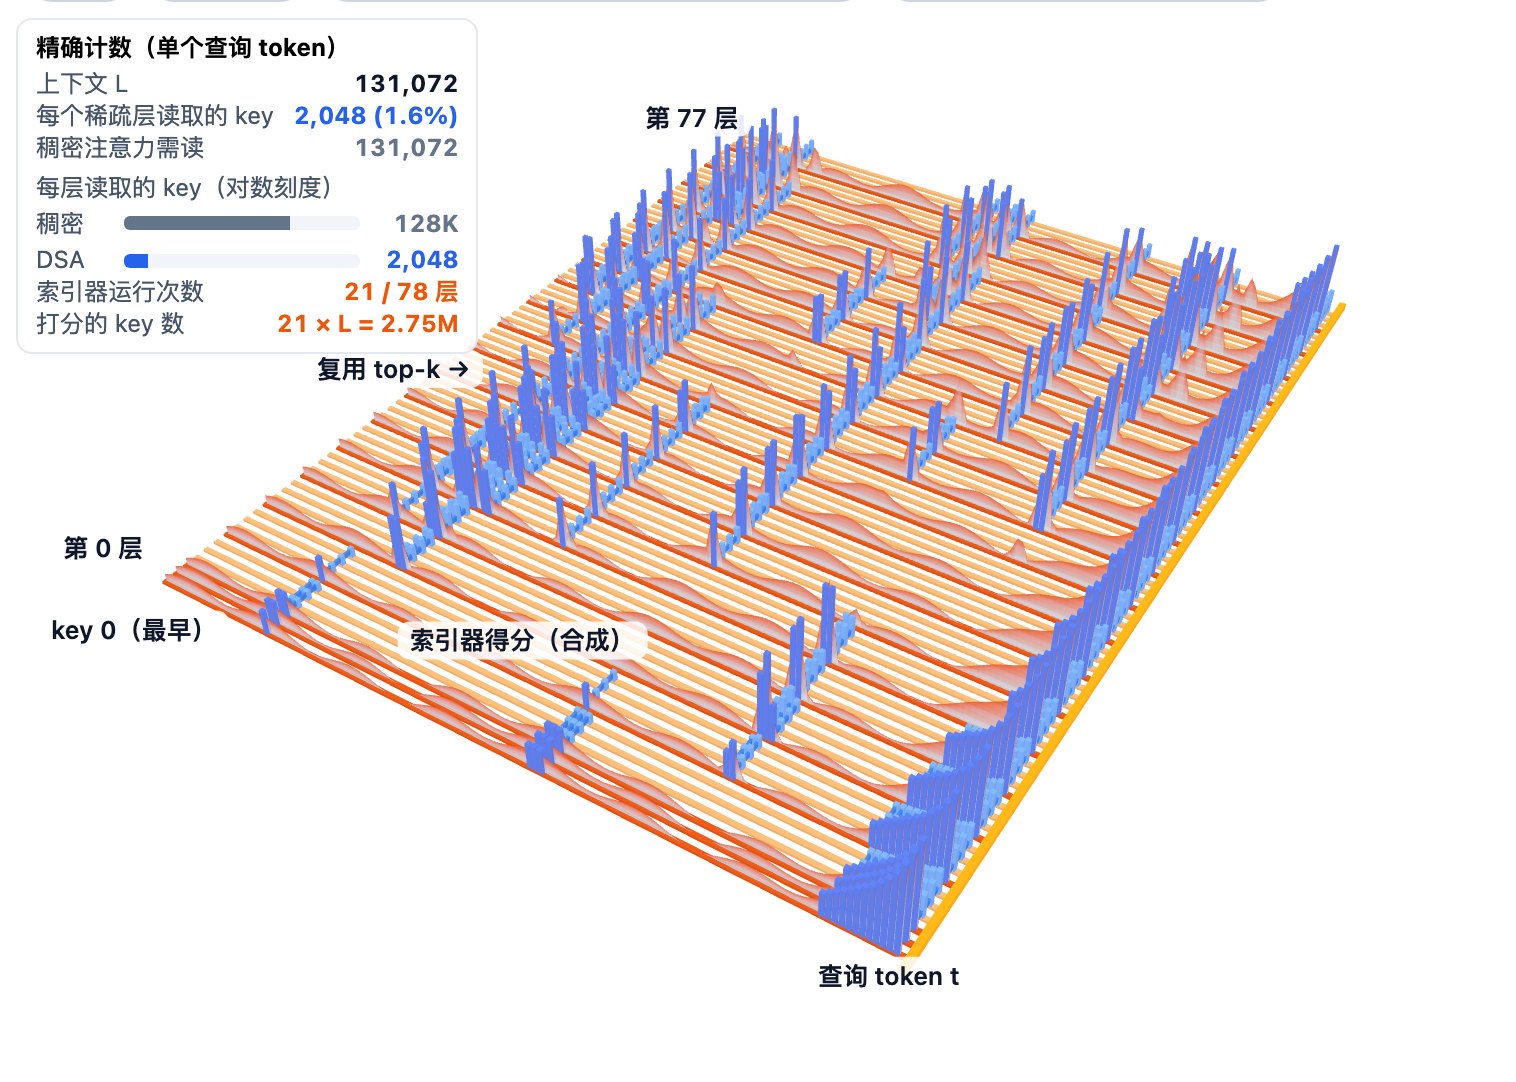
GLM-5.2 / GLM-5.3 的布局。 配置里的 indexer_types 列表套用的就是 §2.2 的规则:21 个 full 层、57 个 shared 层,用论文的 F/S 记法写作 FFFSSS,再接 18 个 FSSS。GLM-5.2 模型卡给出的收益是“在 1M 上下文长度下把每 token FLOPs 降低 2.9 倍”。这是 Z.ai 的说法,卡片没写对比基线;我们的理解是对比的是 GLM-5.1 那种每层都有索引器的做法。
S 层不只是把索引器“关掉”。GLM-5.3 的 FP8 配置只在 21 个 F 层以及第 78 层(§2 提到的 MTP 层)列出了索引器张量(例如索引键的 LayerNorm),据此看,复用层根本没有索引器参数。
论文实测了什么。 下面的数字来自 IndexCache 论文自己的模型,不是 GLM-5.2 或 GLM-5.3:
| 模型与设置 | 结果 |
|---|---|
| 30B DSA 模型,保留 1/4 索引器,200K 上下文 | 预填充 19.5 s → 10.7 s(1.82×);单请求解码 58 → 86 token/s(1.48×) |
| 744B GLM-5,免训练,保留 1/4,搜索出的层 | 长上下文平均分 78.0,完整 DSA 为 78.4 |
| 744B GLM-5,免训练,保留 1/4,均匀分布的层 | 长上下文平均分 72.7 |
| 744B GLM-5,保留 1/4,100K 以上上下文 | 预填充延迟与解码吞吐“至少 1.3×” |
| 30B,训练感知(training-aware),保留 1/4,均匀分布的层 | 长上下文平均分 50.6,完整 DSA 为 51.0 |
两行 GLM-5 数据道出了论文在免训练设置下的主要结论:“保留哪些索引器层,远比保留多少层重要。”选错了那四分之一的层,长上下文分数会掉将近 6 分。在 30B 模型上,训练感知方法能补上这个缺口:它让每个留下来的索引器去拟合自己所服务的全部层的平均注意力分布,这样即便是简单的均匀模式,也能和完整 DSA 相差不到半分。
这就引出一个资料没有回答的问题。GLM-5.2 和 GLM-5.3 用的是均匀模式,而不是论文为 GLM-5 搜索出的那两种不规则模式,尽管均匀模式在免训练设置下表现很差。我们的理解是,5.2 的基座很可能是在共享索引的条件下、按训练感知的方式训练的。但两张模型卡都没这么说,论文也只是把 GLM-5 上的训练感知 IndexCache 列为未来工作。
对参数量的影响微乎其微。去掉 57 个索引器约省 0.534B 参数(按配置推算),只占模型的约 0.07%。索引共享优化的是计算量和延迟,而不是模型大小;Flash 则用池化压低同一笔“挑选”开销(§8.5)。
实现细节
- 配置键。
index_topk_freq4 与index_skip_topk_offset3 从 GLM-5.2 开始出现,GLM-5.3 完全相同,78 项的indexer_types列表也一样。GLM-5 与 GLM-5.1 没有这些键,所以每层都跑自己的索引器。 - 流水线约束。 Miles 把共享的 top-k 存在一个按微批次(microbatch)划分、不跨流水线阶段的容器里,因此每个流水线阶段都必须从一个计算层开始。它的 GLM-5.2 脚本里最大的一种布局用 8 个流水线阶段,首阶段 14 层、末阶段 16 层,这样各阶段的起始层落在第 1、15、23、31、39、47、55、63 层(从 1 计数),全是计算层。64 卡 GB300 布局用 4 个阶段(18 / 20 / 20 / 20),起始层为第 1、19、39、59 层。
- FP8 证据。
modules_to_not_convert里的索引器条目只出现在 22 层上:21 个计算层加第 78 层(MTP)。列表里还有一个self_attn.indexers_proj张量,与 Miles 中的张量命名对不上;我们没有拿它去核对 safetensors 索引。 - 计数口径。 21 / 78 = 26.9% 和 57 / 78 = 73.1% 只算主干层。若把 MTP 层自带的索引器也算上,79 个位置中有 22 个跑索引器(27.8%)。
- 含义未公开的键。
index_topk_pattern为null,index_share_for_mtp_iteration为true;我们手头的资料都没有解释它们(见 §6)。
5.7 写给 RL 的脚注:top-k 必须是确定性的
6. 长上下文、MTP 与 FP8 打包
GLM-5.3 和最初的 GLM-5 之间还有三处不同:上下文窗口扩大到原来的五倍多,投机解码用的草稿层更好了,权重改用 8 位浮点发布。前两项是 GLM-5.2 带来的;第三项只是打包方式的选择,架构本身没动。
| GLM-5 / GLM-5.1 | GLM-5.2 / GLM-5.3 | |
|---|---|---|
max_position_embeddings |
202,752 | 1,048,576 |
rope_theta |
1,000,000 | 8,000,000 |
rope_scaling / YaRN |
无 | 无(rope_type 为 “default”) |
MTP 层数(num_nextn_predict_layers) |
1 | 1 |
index_share_for_mtp_iteration |
无此键 | true |
quantization_config |
无此键 | 仅 GLM-5.3:FP8 e4m3 |
6.1 一百万 token
表中前两行在 GLM-5.2 一起变化:窗口增长到 1,048,576($2^{20}$,“1M”)个位置,提高 5.17 倍(推算),旋转基数提高到 8 倍,且没有 rope_scaling 项。我们的理解是,这就是单纯放大基频:基数越大,那 64 个 RoPE 维度(§3.3)旋转得越慢,相隔很远的位置仍然分得开。GLM-5.2 模型卡的说法是:模型依托“扎实的 1M token 上下文”,具备长程任务能力。
模型怎样学会用好这个窗口,资料里没有记载。最接近的公开配方是 GLM-5 的中期训练,它分三个阶段扩展上下文:先 32K(1T token),再 128K(500B token),最后 200K(50B token)。我们手头的资料里,找不到对应 1M 的训练阶段。
6.2 多 token 预测
MTP 额外加一个小层,用来猜接下来的几个 token。推理时,这些猜测作为投机解码的草稿:主模型一次前向就能验证多个草稿 token,留下它认同的那些。GLM-5.3 有一个这样的层,即检查点里的第 78 层,结构见 §2。
GLM-5 在训练时让三个 MTP 步共享参数。报告称,这让草稿模型的显存开销保持在 DeepSeek-V3 的水平,同时平均接受长度超过 DeepSeek-V3.2(细节见下)。
GLM-5 训练 MTP 的技巧
GLM-5 报告讲了它训练 MTP 的技巧。DeepSeek-V3 只训练一个 MTP 层,推理时却用它预测两个 token,这种训练与推理的不一致会拉低第二个 token 的接受率。GLM-5 改为在训练时让三个 MTP 步共享参数。草稿模型的显存占用和 DeepSeek-V3 一样小,接受率却更高:在一组私有提示上做 4 步投机,GLM-5 的平均接受长度是 2.76,DeepSeek-V3.2 是 2.55。
GLM-5.2 的模型卡补充说,它改进了 MTP 层,“把接受长度提高了最多 20%”。配置上看不出结构变化:MTP 层仍然只有一个。唯一新增的 MTP 相关键是 index_share_for_mtp_iteration,值为 true。我们的理解是,5.2 的提升主要来自训练;这个开关可能让 MTP 层在多个草稿步之间复用同一份索引器选择。模型卡和 Miles 都没有解释这个开关,所以这两点都只是推测。
6.3 FP8 打包
GLM-5.3 唯一实质性的配置变化是 quantization_config 块,它描述了一个 FP8 检查点:
- 格式: FP8 e4m3(4 位指数,3 位尾数)。
- 权重: 按 128 × 128 分块量化,每块有自己的缩放系数。
- 激活: 运行时动态量化(
activation_scheme为 “dynamic”)。 - 保留高精度:
modules_to_not_convert中的 541 项。
例外的都是体量小或对精度敏感的部分:归一化层、MoE 路由器门控及其专家偏置、词嵌入、lm_head,以及若干 MTP 和索引器张量(下方实现细节逐一列出)。真正占体积的部分都是 FP8,包括注意力投影、索引器的查询与键投影(wq_b、wk)、稠密 MLP 和全部专家。这改变的是存储和推理成本,网络本身不变:层数、形状、索引共享布局都一样。
实现细节
- 541 项怎么数。 3 项不属于任何层(
lm_head、model.norm、model.embed_tokens)。第 0–78 层(含 MTP)每层 4 个归一化层(input_layernorm、post_attention_layernorm、q_a_layernorm、kv_a_layernorm)。第 3–78 层这 76 个 MoE 层各有路由器mlp.gate与e_score_correction_bias。22 个带索引器的层各有 3 个索引器条目(§5.6)。另有 4 项只属于 MTP 层(eh_proj、enorm、hnorm、shared_head.norm)。 - 对应哪个仓库。 我们读到的 GLM-5.3 配置带有这个 FP8 块,而 GLM-5.2 模型卡的
new_version字段指向一个名为zai-org/GLM-5.3-BF16的仓库。每个文件究竟来自哪个 Hugging Face 变体没有记录;我们还尝试单独获取 GLM-5.3-FP8 的配置文件,但下载失败,拿到的文件无效。 head_dim64 → 192。 这个键在 GLM-5.2 中变了。GLM-5 里它等于注意力头的 RoPE 部分(64);5.2 和 5.3 里它等于 NoPE 部分(192)。MLA 的维度本身(qk_nope_head_dim192、qk_rope_head_dim64、v_head_dim256)没变,参数量不受影响。我们把它当作元数据,不做过度解读。- 路由器精度。 GLM-5.2 还加了
moe_router_dtypefloat32(§4),这与路由器门控不转 FP8 是一致的。
7. 架构没变,GLM-5.3 的提升从哪里来?
§2–6 讲的网络,GLM-5.3 原封不动地继承自 GLM-5.2。那到底什么变好了?Z.ai 的回答很简短:权重变了,靠的是更多、更好的后训练。本节细读模型卡里的评测表,列出这张表自带的注意事项,再概述 GLM-5 系列后训练流程中最接近的公开描述。
模型卡说,相对 GLM-5.2 的所有提升都来自后训练。卡中声称在内部的 Z.ai Code Bench 上比 GLM-5.2 提升 50%,外部无法复现;并称在 Terminal Bench 3.0 和 Agents’ Last Exam 上达到开源 SOTA。卡里还写了一段“涌现的网络安全能力”:“As we scaled post-training, cyber capability developed faster than we expected.”(随着后训练规模扩大,网络安全能力的增长比我们预期得更快。)
7.1 评测表告诉了我们什么
下表摘自 GLM-5.3 模型卡 中 GLM-5.3 与 GLM-5.2 两列。“变化”一列是我们自己做的减法。最后一列是卡中另外六个对比模型(Kimi K3、DeepSeek-V4 Pro-0813、Qwen3.8-Max、Opus 4.8、Fable 5(w/ fallback)、GPT-5.6 Sol)里的该行最高分。GLM-5.3 在全部八个模型中排第一的行用粗体标出。
| 评测(沿用卡中名称) | GLM-5.2 | GLM-5.3 | 变化(推算) | 该行其他模型最高分 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 81.0 | 88.2 | +7.2 | GPT-5.6 Sol,88.8 |
| Terminal Bench 3.0 | 4.6 | 28.3 | +23.7 | GPT-5.6 Sol,34.6 |
| DeepSWE (v1.1) | 46.2 | 66.9 | +20.7 | GPT-5.6 Sol,72.7 |
| NL2Repo | 48.9 | 58.0 | +9.1 | Opus 4.8,69.7 |
| ProgramBench (Almost Solved) | 9.5 | 19.0 | +9.5 | Fable 5,33.0 |
| FrontierSWE | 67.5 | 78.1 | +10.6 | Fable 5,88.2 |
| SWE-Marathon (v1.1) | 19.4 | 42.5 | +23.1 | Opus 4.8,48.8 |
| PostTrainBench | 31.7 | 39.8 | +8.1 | Fable 5,41.8 |
| CyberGym | 77.2 | 84.5 | +7.3 | Fable 5,83.8 |
| ExploitGym (2h / 6h) | 29 / 39 | 105 / 130 | +76 / +91 | GPT-5.6 Sol,216 / 293 |
| ExploitBench | 24.4 | 54.4 | +30.0 | Fable 5,78.0 |
| Toolathlon Verified | 59.9 | 73.0 | +13.1 | Kimi K3,76.5 |
| AutomationBench (v1.0.6) | 26.2 | 48.2 | +22.0 | Kimi K3,46.7 |
| Agents’ Last Exam (ALE-CLI) | 23.8 | 28.5 | +4.7 | GPT-5.6 Sol,28.6 |
| HLE w/ Tools | 54.7 | 62.5 | +7.8 | GPT-5.6 Sol,64.5 |
| GDPval-AA v2 | 1,508 | 1,769 | +261 | Fable 5,1,743 |
GLM-5.3 在全部 16 行上都超过 GLM-5.2。相对提升最大的(倍数是我们算的)集中在长程智能体任务和安全领域:Terminal Bench 3.0 约 6 倍,ExploitGym(2 小时预算)约 3.6 倍,SWE-Marathon 和 ExploitBench 约 2.2 倍,ProgramBench 2 倍,AutomationBench 约 1.8 倍。
这与模型卡的两条主打宣传一致:长程编码更强;漏洞利用类评测上“more than doubles GLM-5.2”(达到 GLM-5.2 的两倍以上)。
放到全场对比里看,结论要克制一些。八个模型中,GLM-5.3 只在三行拿到第一:CyberGym、AutomationBench 和 GDPval-AA v2。模型卡“开源 SOTA”的说法建立在两个评测上,而在这两个评测上都有闭源模型得分更高:Terminal Bench 3.0 上 Fable 5(33.7)和 GPT-5.6 Sol(34.6)都高于 GLM-5.3 的 28.3,Agents’ Last Exam 上 GPT-5.6 Sol 也以 28.6 对 28.5 略胜。所以“开源”这个限定词是关键;表格支持的是原话,而不是“全场最佳”。
数字从哪来
- 所有分数抄自 GLM-5.3 模型卡的评测表,卡中粗体表示该行最高分。“变化”列、倍数和“其他模型最高分”列都是我们基于这张表的计算。
- 各行单位并不统一。GDPval-AA v2 不是百分比(分数在 1,500–1,800 一带);ExploitGym 在 869 个任务上给出两个数,分别对应 2 小时和 6 小时两档时间预算。我们只在同一行内做减法。
- 评测设置因行而异,来自卡中脚注。好几行(Terminal Bench 2.1、Terminal Bench 3.0、CyberGym、ExploitGym、ExploitBench、PostTrainBench、SWE-Marathon)是把 GLM-5.3 放在 Claude Code 2.1.207 里跑的。Terminal Bench 3.0 使用 400K 上下文、128K 最大输出、avg@3(每个任务跑三次取平均)、最多 600 轮、10 小时超时。CyberGym 是 1,507 个任务上的单次 Pass@1(每个任务只尝试一次),每题不限时,并设置域名白名单。FrontierSWE 由 Proximal 评测,dominance 分数(相对于其他参评模型的相对分数)截至 2026/08/14。
7.2 引用这些数字之前要注意的事
另外三点小提醒:
- 主打的编码数字来自内部评测。 Z.ai Code Bench 上的 50% 提升,没有公开的任务集。
- 单次运行。 CyberGym 和 ExploitGym 报告的都是单次 Pass@1,跑多次的波动有多大并不清楚。
- 评测项换了一批。 GLM-5.3 卡片去掉了 GLM-5.2 的若干行,包括纯推理和数学行,也没有说明 5.3 在这些行上的表现(详见下方)。
主要的跨卡差异
两张卡一致的 GLM-5.2 分数:Terminal Bench 2.1(81.0)、DeepSWE(46.2)、NL2Repo(48.9)、HLE w/ Tools(54.7)。不一致的如下(GLM-5.2 卡 → GLM-5.3 卡):
| 评测 | GLM-5.2 卡 | GLM-5.3 卡 | 可能原因(我们的理解) |
|---|---|---|---|
| FrontierSWE | 74.4 | 67.5 | dominance 是相对分数,日期分别为 2026/06/16 和 2026/08/14,新模型加入后会变化 |
| PostTrainBench | 34.3 | 31.7 | 协议不同:5.3 卡为自行评测,失败的运行回退到零样本基线分 |
| SWE-Marathon | 13.0 | 19.4 | 5.3 卡使用 v1.1 |
| ProgramBench | 63.7 | 9.5 | 指标不同(5.3 卡为“Almost Solved”) |
| Tool-Decathlon → Toolathlon Verified | 48.2 | 59.9 | 5.3 卡报告的是改名或重新校验后的版本 |
另有两点,同样是我们的理解。Terminal Bench 2.1 的“一致”只是数值相同:81.0 在 GLM-5.2 卡里是 Terminus-2 那一行,而 5.3 卡说它的 Terminal Bench 2.1 是在 Claude Code 里跑的。5.3 卡还去掉了 5.2 卡里的 MCP-Atlas、CritPt 和 IMOAnswerBench。
和 GLM-5.2 卡相比,GLM-5.3 卡去掉了纯推理、数学类各行以及 SWE-bench Pro,新增 Terminal Bench 3.0、三个网络安全评测、AutomationBench、Agents’ Last Exam 和 GDPval-AA v2。我们的理解是后训练的重心转向了智能体、长程任务和安全方向。
7.3 对这个系列来说,“后训练”指什么
Z.ai 没有发布 GLM-5.3 技术报告,外界无从知道它的确切训练配方。最接近的公开文档是 GLM-5 技术报告,GLM-5.3 和 GLM-5.3-Flash 的模型卡都引用了它。下面讲的是这个系列公开过的配方,不能据此断定 GLM-5.3 就是这样训练的。GLM-5 的后训练分五个阶段:SFT、推理 RL、在一万多个可验证的软件工程与终端环境上的智能体 RL、通用 RL,以及在线策略跨阶段蒸馏(让后面的阶段不冲掉前面学到的能力)。
GLM-5 后训练五个阶段的细节
- 监督微调(SFT)。 多任务数据,覆盖通用对话、推理、编码与智能体任务,上下文最长 202,752 个 token。模型学会三种思考模式:交错思考(每次回复和工具调用前都先思考)、保留思考(编码智能体场景里跨轮保留之前的思考块)、轮级思考(按轮开关思考)。智能体轨迹中出错的步骤保留在数据里,但不计入损失。
- 推理 RL。 用 GRPO(Group Relative Policy Optimization)加 IcePop 做 RL,覆盖数学、科学、代码和工具集成推理。IcePop 会丢弃训练与推理概率之比落在 $[1/\beta, \beta]$ 之外的 token,其中 $\beta = 2$;裁剪区间为 $\epsilon_{\text{low}} = 0.2$、$\epsilon_{\text{high}} = 0.28$。
- 智能体 RL。 完全异步的 RL,环境包括一万多个可验证的软件工程与终端环境,以及多跳搜索任务。token 进、token 出(TITO)网关避免重新分词带来的不一致;双边重要性采样会屏蔽与 rollout 策略之比超出 $[1-\epsilon_l, 1+\epsilon_h]$ 的 token。
- 通用 RL。 结合规则奖励、结果奖励模型和生成式奖励模型,并用人工撰写的回答作为风格锚点。
- 在线策略跨阶段蒸馏。 以前面各阶段的最终检查点为教师,防止后面的阶段冲掉前面学到的能力。
直白地说:取 $\beta = 2$ 时,推理引擎采样时给某个 token 一个概率 p;训练引擎重算出的概率必须落在 p/2 到 2p 之间,这个 token 才能通过 IcePop 过滤。超出区间的视为训推不一致,不贡献梯度。
§5.7 的两项 RL 保护措施,即冻结索引器和确定性 top-k,正出自这套配方,把它和架构联系起来。我们的理解是:除了 MoE 路由,稀疏注意力又引入了一个“路由”决策,RL 必须让它保持稳定。
GLM-5.3 卡强调的方向(终端操作、长达数小时的软件任务、漏洞利用链)与智能体 RL 阶段及其环境扩展是对得上的。这种对应是我们的解读,卡里只说提升来自扩大规模的后训练。想了解开源框架里这些机制怎么落地(TITO、路由重放、重要性采样修正、完全异步训练),可以看我们之前的 Miles 深度解析。
8. GLM-5.3-Flash:全新的混合架构,而不是缩小版 GLM-5.3
GLM-5.3-Flash 和 GLM-5.3 共用名字、词表和发布日期,却是另一套架构。本节回答一个问题:为了便宜地服务长上下文,Z.ai 从头设计模型时改了什么?简短的答案是:大多数层不再维护一份越来越长的注意力缓存,改用一块大小固定的小记忆;每四层中保留一层精确的稀疏注意力,负责精准查找。
模型卡把这次另起炉灶说得很直白:Flash “starts from a newly trained base model”(从全新训练的基座模型出发),并且 “for the first time in the GLM series”(在 GLM 系列中第一次)采用 “a hybrid architecture combining sparse and linear attention”(稀疏注意力与线性注意力结合的混合架构)。它还 “adopts Manifold-Constrained Hyper-Connections (mHC)”,预训练用的是 Z.ai “latest 30T-token multimodal pre-training corpus”(最新的 30T token 多模态预训练语料)。模型卡给出的参数量是总参数 320B、激活参数 18B。
Miles 文档用工程语言说了同一件事:Flash “is a different architecture from the 744 B GLM5 and GLM5.2 flagships, not a smaller cut of them”(与 744B 的 GLM5、GLM5.2 旗舰是不同的架构,不是从它们裁出来的小号)。
8.1 层布局:三层 KDA,接一层 DSA
Flash 有 45 层 Transformer(GLM-5.3 是 78 层),隐藏维度也更窄(4,096,GLM-5.3 是 6,144)。两种注意力按固定节奏交替:
- KDA:一种带固定大小记忆的线性注意力,共 34 层。
- DSA,即 GLM-5.3 的稀疏注意力(§5),共 11 层。索引器仍为每个查询挑 2,048 个 token,但这里它给每 4 个 token 一组的池化块打分(§8.5)。
排布是 [KDA, KDA, KDA, DSA] 重复 11 次,得到 44 层,最后再接一层 KDA(第 44 层)。DSA 位于第 3、7、11、…、43 层,也就是层号除以 4 余 3 的那些层。每个四层块内是 3:1,整个堆栈是 34:11。
FFN 一侧沿用 GLM-5.3 的做法,第 0–2 层稠密、之后都是 MoE,所以第 3 层既是第一个 DSA 层,也是第一个 MoE 层。
| 层 | 注意力 | FFN |
|---|---|---|
| 0、1、2 | KDA | 稠密(12,288) |
| 3、7、11、…、43(11 层) | DSA:NoPE MLA + 池化索引器 | MoE |
| 4–6、8–10、…、40–42,以及 44(31 层) | KDA | MoE |
| 45(MTP,额外一层) | DSA,带自己的索引器 | MoE |
这个堆栈外面还包着两样东西。mHC 把残差通路拓宽成 4 路,在每层的两个子层处各混合一次,共 90 个混合点(§8.6)。表中的 MTP 层(第 45 层)在检查点的参数名单里没有 mHC 参数,我们的理解是它没有被 mHC 包裹;Miles 训练时直接去掉了它。
想逐层走一遍这个堆栈,可以把 §2.2 的层堆叠 3D 模型切到 Flash 模式。
数字从哪来
- Flash
config.json的text_config.layer_types有 34 个"linear_attention"和 11 个"deepseek_sparse_attention";linear_attn_config.kda_layers与linear_attn_config.full_attn_layers重复了同样的划分(DSA =[3, 7, …, 43])。 - Miles(
miles_plugins/models/glm5_next/glm5_next.py里的full_attn_layers())先读full_attn_layers,没有就退回layer_types,再没有就默认i % 4 == 3。集合内的层用Glm5NextDSAAttention,其余层用Glm5NextKDAAttention。 - FFN 类型:
first_k_dense_replace = 3,mlp_layer_types= 3 个"dense"+ 42 个"sparse",intermediate_size = 12288。 - MTP:
num_nextn_predict_layers = 1。FP8 跳过名单(quantization_config.modules_to_not_convert)里有model.layers.45.*,包含self_attn.indexer.*、kv_b_proj、mlp.gate和eh_proj/enorm/hnorm,但没有hc_attn_*/hc_ffn_*;第 0–44 层都有。 - Miles 文档(
docs/models/glm/glm5-3-flash.md):“MTP is dropped for training.”
8.2 KDA:记忆大小固定的线性注意力
普通的 softmax 注意力要留住所有历史 key 和 value,每来一个 token,缓存就多一条,永不停止。KDA 则为每个头只留一个小矩阵,相当于一本大小固定的笔记本,每来一个 token 就原地改写一次。读这本笔记本,第 10 个 token 和第 1,000,000 个 token 的开销一样。下面的动画对比了这两种方式。

KDA 出自月之暗面(Moonshot AI)的 Kimi Linear 论文(arXiv 2510.26692)。它是一条短演化链的最后一环:线性注意力 → delta 规则 → 遗忘门 → 更细的遗忘门。下面几个小节逐步走完这条链,再讲 Flash 中完整的 KDA 层、它怎么训练、怎么解码,以及 Flash 为什么把它和 DSA 混在一起用。
8.2.1 线性注意力:用状态代替缓存
softmax 注意力拿当前 query $q_t$ 和每个历史 key $k_i$ 打分,归一化后对 value $v_i$ 加权平均。softmax 把所有历史 token 耦合在一起,所以它们必须全部留在内存里。
去掉 softmax,求和就能拆开:输出变成 $o_t = \sum_{i \le t} (q_t^\top k_i)\, v_i = S_t^\top q_t$,其中 $S_t = \sum_{i \le t} k_i v_i^\top$。整段历史被压缩进一个 $d_k \times d_v$ 的矩阵 $S_t$,每个 token 只需往里加一个外积:
\[S_t = S_{t-1} + k_t v_t^\top, \qquad o_t = S_t^\top q_t\]说白了,$S$ 就是一个 key-value 存储器。写入时把 $v_t$ 存在方向 $k_t$“下面”;读取时,query 取回存在相近方向下的 value。Flash 中 $d_k = d_v = 128$,每个头的记忆就是 16,384 个数,与序列长度无关。
毛病在于这个存储器只加不减。它从不擦除,而 128 维的 key 空间最多只容得下 128 个互相正交的 key。写入几千次之后,每次读出的都是许多 value 混在一起的模糊总和。Kimi Linear 论文对朴素线性注意力的评价是:没有判断该擦除哪些记忆的准则(“no criterion for which memories to erase”),状态会无限增长(“grows unbounded”)。
8.2.2 delta 规则:只写误差
delta 规则专治“只加不减”。写入之前,先问记忆对这个 key 当前会返回什么:$\hat v_t = S_{t-1}^\top k_t$。然后只写入目标与预测之差,再乘上写入强度 $\beta_t \in (0, 1)$:
\[S_t = S_{t-1} + \beta_t\, k_t \left(v_t - S_{t-1}^\top k_t\right)^\top = \left(I - \beta_t k_t k_t^\top\right) S_{t-1} + \beta_t k_t v_t^\top\]这相当于对重建误差 $\tfrac12 \lVert S^\top k_t - v_t \rVert^2$ 做一步梯度下降,$\beta_t$ 就是学习率。这正是 DeltaNet 的更新规则;Kimi Linear 论文也用同样的梯度下降视角来解释朴素线性注意力。
看一个小例子。取 $d_k = 2$,value 只有一个数,于是 $S$ 是两个数组成的一列,初始为零。
| 步骤 | 写入(key → value) | 线性注意力的 $S$ | delta 规则的 $S$($\beta = 1$) |
|---|---|---|---|
| 1 | $(1, 0) \to 3$ | $(3, 0)$ | 预测 0,误差 3:$(3, 0)$ |
| 2 | $(1, 0) \to 5$(事实变了) | $(8, 0)$ | 预测 3,误差 2:$(5, 0)$ |
| 3 | $(0.6, 0.8) \to 1$ | $(8.6, 0.8)$ | 预测 3,误差 −2:$(3.8, -1.6)$ |
第 2 步之后用 $(1, 0)$ 查询:线性注意力返回 8,是旧事实和新事实之和;delta 规则正好返回 5。若 $\beta = 0.5$,delta 规则只走一半,变成 4。
第 3 步之后,delta 规则对新 key 正好返回 1($0.6 \times 3.8 - 0.8 \times 1.6 = 1$)。旧事实从 5 漂到 3.8,因为两个 key 有重叠。有限的记忆仍然会相互干扰;当 $\beta = 1$ 时,delta 规则保证最新一次写入是准确的;$\beta$ 更小时它只走一部分路,但误差仍不会像简单累加那样越堆越多。
为什么这个更新是稳定的
- KDA 对每个 key 做 L2 归一化,所以 $\lVert k_t \rVert = 1$。此时 $I - \beta_t k_t k_t^\top$ 在 $k_t$ 方向上的特征值是 $1 - \beta_t$,其他方向都是 1:它只在正在写入的 key 方向上收缩记忆,任何方向都不会放大。论文说 L2 归一化是为了保证特征值稳定(“to ensure eigenvalues stability”)。
- Kimi Linear 论文指出,这种秩 1 更新“equivalent to a generalized Householder transformation”(等价于广义 Householder 变换),并且“supports hardware-efficient chunkwise parallelization”(支持硬件友好的分块并行,见 §8.2.5)。
- 朴素线性注意力相当于对无界目标 $-\langle S^\top k_t, v_t \rangle$ 做梯度下降,这解释了它为什么从不擦除。
8.2.3 门控:从每头一个衰减到每通道一个衰减
delta 规则会修正被问到的事实,但从不遗忘其他东西。Gated DeltaNet(GDN,即 §5.1 消融里的那种线性注意力层)加了一个遗忘门:每次写入前,整个状态先乘上一个由当前 token 算出的标量 $\alpha_t \in [0, 1]$。也就是每个头只有一个衰减速度。论文把它理解为对记忆做权重衰减。
KDA 把这个标量换成向量 $\alpha_t \in [0, 1]^{d_k}$,每个 key 通道各有一个衰减速度。下面是论文发表的 KDA 更新式(论文式 1),对每个头:
\[S_t = \left(I - \beta_t k_t k_t^\top\right) \operatorname{Diag}(\alpha_t)\, S_{t-1} + \beta_t k_t v_t^\top, \qquad o_t = S_t^\top q_t\]从右往左读。$\operatorname{Diag}(\alpha_t)$ 让 $S$ 的 128 行(每行对应一个 key 通道,由全部 128 个 value 列共用)各按自己的系数衰减。接着 $(I - \beta_t k_t k_t^\top)$ 擦掉衰减后的记忆对 $k_t$ 给出的内容,$\beta_t k_t v_t^\top$ 再把新 value 写到这个 key 下面。当 $\beta_t = 1$ 且 $k_t$ 为单位长度(KDA 会对 key 做归一化)时,更新后用 $k_t$ 查询正好返回 $v_t$,不管衰减做了什么:擦除这一步会清掉沿 $k_t$ 方向存储的全部内容。
为什么要逐通道?论文给的理由是精度:GDN 和 Mamba2 一样用的是粗粒度的逐头遗忘门(“coarse head-wise forget gate”),而逐通道门控能更精细地调控有限状态的 RNN 记忆(“more precise regulation of the finite-state RNN memory”)。一个头可以让部分通道长期保存远处的事实,让另一些通道每隔几个 token 就换一批内容。论文还把这种门控解读为一种可学习、依赖数据的位置编码,这也是 Kimi Linear 自己的全注意力层去掉 RoPE 的原因;Z.ai 没有说明 Flash 为什么也这样做(§8.3)。
GLM-5.3-Flash 中的门控公式(按 fla 的计算方式)。 fla(flash-linear-attention)是一个开源 kernel 库,Miles 调用的 KDA kernel 都来自它。对每个头 $h$、每个通道 $c$,层先通过低秩投影(4,096 → 128 → 8,192)得到原始门控值 $f_t$。Miles 调用 fla 的 fused_kda_gate 并传入 lower_bound = -5,把它变成对数空间的衰减 $g$,状态再乘以 $\alpha = e^{g}$:
其中 $\sigma$ 是 sigmoid,$A_h$ 是学到的 A_log(每个头一个),$b_{h,c}$ 是学到的 dt_bias(每个头、每个通道一个)。sigmoid 严格落在 0 和 1 之间,所以 $g \in (-5, 0)$,$\alpha \in (e^{-5}, 1) \approx (0.0067, 1)$。
这就是下界 −5 的含义:每来一个 token,一个通道保留的内容在 0.67% 到 100% 之间。它可以衰减得很快,但单个 token 无法把它清成恰好为零。fla 的默认门控 $-e^{A_h}\,\mathrm{softplus}(f + b)$ 没有这个下限。
说白了,长记忆要求 $\alpha$ 非常接近 1,也就是 sigmoid 输出接近 0(由公式推算;训练后的实际取值不在我们的资料里):
| 每个 token 的保留系数 $\alpha$ | 半衰期(token 数) | 所需的 sigmoid 输出 |
|---|---|---|
| 0.0067(下限) | 不到 1 | → 1 |
| 0.082 | 不到 1 | 0.5(原始输入为 0) |
| 0.99 | 约 69 | 0.002 |
| 0.999 | 约 693 | 0.0002 |
| 0.9999 | 约 6,931 | 0.00002 |
半衰期等于 $\ln 0.5 / \ln \alpha$。第二行是中性点:$A_h = 0$(Miles 的初始值)且 $f + b = 0$ 时,$g = -2.5$,$\alpha \approx 0.082$。
实现细节
- 门控代码:fla commit 8024667ab58f 中的
ops/kda/gate.py。给定下界时,Triton kernel 计算lower_bound * sigmoid(exp(A_log) * (g + dt_bias)),否则计算-exp(A_log) * softplus(g + dt_bias)。Miles 只要求 fla ≥ 0.4.2,没有锁定 commit,所以 GLM 训练时用的确切版本并不确定。 - fla 中
chunk_kda的文档字符串写道:下界会“naturally clamps the output to[lower_bound, 0)”(自然地把输出限制在[lower_bound, 0));“Recommended value:-5(i.e., per-step decayexp(-5) ≈ 0.0067)”。它的safe_gate=True选项还会启用“M=16 TensorCore acceleration”。Miles 在 kernel 外计算门控,没有传safe_gate。 - fla 参考递推(
ops/kda/naive.py)的运算顺序:先按行把 $S$ 乘以 $e^{g}$,再用衰减后的状态做预测,然后写入 $\beta_t k_t (v_t - S^\top k_t)^\top$,最后用缩放了 $1/\sqrt{128}$ 的 $q_t$ 读出(fla 的默认缩放)。把写入项展开,正好是论文的式 1。 - 论文只说衰减函数是“a decay function $f(\cdot)$ similar to those used in GDN and Mamba”(与 GDN、Mamba 类似的衰减函数),没有给出下界。−5 来自 Flash 配置(
gate_lower_bound)和 fla。 - Z.ai 没有解释为什么选 −5。在 Miles 中,这个下界只影响模型本身:它给每个 token 的遗忘程度设了下限,而 kernel 并不知道这个下界,因为 Miles 没有传入
safe_gate。fla 的文档字符串把这个下界和“M=16 TensorCore acceleration”联系在一起。我们的理解:当 $g \ge -5$ 时,16 个 token 的累积对数衰减不小于 −80,于是 $e^{\pm 80}$(约 $10^{\pm 35}$)落在 fp32 的表示范围内(上限约 $e^{88.7}$)。这样 kernel 就能把 16-token 的小块分解成普通的矩阵乘法。代码只写了截断和加速,没有写这层推理。
8.2.4 GLM-5.3-Flash 中完整的 KDA 层
Flash 的 34 个 KDA 层各有 64 个头,$d_k = d_v = 128$。更新规则外面围着一圈小投影,Miles 的 kda.py 与 Kimi Linear 的设计逐项对应。对一段 $T$ 个 token 的序列:
- 投影。 三个线性层把隐藏状态 $[T, 4096]$ 映射成 query、key、value,各为 $[T, 8192]$(64 个头 × 128)。
- 短卷积。 一个卷积核大小为 4 的因果卷积(后接 SiLU,即论文中的 Swish),把 q、k、v 的每个通道与前 3 个 token 的同一通道混合。这样每个 token 在接触记忆之前,先带上一点局部上下文。
- 拆成多头。 q、k、v 各变成 $[T, 64, 128]$。
- 写入强度。 一个 4,096 → 64 的投影加 sigmoid,为每个头给出一个 $\beta_t$:$[T, 64]$。
- 遗忘门。 低秩投影 4,096 → 128 → 8,192 加上 §8.2.3 的公式,为每个头的每个通道给出一个对数衰减:$[T, 64, 128]$。
- 更新与读取。 kernel 对 q、k 做 L2 归一化,在 $[64, 128, 128]$ 的状态上跑门控 delta 规则,输出 $[T, 64, 128]$。
- 输出。 每个头的 128 维输出先过 RMSNorm,再乘上 sigmoid 输出门(同样是低秩,4,096 → 128 → 8,192),最后从 8,192 投影回 4,096。
输出门也是论文的设计:Kimi Linear 用低秩 sigmoid 门,一是“to ensure a fair parameter comparison”(保证参数量对比公平),二是有助于“alleviating the Attention Sink”(缓解 Attention Sink)。论文的消融中,去掉输出门、把它换成 Swish 门、或去掉短卷积,困惑度都会变差(见下方细节)。
注意这里缺了什么:没有任何位置编码。顺序感只能来自卷积窗口、衰减,以及递推写入本身的先后顺序(§8.3)。
| 张量 | 形状 | 说明 |
|---|---|---|
q_proj、k_proj、v_proj |
各 4,096 → 8,192 | 无 bias |
| 短卷积 | 24,576 个通道 × 卷积核 4 | 逐通道,SiLU |
b_proj($\beta$) |
4,096 → 64 | sigmoid |
f_a_proj → f_b_proj(遗忘门) |
4,096 → 128 → 8,192 | 另有 fp32 的 A_log [64]、dt_bias [8,192] |
g_a_proj → g_b_proj(输出门) |
4,096 → 128 → 8,192 | sigmoid,在带门控的 RMSNorm 内 |
o_proj |
8,192 → 4,096 | |
| 循环状态(每条序列) | 64 × 128 × 128 | 1,048,576 个值 |
按配置推算,每个 KDA 层约 137.7M 参数,几乎全在四个大投影里(134M)。34 个 KDA 层的注意力参数约是 11 个 DSA 层 MLA 块的 3.6 倍。
实现细节
- 源码:
miles_plugins/models/glm5_next/kda.py。kernel 来自 fla ≥ 0.4.2:ShortConvolution、FusedRMSNormGated、fla.ops.kda.chunk_kda和fla.ops.kda.gate.fused_kda_gate。 - 配置:
linear_attn_config={num_heads: 64, head_dim: 128, short_conv_kernel_size: 4, gate_lower_bound: -5.0}。缺少下界时 Miles 直接报错:“GLM-5.3 KDA requires gate_lower_bound (safe gate)”。 -
Miles 在拼接后的 24,576 个 q k v 通道上只做一次卷积;HF 检查点和 fla 参考层则把 q_conv1d/k_conv1d/v_conv1d分开。我们的理解是两者等价,因为卷积对每个通道独立计算(fla 的ShortConvolution是逐通道(depthwise)因果卷积;该模块不在我们的本地快照中)。 - 调用 kernel 时传入
use_qk_l2norm_in_kernel=True。训练时不带初始状态,也丢弃最终状态。带门控的归一化是FusedRMSNormGated(128, eps=1e-5, activation="sigmoid")。 - 与 fla 参考层的小差别:Miles 输出门的升维投影没有 bias(fla 有),且 Miles 把
A_log和dt_bias初始化为零。对已发布的检查点来说,初始值无关紧要。 - Kimi Linear 消融(表 1,训练/验证困惑度,越低越好):完整设计 9.23/5.65;去掉输出门 9.25/5.67;Swish 输出门 9.43/5.81;去掉卷积 9.29/5.70。
- Miles 中 KDA 支持上下文并行(
hybrid_cp = True)。 - 参数量(按配置推算,不含归一化权重):q/k/v 100.7M,
o_proj33.6M,遗忘门和输出门各 1.6M,b_proj0.26M,卷积 0.1M。
8.2.5 分块训练
写成递推形式,KDA 要一个 token 接一个 token 地处理。推理时这没问题,训练时却很浪费:训练时 $T$ 个 token 全都已知,GPU 想要的是大矩阵乘法。解决办法是分块并行形式;Miles 正是这样通过 fla 的 chunk_kda 训练 KDA:
- 把序列切成 $C = 64$ 个 token 一块(我们读到的 fla 版本中的默认值,Miles 没有覆盖它)。
- 在块内,一次算出每个 token 与同块内所有更早 token 的相互作用:用 key、query 的点积构成 $64 \times 64$ 的下三角矩阵,并按两个 token 之间逐通道的累积衰减加权。
- 块与块之间只传递 $128 \times 128$ 的状态。
论文称之为“inter-block recurrent and intra-block parallel”(块间递推、块内并行)。难点在第 2 步:64 次 delta 规则更新要连乘 64 个形如 $(I - \beta k k^\top)\operatorname{Diag}(\alpha)$ 的矩阵,直接算很慢。
WY 表示解决了这个问题。它把许多秩 1 更新的连乘写成“单位阵减去若干外积之和”,于是整个块压缩成两个小的辅助矩阵 $W$ 和 $U$,只需矩阵乘法加一次 $64 \times 64$ 的三角求解。之后状态每块更新一次,输出由两部分组成:query 读取传入的状态,再加上块内一个类似注意力的三角乘积。推导见下方细节。
复杂度。 对每个头,分块 KDA 每个 token 的代价约为 $C\,d + d^2$ 次乘加,与序列长度 $L$ 无关;稠密的因果 softmax 注意力每个 token 约为 $L\,d$。取 $C = 64$、$d = 128$(按公式推算的乘加次数,不计 kernel 效率):
| 上下文 $L$ | 分块 KDA,每 token 每头 | 稠密 softmax 注意力,每 token 每头(平均) |
|---|---|---|
| 4,096 | 约 86K | 约 0.5M |
| 131,072 | 约 86K | 约 16.8M |
| 1,048,576 | 约 86K | 约 134M |
论文还报告,KDA 的受约束形式让它的 kernel 比所特化的一般“对角加低秩”(DPLR)形式快“roughly 100%”(约一倍)。
分块推导(WY 表示与 UT 变换)
记号:一个含 $C$ 个 token 的块,传入状态为 $S$;$\gamma^{i \to j} = \prod_{m=i}^{j} \alpha^m$ 是逐通道的累积衰减;$\Gamma$ 把从块起点开始的这些衰减堆叠起来;$K, Q, V$ 是该块的 key、query、value,各为 $C$ 行的矩阵。
- 展开。 块内 $S^r = P^r S + H^r$,其中 $P^r = \prod_{i=1}^{r} (I - \beta^i k^i k^{i\top})\operatorname{Diag}(\alpha^i)$(后面的 token 乘在左边),$H^r$ 汇总各次写入。
- WY 形式(Kimi Linear 式 3–5,沿用 Comba 的写法以省去一次额外的矩阵求逆):$P^r = \operatorname{Diag}(\gamma^r) - \sum_i \operatorname{Diag}(\gamma^{i \to r}) k^i w^{i\top}$,$H^r = \sum_i \operatorname{Diag}(\gamma^{i \to r}) k^i u^{i\top}$。
- UT 变换(式 6–7):$M = \big(I + \operatorname{StrictTril}(\operatorname{Diag}(\beta)(\Gamma \odot K)(K / \Gamma)^\top)\big)^{-1} \operatorname{Diag}(\beta)$,然后 $W = M(\Gamma \odot K)$,$U = M V$。三角矩阵的逆用前向代入逐行求出。按论文的说法,目的是“reduce non-matmul FLOPs”(减少非矩阵乘法的计算量)。
- 状态更新(式 8):$S_{\text{next}} = \operatorname{Diag}(\gamma^{C}) S + (\Gamma^{i \to C} \odot K)^\top (U - W S)$。
- 输出(式 9):$O = (\Gamma \odot Q) S + \operatorname{Tril}\big((\Gamma \odot Q)(K / \Gamma)^\top\big)(U - W S)$。第一项读取过去;第二项是块内注意力,作用在修正后的“伪 value”$U - WS$ 上。
- KDA 为什么比一般 DPLR 快:它把两个低秩向量都绑定到 $k$ 上,块内矩阵从四个减到两个,还省掉三次矩阵乘法。
- fla 的
naive_chunk_kda逐行实现了这些公式;生产用的前向 kernel(chunk_fwd.py)不在我们的本地快照里。chunk_size只能是 32 或 64。训练时 fla 的层只允许分块模式。 - 每块每头的代价(按公式推算):两个 $C \times C$ 打分矩阵($2 \cdot C^2 d$),$W$ 和 $U$($2 \cdot C^2 d$),用状态读取和修正($2 \cdot C d^2$),状态更新($C d^2$),外加一个很小的 $O(C^3)$ 求解。合计每 64 个 token 约 5.5M 次乘加,每 token 约 86K。稠密注意力在位置 $p$ 的代价是 $2pd$,在长度为 $L$ 的因果序列上平均为 $L d$。
8.2.6 解码:每个 token 四个小步骤
生成时 token 一个一个到来,这时递推形式最高效。fla 的参考层在不需要梯度、且输入不超过 64 个 token 时,切换到 fused_recurrent_kda kernel。对每个头、每个 token,它做四件事,每件事都把 $128 \times 128$ 的状态过一遍:
- 衰减。 把 $S$ 的每一行乘以对应的 $\alpha$。
- 预测。 算出 $\hat v = S^\top k$,即记忆对这个 key 当前返回的内容。
- 修正。 加上外积 $\beta\, k\, (v - \hat v)^\top$。
- 读取。 返回 $o = S^\top q$。
下面的 3D 模型在单个头上演示这一更新过程。
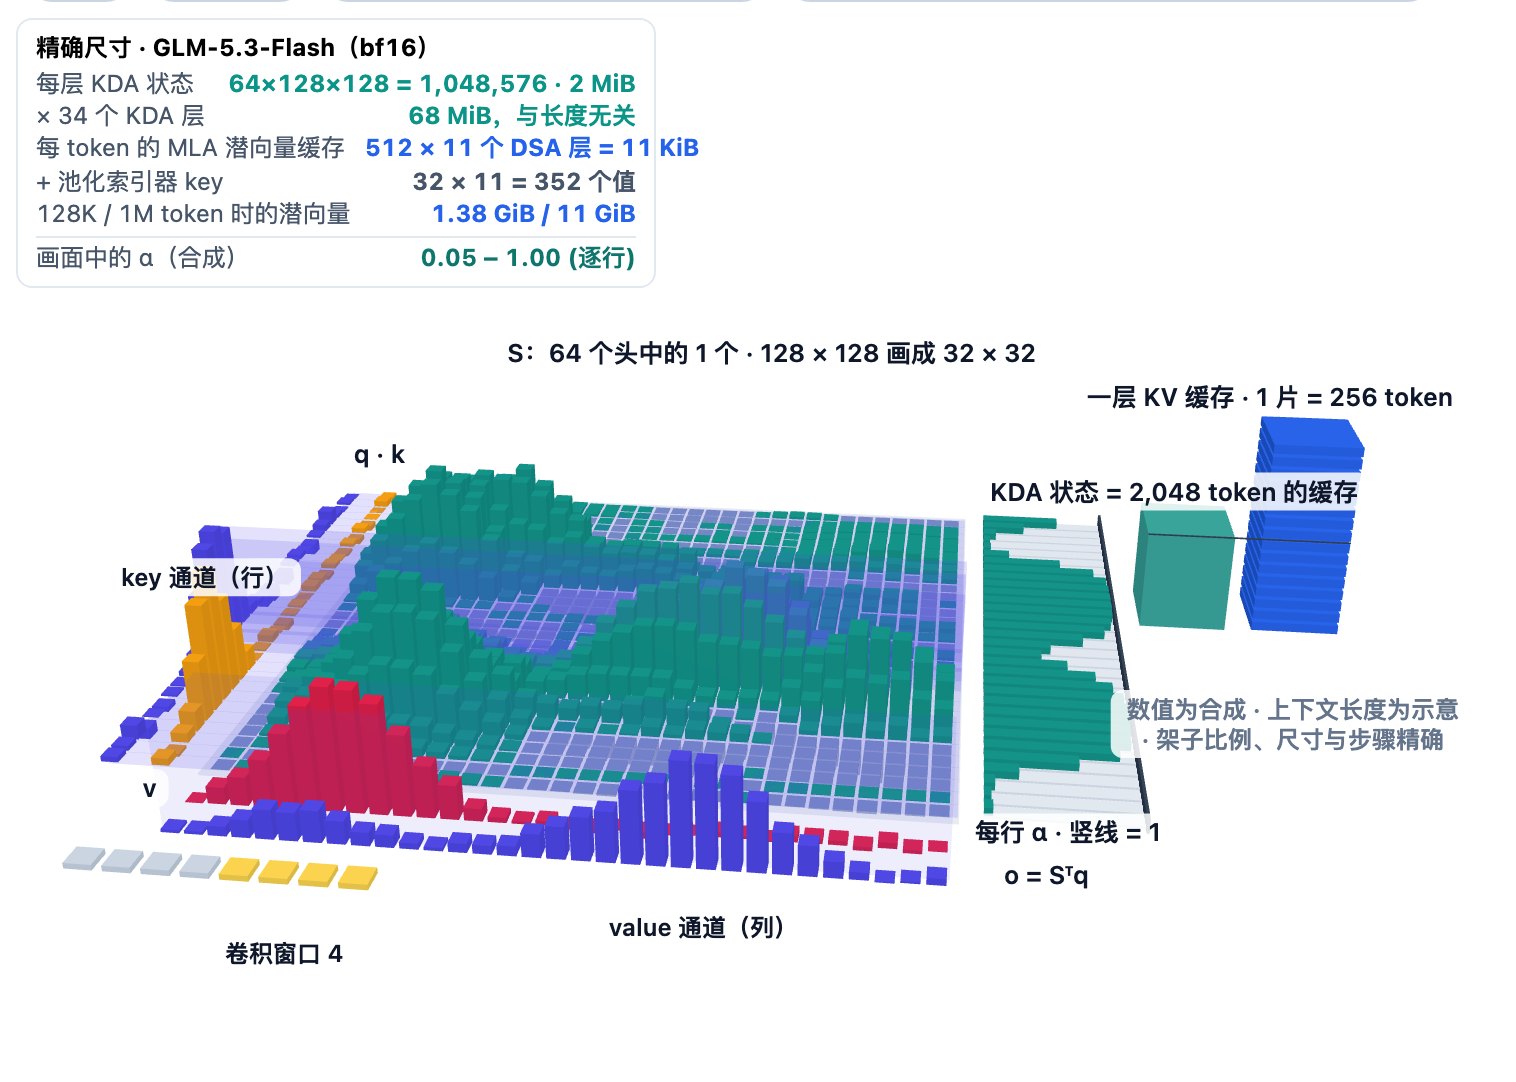
Flash 单个 KDA 层的具体数字(按形状推算):
- 计算。 每一步都把 16,384 个状态元素各处理一次(四步中有三步是乘加),所以一个头约 115K FLOPs,64 个头每个 token 约 7.3 MFLOPs。核心外围的投影再加约 275 MFLOPs。两者都与上下文长度无关。
-
内存。 状态有 64 × 128 × 128 = 1,048,576 个值:bf16 下 2 MiB,fp32 下 4 MiB;fla 的解码 kernel 计算时用 fp32 保存状态。卷积还要保留前 3 个 token 的 24,576 个 q k v 通道,即另外 73,728 个值。 - 对比。 一个 KDA 状态的大小,相当于 Flash 一个 MLA 层 2,048 个 token 的缓存(每 token 512 个值);到 1,048,576 个 token 时,这个 MLA 缓存是 KDA 状态的 512 倍(见下方细节)。
34 层合计,每条序列的状态在 bf16 下是 68 MiB;§9.3 把它和 DSA 层的缓存放在一起比较。DSA 层是稀疏的,注意力核心最多只看 2,048 个选中的 token,但它们仍要保留完整的潜在缓存,索引器也仍要给上下文中每个 4-token 块打分(§8.5)。
实现细节
- fla 的解码 kernel(
ops/kda/fused_recurrent.py)逐 token 循环,状态放在 fp32 寄存器里:对 q、k 做 L2 归一化(epsilon 1e-6),缩放 q,沿 key 轴衰减状态,从 $v$ 中减去 $S^\top k$,乘以 $\beta$,加上秩 1 写入,再用 q 读出。它把 128 个 value 列切成 32 列一块。 - fla 层的模式选择:只要开启梯度就用分块模式;推理且输入不超过 64 个 token 时用 fused-recurrent 模式;其他情况用配置的模式。该层为每层缓存一个卷积状态和一个循环状态。
- 与 MLA 的对比(按配置推算):Flash 一个 MLA 层每 token 缓存 512 个值,所以一个 KDA 状态(1,048,576 个值)等于其中 2,048 个 token;到 131,072 个 token 时,MLA 缓存是 KDA 状态的 64 倍。一个吸收形式的稠密 MLA 层,每生成一个 token,要为每个上下文 token 花约 131K FLOPs(64 个头 × 512 维,打分加 value 求和);上下文只要约 56 个 token,这部分就追平 KDA 恒定的 7.3 MFLOPs。
- Miles 是训练框架,只调用
chunk_kda。GLM-5.3-Flash 上线服务时用的 kernel 和状态精度不在我们的资料里;上面描述的解码过程是 fla 的参考路径。
8.2.7 为什么是与 DSA 的 3:1 混合
固定大小的记忆有代价:它是有损的,每个头 16,384 个数装不下一百万个 token 的原文。§5.1 介绍过的 GLM-9B 消融量化过这个风险。即使只把一半的层换掉,GDN(KDA 正是在它的基础上改进而来)在 128K 的 RULER 上也掉了 11.28 分;GLM-5 报告正是以这类差距为依据,主张 GLM-5 的每一层都用 DSA。Flash 比这个消融走得更远(3:1 而不是 1:1),但每四层仍保留一层 DSA。
Kimi Linear 论文从另一侧得出了相容的结论:“Long-context retrieval remains the primary bottleneck for pure linear attention.”(长上下文检索仍是纯线性注意力的主要瓶颈。)它的办法是按整层交错:三层 KDA,再接一层全注意力 MLA。消融中 3:1 的验证困惑度最好(5.65),优于 1:1(5.66)、7:1(5.70)、15:1(5.82)和全 MLA(5.77)。论文称 3:1 是“the best quality–throughput trade-off”(质量与吞吐之间的最佳折中)。
Flash 沿用了这个布局:[KDA, KDA, KDA, DSA] 重复 11 次,最后再加一层 KDA(§8.1)。它也和 Kimi Linear 一样,注意力层不用 RoPE(§8.3)。有一处明显不同:Kimi Linear 的注意力层是稠密 MLA,而 Flash 的是 DSA,即带索引器的稀疏 MLA。Flash 的 45 层中只有 11 层保留逐 token 的缓存。
对论文自己的模型(总参数 48B,激活 3B),论文报告:128K 下 RULER 得分 84.3,而用同样 1.4T token 训练的全 MLA 基线是 81.3;KV cache 最多小 75%;1M 上下文时,每个输出 token 的时间(TPOT)最多比 MLA 短 6.3 倍(1.84 ms 对 11.48 ms),论文称这是理论上的加速,并归功于可以使用更大的 batch。这些是 Kimi Linear 的数字,不是 Flash 的。
Z.ai 没有公开它的考量,所以 Flash 为什么选 3:1 尚不清楚。我们的理解是:这 11 个 DSA 层就是 KDA 层所缺少的精确检索通路。模型卡声称这种混合架构保留了 “precise long-context capabilities”(精准的长上下文能力);我们手头的资料里没有 Flash 的长上下文分数,这里无法核实。
数字从哪来
- Kimi Linear:混合设计与表 1(训练/验证困惑度:3:1 9.23/5.65,0:1 9.45/5.77,1:1 9.29/5.66,7:1 9.23/5.70,15:1 9.34/5.82)。论文的最终实验用的就是 3:1 模型。
- Kimi Linear 表 5(128K,所有模型均训练 1.4T token):RULER 84.3,对比 81.3(MLA)和 80.5(GDN 混合);论文在八项长上下文基准上的平均分为 54.5,MLA 为 52.2。Kimi Linear 在 LongBench V2 和 Frames 上不如 MLA。论文 §6.3 把 6.3 倍称为“a theoretical decoding speedup of up to 6.3×”(理论上最高 6.3 倍的解码加速),来自省下的内存可以支持更大的 batch;在 batch size 为 1 时,它报告 1M 下的加速为 2.3 倍(图 7b)。
- “最多 75%”:每四层只有一层保留逐 token 的缓存。对 Flash 做同样的算术,45 层中有 34 层没有不断增长的缓存(按配置推算)。
- GDN 结果:GLM-5 报告(arXiv 2602.15763)中的 GLM-9B 消融,见 §5.1。
8.3 NoPE:文本堆栈中没有旋转位置编码
Transformer 总得从某处学到 token 的顺序。GLM-5.3 和多数近期模型一样,把每个 query 和 key 的一部分按 token 位置旋转一个角度(RoPE,见 §3.3)。Flash 在文本堆栈的任何一层都不做旋转。就配置和代码所见,它的文本堆栈完全没有显式的位置信号(NoPE)。

证据在配置(qk_rope_head_dim 为 0、mla_use_nope 为 true、没有 rope_theta 或 rope_parameters 键)和 Miles 代码之间是一致的:DSA 层断言“GLM-5.3 DSA skips rope”,索引器和 KDA 层也不施加任何位置编码(见下方实现细节)。
GLM-5.3 在每个头 256 维 q/k 中旋转 64 维(§3.3),而 Flash 让全部 256 维都不带位置,Miles 文档称之为 “NoPE MLA — multi-latent attention with the positional half of the QK head empty”(QK 头的位置那一半是空的)。
那顺序从哪来?我们的理解(Z.ai 并未说明):只来自因果性。在 KDA 层里,短卷积看得到最近 4 个 token 的窗口;带衰减的循环让旧信息比新信息褪得更多,状态本身就编码了“新近程度”。在 DSA 层里,query 只能选更早的 token。没有哪个 token 带显式的位置坐标;顺序体现在哪些 token 可见、每个 token 还剩多少。
实现细节
- Miles:
miles_plugins/models/glm5_next/dsa.py断言config.qk_pos_emb_head_dim == 0(“GLM-5.3 DSA skips rope”),前向传播中断言rotary_pos_emb is None。同一文件里的索引器代码对index_q、index_k都不做 rope。 - 存在未解决的矛盾,所以我们不给 Flash 引用任何旋转基数:Miles 文档写 “rotary base 800000”,训练脚本传
--rotary-base 10000,配置里没有任何旋转基数键(没有rope_theta/rope_parameters)。旋转维度为零时,这个值在 Miles 中不起作用。 - 配置里还有
indexer_rope_interleave: true,但 Miles 在 Flash 索引器中没有用 rope。参考推理引擎是否使用,我们的资料无法判断;这个键可能是从 GLM-5 配置沿用下来的。 max_position_embeddings仍是 1,048,576,与 GLM-5.3 相同。
8.4 Flash 中的 MLA:每层只缓存 512 个数
11 个 DSA 层仍用 MLA(见 §3)压小缓存。由于 Flash 去掉了旋转部分,这些层每个 token 的缓存就只有 512 个数的潜在向量,没有额外的 64 维位置切片。
与 GLM-5.3 相比,形状有三处不同:
| GLM-5.3 | GLM-5.3-Flash | |
|---|---|---|
| 头数 | 64 | 64 |
query 压缩秩(q_lora_rank) |
2,048 | 1,536 |
key/value 潜在维度(kv_lora_rank) |
512 | 512 |
| 每头 query/key 维度 | 192 无位置 + 64 RoPE | 256 无位置 |
| 每头 value 维度 | 256 | 256 |
| 每 token 每层缓存的值 | 512 + 64 = 576 | 512 |
换个尺度看:若用这些头尺寸做不压缩的多头注意力,每 token 每层要缓存 64 × (256 + 256) = 32,768 个值,Flash 的 MLA 缓存只有其 1/64(按配置推算)。11 个 DSA 层合计每 token 5,632 个值;§9 会把它与 GLM-5.3 对比,并把索引键也算进去。
Miles 用 MLA 的吸收形式计算注意力(§3.4)。64 个头都对同一个 token 的同一份 512 维潜在向量做注意力,它同时充当 key 和 value。之后每个头用一个矩阵把结果从 512 维升回 256 维,输出投影再把 64 × 256 = 16,384 个值映射回 4,096。把 §3.4 的 MLA 3D 模型切到 Flash 模式,可以对比两种缓存条目。
实现细节
- 源码:
miles_plugins/models/glm5_next/dsa.py,继承自 GLM-5 的DSAMLASelfAttention。训练脚本参数:--q-lora-rank 1536 --kv-lora-rank 512 --qk-head-dim 256 --qk-pos-emb-head-dim 0 --v-head-dim 256。 - 吸收:
linear_kv_up_proj.weight拆成w_kc和w_vc,形状都是 [64, 256, 512]。query 为einsum(q, w_kc)→ [T, 64, 512];key 是共享的 512 维潜在向量(一个 KV 组)。 - 填充:
_SPARSE_MLA_TAIL_DIM = 64,在 query 和 key 上各补 64 个零维。GLM-5 的 tilelangSparseMLAkernel 要求 key 宽 576(512 维潜向量 + 64 维旋转),补零后 Miles 就能复用它;补的部分对任何点积都没有贡献。我们的理解是,这是为了省掉专门写一个 512 宽 kernel 的捷径。 softmax_scale = q_head_dim ** -0.5,其中q_head_dim = 256。softmax 缩放按真实头维度算,不按补零后的宽度算:是 $1/\sqrt{256} = 0.0625$,而非 $1/\sqrt{576} \approx 0.042$。说白了,注意力 logit 在 softmax 之前除以 16。- q 与 kv 的 RMSNorm 融合进了
linear_q_up_proj/linear_kv_up_proj,所以层定义里它们显示为恒等算子。 - 按配置推算,Flash 的一个 MLA 块约 117.4M 参数,其索引器另有约 7.5M。
8.5 kpool 索引器:以 4 个 token 为一块来挑选
Flash 的 11 个 DSA 层同样靠闪电索引器决定每个 query 读哪 2,048 个历史 token,规格也和 GLM-5.3 一样:32 个头 × 128 维,top-2,048。区别在于索引器给什么打分。Flash 不再给每个历史 token 各配一个索引键,而是先把每 4 个连续 token 压成一个池化键(kpool 一名即来自配置键 index_kpool),再按整块挑选。
DSA 层的其余部分沿用 §5.3 的 GLM-5.3 设计:每个 query token 一份名单,64 个头共用,选的是 MLA 的潜在缓存;在 Flash 里,缓存只有 512 维潜在向量(§8.4)。索引查询和头权重的构造也和 §5.2 相同,只是输入换成 Flash 的 1,536 维压缩查询和 4,096 维隐藏状态。
Miles 中的实现分四步:
- 池化键。 每条序列切成互不重叠的块(pool),每块 4 个连续 token。每个 token 仍有自己的 128 维索引键,同一块的 4 个键融合成一个。
- 只给完整的块打分。 对位置 $t$ 的 query,只有 4 个 token 都在 $t$ 或之前的块才有资格参选。每块得到一个索引分数,打分器与 GLM-5.3 相同,都是 ReLU 打分(§5.2)。
- 选 512 块,展开成 2,048 个 token。 得分最高的 $2{,}048 / 4 = 512$ 块胜出,每块展开回 4 个 token 位置。
- 总是补上尾部。 当前尚未凑满的那一块里的 token(0 到 3 个,含 query 自己)追加在 top-k 之后,因此最新的 0 到 3 个 token 永远不会漏掉。
还有一条捷径:序列前 2,048 个位置上的 token 直接看到截至自身(含自身)的全部 token。这就是精确的稠密因果注意力,索引器不参与任何选择。GLM-5.3 是隐式地得到同样的结果(§5.3),Flash 的代码则显式检查这一条件。
第 1 步细看。 融合是一个可学习的、逐通道的 softmax。设块 $p$ 覆盖 token $s, \dots, s+3$,对 128 个通道中的每个通道 $d$:
\[\pi_{r,d} = \frac{\exp\left(g_{s+r,d} + a_{r,d}\right)}{\sum_{r'=0}^{3} \exp\left(g_{s+r',d} + a_{r',d}\right)}, \qquad \bar{k}_{p,d} = \sum_{r=0}^{3} \pi_{r,d}\, k_{s+r,d}\]其中 $k_{s+r}$ 是 token 的索引键;$g_{s+r} = W_{\text{gate}} x_{s+r}$ 是由隐藏状态算出的 128 维门控;$a_{r}$ 是块内第 $r$ 个槽位(0 到 3)的可学习偏置。块的分数沿用熟悉的索引器公式:
\[I_{t,p} = \sum_{j=1}^{32} w_{t,j}\, \mathrm{ReLU}\left(q_{t,j} \cdot \bar{k}_p\right)\]说白了(数字仅作示意):一块里装着 “the”、“capital”、“of”、“France”,池化键的第 7 个通道可能 70% 取自 “France”,取自 “the” 的只有百分之几;第 8 个通道的权重分配则可能完全不同。槽位偏置 $a_r$ 让模型可以偏爱某个位置,比如每块的最后一个 token。这样,每个 query 每块只需比较 1 个键,而不是 4 个。
每个通道各做各的 softmax,所以池化键不等于任何一个 token 的键,而是逐维度的混合:一个池化键可以同时带上几个 token 最突出的特征。我们的理解是,这正是融合方式要靠学习、而不是简单取平均的原因。
第 2 到 4 步,算一个例子。 取位置 10,001(从 0 数起)上的 query,它能看到 10,002 个 token:
- 完整的块:$\lfloor 10{,}002 / 4 \rfloor$ = 2,500 个有资格的块,覆盖位置 0 到 9,999。
- 索引器给这 2,500 个池化键打分(而不是 10,002 个 token 键),留下前 512 个。
- 512 个块展开成 2,048 个 token 位置。
- 尾部是位置 10,000 和 10,001($10{,}002 \bmod 4 = 2$ 个 token),追加在后面。
注意力内核于是读 2,050 行潜在向量。如果 query 在位置 10,003,最后一块正好凑满,尾部为空,这一块和其他块一样参与竞争。
实现细节
- 配置键:
index_kpool 4、index_kpool_compress true、index_kpool_always_select_tail true,以及熟悉的index_n_heads 32、index_head_dim 128、index_topk 2048。Miles 断言index_kpool > 1且两个开关都为 true(glm5_next.py),也没有关闭它们的代码路径;尾部总会被追加(没有任何代码读取这个开关)。 - 每个 DSA 层新增的权重:
index_kpool_compress_gate[128, 4096](即门控 $W_{\text{gate}}$)和index_kpool_compress_ape[4, 128](即槽位偏置 $a$),以 fp32 存储(dsa.py)。Miles 把两者初始化为 0 并设为冻结,所以它们的取值必须来自 checkpoint。 - 池化与选择在
miles_plugins/models/glm5_next/ops/kpool_indexer.py:pool_boundaries把每条序列切成 $\lfloor \text{len}/4 \rfloor$ 块,_pooled_keys_kernel计算 $\bar{k}$(fp32 下先减最大值再做 softmax),kpool_select_topk取min(index_topk // kpool, num_pools)= 512 块。打分复用 GLM-5 的 TileLang 索引器内核;没有资格的块记为 $-\infty$,入选块若分数非有限值,索引记为 −1。 - 这里的 top-k 是对 fp32 分数调用
torch.topk,没有 FlashInfer 选项,正是 GLM-5 报告建议在 RL 中使用的确定性算子(§5.7)(除非启用可选的索引器重放,直接使用记录下来的选择,见 §10)。 - 输出的索引列表补齐到 64 的倍数:$\lceil (2{,}048 + 3)/64 \rceil \times 64 = 2{,}112$ 个槽位,尾部放在第 2,048 到 2,050 号槽位,所以一个 query 最多读 2,051 个真实的键。
- 索引键是
wk(x)再过 LayerNorm;头权重 $w_{t,j}$ 由weights_proj(x)以 fp32 算出,再乘以 $32^{-1/2} \cdot 128^{-1/2}$。索引查询是对 RMS 归一化并 detach 后的压缩查询施加wq_b(1,536 → 32 × 128)。
这样做换来什么? 以下是我们对代码的理解,并非 Z.ai 给出的数字:
- 要打分的键更少。 每次索引器计算只给约 $L/4$ 个池化键打分,而不是 $L$ 个 token 键:每个历史 token 摊到 32 × 128 × $L$/4,即 1,024 次乘加,而不是 4,096 次。池化本身给每个 token 加一笔固定开销(门控是 4,096 → 128 的投影),与 $L$ 无关。
- 交叉点更靠后。 Flash 的稀疏注意力每层每个 query token 约 1.34 亿次乘加。索引器打分要到约 131K token 才追上它,GLM-5.3 的逐 token 索引器则在约 35K(§5.3;均按配置推算)。
- 索引键缓存更小。 每 4 个 token 一个 128 维的键,相当于每个 DSA 层每 token 32 个数,是 GLM-5.3 的 128 个的四分之一。
- 按块读取。 选中的键以 4 个连续 token 为一段,比 2,048 个零散位置更适合稀疏注意力内核。
- 读取预算不变。 昂贵的 MLA 注意力仍然读 2,048 个选中的 token(外加最多 3 个尾部 token),和 GLM-5.3 完全一样。
我们的理解是,代价在于粒度:索引器没法只挑一个 token 而不带上它的三个邻居,2,048 个 token 的预算里有一部分花在“搭便车”的 token 上。资料里没有针对这一权衡的消融,也没有解释块大小为什么是 4。
Flash 没有使用 IndexShare:它的 indexer_types 45 项全是 "full",11 个 DSA 层各自运行索引器。按我们的理解,它几乎不需要共享:布局本身就已达到 GLM-5.3 靠复用才得到的约四分之一的索引器密度(§1.3),而池化又把每次索引的工作量降到约四分之一。§9.4 给出了两者合起来的效果。
Flash 的索引器也没有自己的位置信号。GLM-5.3 用 RoPE 旋转每个索引向量的一半维度(§5.2),Flash 一维都不转(§8.3)。块内唯一的位置输入是槽位偏置 $a_r$,块与块之间则只靠因果窗口。
§5.2 索引器 3D 模型的 Flash 模式演示这种“先选块、再展开”的挑选方式,那里的索引器动画也涵盖了它。§5.6 的注意力地形图同样有 Flash 模式,可以看完整的 45 层堆叠。
数字从哪来
- 索引器密度:GLM-5.3 在第 0、1、2 层以及第 6、10、…、74 层(每 4 层一个)保留索引器(78 层中 21 层,见 §5.6);Flash 的 DSA 层是第 3、7、…、43 层(45 层中 11 层,来自
layer_types)。索引器权重只出现在这 11 层和 MTP 层(第 45 层)上,所以我们的理解是,KDA 层对应的"full"只是占位。 - 索引器工作量的粗略比值(按配置推算,并非官方数字):以同样深度、每层都运行逐 token 普通索引器的模型为基线,GLM-5.3 的索引器工作量约为 $21/78 \approx 0.27\times$,Flash 约为 $11/45 \times 1/4 \approx 0.06\times$;这里假设每个头的开销相同,并忽略 MTP 层和池化开销。
- 成本数字(按配置推算):Flash 稀疏注意力 ≈ 64 头 × (512 + 512) × 2,051 ≈ 1.344 亿次乘加(每层、每个 query token);内核实际在补齐到 576 宽的键和 2,112 个槽位上计算,约 1.47 亿次。1.344 亿 / 1,024 ≈ 131K token。每个 token 的固定索引器投影:
wq_b+wk+weights_proj+ 门控 ≈ 747 万次乘加。 - 在 Miles 的 RL 中,Flash 的索引器不参与训练:输入经过 detach,打分在
torch.no_grad下运行,两个 kpool 张量的requires_grad设为False。kpool 选择在上下文并行下会抛出NotImplementedError。训练相关内容见 §10。 - 配置里写着
indexer_rope_interleave true,但 Miles 对 Flash 索引器的 query 和 key 都没有施加旋转位置编码(§8.3)。参考推理代码怎么做,仅凭本地资料无法判断。
8.6 mHC:把一条残差流拓宽成四路
GLM-5.3 和大多数 Transformer 一样,每个子层从一条残差流读取输入,再把输出加回这条流。Flash 把这条流拓宽成 4 路并行的残差流:每个子层读取各路的加权混合,再把输出分发回各路;各路之间用一个 4 × 4 的小矩阵相互混合,这个矩阵受到约束,混合时不会放大信号。这就是模型卡点名的 mHC 技术(原文见 §8 开头的引文)。
配置和代码能确定的事实:
- 4 路残差流。
hc_mult 4对应 Megatron 的num_residual_streams = 4。 - 每层两处。 45 层中每一层,注意力子层和 FFN 子层外面各包一个超连接,共 90 处 mHC。
- 最后取简单平均。 进入最终归一化和 LM head 之前,4 路残差流直接取平均,没有可学习的权重。
下面的公式沿用 mHC 论文(arXiv 2512.24880),是我们对这些张量用法的理解:真正的计算在 Megatron-LM 的一个模块里(radixark/Megatron-LM#89),我们没有查看。残差状态 $x_l$ 含 4 路、每路 4,096 个值,每一处 mHC 的计算是:
\[x_{l+1} = H^{\text{res}}_l\, x_l + \left(H^{\text{post}}_l\right)^{\top} \mathcal{F}\left(H^{\text{pre}}_l\, x_l\right)\]其中 $\mathcal{F}$ 是注意力或 FFN 子层;$H^{\text{pre}}$(1 × 4)把 4 路混成一个 4,096 维的子层输入;$H^{\text{post}}$(1 × 4)把输出分摊回 4 路;$H^{\text{res}}$(4 × 4)负责各路之间的相互混合。三者都根据当前状态逐 token 算出,再乘以对应的 $\alpha$、加上偏置。

按 mHC 论文的表述,约束加在 $H^{\text{res}}$ 上。它的原始元素先经 $\exp(\cdot)$ 变成正数,再做 20 次 Sinkhorn 迭代,交替缩放各行、各列,直到每行、每列之和都为 1。结果(近似)是一个双随机矩阵。
说白了:若混合矩阵第一行是 $[0.7, 0.1, 0.1, 0.1]$,新的第 1 路就等于 70% 的旧第 1 路,加上其余各路各 10%。由于每一列之和也是 1,每条旧残差流分出去的权重恰好是它的全部,不多也不少。mHC 论文的论证是:这类矩阵不会放大信号(谱范数不超过 1),而且它们的乘积仍是双随机矩阵,所以叠加 90 处之后,残差通路既不会爆炸,也不会消失。
mHC 的参数开销很小。按我们的推算(假设映射权重的形状如论文公式所示),每处约 0.39M 个权重,90 处合计约 35M,大约占模型的 0.01%。模型卡说采用 mHC 是为了“to further improve scaling efficiency”(进一步提升扩展效率);按论文的论证,收益在于让信号更稳定地穿过 45 层,而不是增加容量。
更可能的代价在宽度上:如果 4 路残差流按公式所示在层间传递,那么每个 token 层与层之间传递的隐藏状态就是 4 × 4,096 = 16,384 个值,而不是 4,096 个(这是我们的理解;对显存和速度的影响,我们没有实测数据)。
实现细节
- Miles 把配置映射到 Megatron:
enable_hyper_connections=True、num_residual_streams=4、mhc_sinkhorn_iterations=20、use_fused_mhc=False(miles_plugins/models/glm5_next/glm5_next.py)。它断言hc_eps == 1e-6,因为 Megatron 在 Sinkhorn 和计算 $H$ 时把这个 epsilon 写死了。 - 权重桥接把
hc_*_fn映射到mapping_proj.weight,hc_*_base映射到它的偏置,并把hc_*_scale拆成 $\alpha_{\text{pre}}, \alpha_{\text{post}}, \alpha_{\text{res}}$(第 0、1、2 个切片)。FP8 检查点中所有hc_*张量都不量化。 - 每处 3 个张量。
hc_{attn,ffn}_fn是一个线性映射,根据当前状态生成混合系数;hc_{attn,ffn}_base是叠加在系数上的静态偏置;hc_{attn,ffn}_scale存放 3 个标量 $[\alpha_{\text{pre}}, \alpha_{\text{post}}, \alpha_{\text{res}}]$。 - Sinkhorn 迭代 20 次:
hc_sinkhorn_iters 20,hc_eps 1e-6。 - Miles 改写了计算系数用的投影:除 $x W^{\top}$ 外,还单独返回 RMS 因子 $1/\sqrt{\mathrm{mean}(x^2) + \epsilon}$,其中 $\epsilon = 10^{-5}$(即 RMSNorm 的 epsilon)。我们的理解是,这相当于把 4 路状态拼接后的 RMSNorm 折算进了系数。
- 最后的汇合是
Glm5NextMeanOutputContraction,代码注释称之为 “plain mean over the residual streams, with no learned head weights”,即对各路残差流取简单平均、不带可学习权重。 - 每处 0.39M 的数字假设
hc_*_fn的形状为 $[n^2 + 2n,\ n \cdot 4{,}096] = [24, 16{,}384]$($n = 4$):$H^{\text{res}}$ 占 16 个系数,$H^{\text{pre}}$ 和 $H^{\text{post}}$ 各占 4 个。确切形状无法从本地资料核实。
8.7 Flash 的 MoE:288 个专家,每次用 8 个
Flash 的前馈部分沿用 GLM-5.3 的配方(§4),只是换成了更窄的模型,每个 MoE 层有 288 个路由专家(GLM-5.3 是 256 个)。
| GLM-5.3 | GLM-5.3-Flash | |
|---|---|---|
| 隐藏维度 | 6,144 | 4,096 |
| 每个 MoE 层的路由 / 共享专家 | 256 / 1 | 288 / 1 |
| 每个 token 用到的专家 | 8 个路由 + 1 个共享 | 8 个路由 + 1 个共享 |
专家 FFN 宽度(moe_intermediate_size) |
2,048 | 2,048 |
| 每个专家的权重数(按配置推算) | 37.75M | 25.17M |
| 稠密层 / MoE 层 | 3 / 75 | 3 / 42 |
| 路由器 | sigmoid、noaux_tc、缩放 2.5、fp32 |
sigmoid、noaux_tc、缩放 2.5、fp32 |
每个专家是由三个 4,096 × 2,048 矩阵组成的 SwiGLU 块。§4 的“专家之城”3D 模型有一个 Flash 开关,可以切换到 288 个专家的网格。
Flash 的配置比 GLM-5.3 多出两个键:
- 一个很小的辅助均衡损失。
router_aux_loss_coef 0.001。我们的理解是,负载均衡主要仍靠noaux_tc那个只用于选择的专家偏置(§4),这个系数只是在此基础上再加一项很轻的损失约束。预训练中具体怎么用,资料没有说明。 - 激活截断。
swiglu_limit 10。Miles 把它作为--activation-func-clamp-value 10传给 Megatron,代码注释写道:检查点设定了 swiglu_limit=10,“which sglang applies to dense, shared and routed MLPs”,即 SGLang 对稠密、共享和路由 MLP 都施加这一上限。视觉编码器的配置里也有同样的上限。
Flash 的参数比旗舰更集中在专家身上。按我们的推算,路由专家共 304.4B 个权重,占 313.3B 文本参数的 97.2%;一个 token 在每个 MoE 层只用到该层约 7.27B 权重中的约 226.5M(约 3%)。§8.9 把这些数字与模型卡的 320B 总量和 18B 激活量对账。
实现细节
- Miles 的 Megatron 参数:
--num-experts 288、--moe-router-topk 8、--moe-ffn-hidden-size 2048、--moe-shared-expert-intermediate-size 2048、--moe-router-score-function sigmoid、--moe-router-enable-expert-bias、--moe-router-topk-scaling-factor 2.5、--moe-router-dtype fp32,以及--moe-layer-freq=[0]*3 + [1]*42。 - 配置:
n_group 1、topk_group 1(不做分组限制路由)、norm_topk_prob true。每层的专家偏置存为mlp.gate.e_score_correction_bias。 - 在 Miles 的 RL 中,
--moe-router-bias-update-rate 0冻结了这个偏置,--enable-r3开启 rollout 路由重放(§10)。 - 截断的确切形式(gate 投影和 up 投影各自怎么截断)在 SGLang 和 Megatron 的代码里,我们没有查看。
8.8 原生视觉:文本主干前面的 24 层 ViT
GLM-5.3 只读文本;Flash 还能读图像和视频(§1.1)。机制并不新:视觉编码器(这里是 ViT)把像素转成与文本模型同宽的向量,这些向量像普通 token 一样放进序列。
vision_config 描述的是一个小编码器,挂在 4,096 维的文本主干前面:
| 字段 | 取值 |
|---|---|
Transformer 块数(depth) |
24 |
| 隐藏维度 / 头数 | 1,024 / 16(头维度 64,按配置推算) |
| MLP 宽度 | 4,096(SiLU) |
| patch 大小 / 默认图像尺寸 | 14 px / 448 px |
| 时间 patch / 空间合并 | 2 帧 / 2 × 2 个 patch |
输出宽度(out_hidden_size) |
4,096(= 文本隐藏维度) |
| 投影 MLP 宽度 | 10,240 |
激活截断(swiglu_limit) |
10 |
说白了(按配置推算,假设合并方式与早先的 GLM-V 模型相同):一张 448 × 448 的图切成 $32 \times 32 = 1{,}024$ 个 14 × 14 像素的 patch;每 2 × 2 个合并后剩 256 个向量,各自投影到 4,096 维,于是这张图以 256 个 token 的形式进入文本模型。视频则由时间 patch 把每 2 个相邻帧合成一个 patch。
和语言模型相比,这个编码器很小。按我们的推算约 0.56B 个权重,不到 320B 总量的 0.2%;这个数字假设模块布局与 GLM-4.xV 的编码器相同,后者的模块名与 Flash 检查点配置里列出的名字完全一致。
实现细节
- FP8 跳过列表里可见的模块名:
visual.patch_embed.proj、visual.blocks.{0..23}(含attn.qkv、attn.q_norm、attn.k_norm、attn.proj以及 SwiGLU 的mlp.gate_proj/up_proj/down_proj)、visual.post_layernorm、visual.downsample和visual.merger.*。FP8 检查点中所有visual.*权重都保持 BF16。 - 特殊 token:
image_token_id154854 和video_token_id154855 分别标记图像和视频;边界 token 为图像起止 154830/154831、视频起止 154832/154833。模型卡的 pipeline tag 是image-text-to-text,基准脚注中包含视觉基准 BabyVision。 - 我们的 0.56B 拆分为:24 个块(403.0M)、merger(142.6M)、downsample(16.8M)、patch 嵌入(1.2M)。视觉部分如有位置嵌入,未计入。
- Miles 目前对 Flash 的支持只限文本:其 chat template 代码注明 “Flash support covers tokenizer text inputs, not multimodal processor inputs”,即只覆盖 tokenizer 的文本输入,不含多模态 processor 输入。
8.9 核对参数量
模型卡说 Flash 有 “320B total parameters and just 18B active parameters”(总参数 320B,激活参数仅 18B)。这两个数字都不在配置里,所以我们根据配置和 Miles 代码重新数了一遍。结果与模型卡很接近,但只有换一种统计口径才对得上,而且这种口径和能复现旗舰 744B 的那一种并不相同。
| 组成部分(按配置推算) | 总参数 | 每个文本 token 的激活参数 |
|---|---|---|
| 文本主干:45 层 + 词嵌入 + LM head | 313.33B | 17.38B |
| MTP 层(第 45 层,与主干共享词嵌入和 LM head) | 7.43B | 0.39B(若计入) |
| 视觉编码器 | 0.56B | 0(图像 token 除外) |
| 合计 | 321.32B | 17.38B 至 17.94B |
| 模型卡 | 320B | 18B |
数字从哪来
- 总参数。 我们的 321.3B 与 “320B” 相差约 0.4%,但只有同时计入 MTP 层和视觉编码器才对得上。只算文本是 313.3B,文本加视觉、不含 MTP 是 313.9B。
- 激活参数。 45 个主层(含词嵌入和 LM head)为 17.38B,加上 MTP 层为 17.76B,再加视觉编码器为 17.94B。这里计入了嵌入表和 LM head,与 §2.3 中 GLM-5 报告的口径不同。后两者四舍五入为模型卡的 18B,只算主层的 17.38B 约低 3.5%;Z.ai 指的是哪一个,没有说明。
- 所有数字都由一个读取
config.json的脚本算出(即我们资料库中的params_flash.py)。KDA 形状取自 Mileskda.py;DSA 注意力按 GLM-5 的 MLA 布局计算,qk_rope_head_dim 0;索引器和 kpool 张量取自dsa.py;MoE 尺寸取自配置。 - 假设的形状:mHC 映射权重(合计约 0.04B)和视觉编码器布局(约 0.56B),两者加起来只占总数中约 0.6B。
- 文本主干拆分:路由专家 304.41B,KDA 注意力 4.68B(34 层),DSA 的 MLA 1.29B、索引器 0.08B(11 层),共享专家 1.06B,词嵌入和 LM head 各 0.63B,稠密 FFN 0.45B,路由器 0.05B,归一化与 mHC 0.04B。
- 不计词嵌入表,激活参数为 16.74B;词嵌入表和 LM head 都不计,则为 16.11B。
9. 内存与计算:两笔账并排算
一段超长对话,每个模型要占多少内存?每生成一个新 token,又要花多少计算?先说结论:两个模型都给每个 token 的注意力计算封了顶,但 GLM-5.3-Flash 还让大部分层不再保留逐 token 的缓存,所以它的内存随上下文增长的速度只有 GLM-5.3 的约 1/8。
本节所有数字都由我们按两份 config.json(计算部分另用官方激活参数量)推算,是单条序列、bf16(每个值 2 字节)下的粗略估算,不是实测。我们手头的资料里,没有任何一个模型的实测服务内存或速度数据。
9.1 增长型缓存:每来一个 token 要多存多少
长对话的主要内存开销,是随上下文增长的缓存。凡是做 softmax 注意力的层,都得为每个历史 token 留一份数据,供后面的查询回看。
- GLM-5.3。 78 层全是 MLA 层。每层存 512 维的潜在向量和 64 维的 RoPE 键,所以每个 token 增加 $78 \times (512 + 64) = 44{,}928$ 个值,bf16 下是 89,856 字节,约 88 KiB。
- GLM-5.3-Flash。 只有 11 个 DSA 层保留逐 token 缓存,而且它的 MLA 是 NoPE,没有 RoPE 部分:$11 \times 512 = 5{,}632$ 个值,即 11,264 字节(11 KiB)。34 个 KDA 层不随 token 增加任何缓存。
- Flash 的池化索引键。 kpool 索引器每 4 个 token 存一个 128 维的键,相当于每个 DSA 层每 token 32 个值,11 层共 $11 \times 32 = 352$ 个。算上它,Flash 每 token 增加 5,984 个值(11,968 字节)。
说白了:每追加一个 token,GLM-5.3 往缓存里写约 88 KiB,Flash 写约 11 KiB,算上池化索引键约 12 KiB。两者之比是 7.98 倍;把 Flash 的池化键也算进去,约 7.5 倍。
9.2 放到一百万 token
再乘上上下文长度。两份配置都支持 1,048,576 个位置;表里也列出整 $10^6$ 个 token 的结果,因为“1M”常被这样理解。
| 单条序列,bf16(按配置推算) | GLM-5.3 | GLM-5.3-Flash |
|---|---|---|
| $10^6$ token 时的增长型缓存 | 44.9G 个值,约 90 GB | 5.6G 个值,约 11.3 GB(含池化键约 12.0 GB) |
| 1,048,576 token 时的增长型缓存 | 87.75 GiB(约 94 GB) | 11 GiB(约 11.8 GB);含池化键 11.7 GiB |
| 与长度无关的固定状态 | 无 | 68 MiB KDA 状态(另有约 5 MiB 卷积状态) |
这些是数量级,不是服务指标。差距来自两个选择叠加:Flash 只在 11 层而不是 78 层保留逐 token 缓存;它的 NoPE MLA 又让每条记录少了 64 个 RoPE 值。
9.3 固定大小的“笔记本”:Flash 的 KDA 状态
34 个 KDA 层用一份固定大小的状态,换掉了增长型缓存。这正是 §8.2 动画最后落到的状态:每个头只保留一个 128 × 128 的矩阵,随 token 到来原地更新。
\[34 \text{ 层} \times 64 \text{ 头} \times 128 \times 128 = 35{,}651{,}584 \text{ 个值} \approx 68 \text{ MiB(bf16)}\]说白了:不管对话是 10 个 token 还是 1,000,000 个 token,Flash 的 KDA 内存都是这 68 MiB。它相当于约 6,300 个 token 的 DSA 缓存($35{,}651{,}584 / 5{,}632 \approx 6{,}330$)。超过这个长度,增长型缓存就占了大头;到 1,048,576 个 token 时,KDA 状态只占 Flash 总量的约 0.6%。
数字从哪来
- GLM-5.3:
num_hidden_layers78,kv_lora_rank512,qk_rope_head_dim64。MLA 缓存压缩后的潜在向量和共享的 RoPE 键;GLM-5 报告把 MLA 解码描述为 576 维点积(512 + 64)。 - Flash: 11 个
deepseek_sparse_attention类型的层,kv_lora_rank512,qk_rope_head_dim0(mla_use_nope为 true)。KDA:linear_attn_config中 64 个头 ×head_dim128,short_conv_kernel_size4。 - 池化索引键:
index_head_dim128,index_kpool4。不做池化的话,Flash 的索引键是每 token $11 \times 128 = 1{,}408$ 个值。 - 卷积状态: 短卷积作用在 q、k、v 上(3 × 8,192 个通道),需要保留前 3 个输入,约 $34 \times 24{,}576 \times 3 \approx 2.5$M 个值,约 5 MiB。这是我们根据卷积核大小的理解,资料里没有把它写成缓存大小。
- 未计入: MTP 层,以及 GLM-5.3 的索引键。如果 21 个计算层各为每个 token 缓存一个 128 维键,每 token 会多 2,688 个值(按配置推算;缓存格式不在我们的资料里)。两种算法下比例都接近 8 倍:47,616 对 5,984,是 7.96 倍。
- 精度: 全部按 bf16 计(尽管 fla 的参考解码 kernel 以 fp32 保存 KDA 状态,34 层合计 136 MiB;推理服务用的精度不在我们的资料中)。Miles 的 GLM-5.2 rollout 配方在 SGLang 中使用
fp8_e4m3KV cache;每个值存 1 字节的话,上面的数字大约减半(不算缩放因子)。我们没有计算 FP8 布局。 - 单位: GB = $10^9$ 字节,GiB = $2^{30}$ 字节。
9.4 每个 token 的计算:哪部分还在随上下文增长
缓存只是一半,每个新 token 还要花算力。两个模型里,昂贵的 softmax 注意力都封了顶,唯一还随上下文增长的是闪电索引器:它要给每个历史键打分(Flash 里是给每个由 4 个历史键组成的池打分)。
- 稀疏注意力。 每个 DSA 层最多关注 2,048 个选中的 token,与上下文多长无关。Flash 还会附上当前未满的池里 0 到 3 个 token,所以最多 2,051 个。
- KDA。 每个 KDA 层每个 token、每个头只做固定次数的 128 × 128 矩阵运算,与上下文无关。
- 索引器。 GLM-5.3 在 78 层中的 21 层运行索引器,每层给全部 $L$ 个历史键打分;Flash 在 45 层中的 11 层运行,每层给 $L/4$ 个池化键打分。每个 token 是 $21L$ 对 $11 \times L/4 = 2.75L$ 次打分,Flash 只有 GLM-5.3 的约 1/7.6。
为了看清量级,下面按 $10^6$ token 的上下文粗算每个 token 的计算量。计算量以 FLOPs 计(1 GFLOP = $10^9$ 次),权重矩阵部分用“每个激活参数约 2 FLOPs”的经验公式,再加上面的注意力和索引器两项。
| $10^6$ 上下文下每个 token,按配置推算 | GLM-5 / 5.1(每层都有索引器) | GLM-5.3 | GLM-5.3-Flash |
|---|---|---|---|
| 权重矩阵乘($2 \times$ 激活参数) | 约 80 GFLOPs | 约 80 GFLOPs | 约 36 GFLOPs |
| 稀疏注意力(≤ 2,048 个键) | 约 22 GFLOPs | 约 22 GFLOPs | 约 3 GFLOPs |
| 索引器打分 | 约 639 GFLOPs | 约 172 GFLOPs | 约 22.5 GFLOPs |
| 粗略合计 | 约 741 GFLOPs | 约 274 GFLOPs | 约 62 GFLOPs |
说白了:在一百万 token 的上下文下,GLM-5 每个 token 的计算主要花在索引器上;IndexShare 把这一项砍到 1/3.7,Flash 的索引层更少、又做了池化,这一项再降到约 1/7.6。我们算出的 GLM-5 到 GLM-5.3 约 2.7 倍,与 GLM-5.2 模型卡在 1M 上下文下“每 token FLOPs 降低 2.9 倍”的说法量级一致;不过模型卡没有写明基线和计数方法。
数字从哪来
- 激活参数: GLM-5.3 取 40B(与 GLM-5.2 同一个基座,744B / 40B),Flash 取 18B(来自其模型卡)。“FLOPs ≈ 2 × 激活参数”是常用估算,忽略了归一化、路由、mHC 混合和 MTP 层。
- 索引器: 两个模型都是
index_n_heads32 ×index_head_dim128。每次打分是 32 个头分别与同一个 128 维键做点积:$32 \times 128 = 4{,}096$ 次乘加,即 8,192 FLOPs。GLM-5.3:$21 \times 10^6 \times 8{,}192 \approx 172$ GFLOPs。Flash:$11 \times 250{,}000 \times 8{,}192 \approx 22.5$ GFLOPs。GLM-5 / 5.1(78 层全有):$\approx 639$ GFLOPs。 - 稀疏注意力: 吸收式 MLA 对每个选中的 576 维条目(512 + 64)打分,再按头对 512 维潜在向量加权求和。GLM-5.3:$2{,}048 \times 64 \times (576 + 512) \times 2 \times 78 \approx 22.2$ GFLOPs。Flash(没有 RoPE 部分,kernel 用零填充到 576 宽):$2{,}051 \times 64 \times (512 + 512) \times 2 \times 11 \approx 3.0$ GFLOPs。
- KDA: 每层每个头几次 128 × 128 运算:每层每个 token 递推核心约 7.3 MFLOPs,外围投影约 275 MFLOPs,与上下文长度无关(按形状推算,§8.2.6)。
- FLOPs 不等于时间。 解码往往受内存带宽限制,所以 §9.1、§9.2 的缓存大小和这张表同样重要。这些数字都不是实测。
9.5 模型卡怎么说,这笔账又说明不了什么
这笔账与 Flash 模型卡的方向一致。模型卡说混合架构“sharply reducing long-context serving costs while preserving precise long-context capabilities”(大幅降低长上下文服务成本,同时保留精确的长上下文能力),还说 Flash “outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price”(以十分之一的价格在各项基准和真实工作负载上超过 GLM-5.2)。价格对比的依据模型卡没有给出,基准结果也只有一张图片。
在通往相近索引器预算的两条路线中(§1.3),只有 Flash 同时缩小了增长型缓存。
10. 来自开源实现(Miles)的训练笔记
Z.ai 没有公开 GLM-5.3 和 GLM-5.3-Flash 的训练配方(GLM-5 报告提到 GLM-5 用的是它自家的 slime 框架)。我们之前解析过的开源 RL 框架 Miles 已经支持 GLM-5.3-Flash,这份代码是目前了解“如何把这个新混合架构跑进训练循环”的最好公开材料。本节整理它透露的信息。这里描述的是 Miles 如何用 RL 后训练 Flash,并不是 Z.ai 自己的配方。
10.1 基本配置
Flash 支持由 radixark/miles#2786 引入,配套 SGLang 分支 sglang-miles-glm53next 和 radixark/Megatron-LM#89。配方写在 Miles 仓库 的 docs/models/glm/glm5-3-flash.md 里。看数字之前,先注意两个选择:
- 训练时去掉 MTP。 §6 介绍的 MTP 层不参与这套 RL 训练。
- 流水线各段不均匀。 4 段流水线下,45 层按 11 / 11 / 11 / 12 切分,因为 45 不能被 4 整除。
训练配方本身很短:在 DAPO-Math-17k 数据集上跑 GRPO(Group Relative Policy Optimization,组相对策略优化;DAPO 本是一种 RL 配方,这里也是数据集的名字),Adam 优化器,学习率恒定为 $10^{-6}$,每张 GPU 最多 8,192 个 token,激活全部重计算。Rollout 与训练共置(colocated),训练端卸载到磁盘。两条 DSA 路径都用 TileLang kernel,KV cache 为 BF16,路由重放(R3)通过 --enable-r3 开启。
实现细节
文档给出的并行布局:
| 集群规模 | 张量并行(TP) | 流水线并行(PP) | 专家并行(EP) | Rollout 引擎 |
|---|---|---|---|---|
| 16 节点 × 4 GPU(完整模型) | 8 | 4 | 16 | 8 GPU,SGLang TP 8 / EP 8 |
| 8 节点 × 4 GPU(完整模型) | 8 | 4 | 8 | 8 GPU,SGLang TP 8 / EP 8 |
| 2 × 4 或 1 × 8 GPU(4 层切片) | 2 | 2 | 2 | 4 GPU,SGLang TP 4 / EP 4 |
- 启动命令:
python scripts/run_glm5_3_flash.py train --model-name GLM-5.3-Flash --num-nodes 16 --num-gpus-per-node 4 --num-rollout 20 --rollout-max-response-len 4096。冒烟测试用GLM-5.3-Flash-4layer切片,参数为--num-nodes 1 --num-gpus-per-node 8。 - 固定镜像为
docker.io/radixark/miles:glm53next(支持 GB300 和 x86),同时锁定 Miles、SGLang 和 Megatron-LM 三者的提交。 - 脚本的 docstring 和文档里“健康运行”一节都写的是“DAPO”,但脚本实际传的是
--advantage-estimator grpo,非对称裁剪 0.2 / 0.28,KL 和熵系数都为 0。我们的理解:“DAPO”指的是数据集(外加 clip-higher 设置),优势估计用的是 GRPO。 - 脚本中的 rollout 设置:每个 rollout batch 4 个 prompt,每个 prompt 采样 8 次,温度 0.8,数学奖励,每次 rollout 训练 1 步。
10.2 健康的运行是什么样子
Miles 文档给出了 #2786 中的一次验证运行,规模为 16 节点 × 4 张 GB300:
train/ppo_kltrain/grad_norm最该盯的是第一个指标。文档说 train/train_rollout_logprob_abs_diff 是“新环境初次跑通时第一个要看的指标:它同时覆盖 KDA、DSA 和超连接三条路径”。直白地说:SGLang 和 Megatron 各自计算每个采样 token 的对数概率。只要任何一边的 KDA、稀疏注意力路径或 mHC 残差混合实现得稍有不同,两个数就会分开。我们的理解是,差值在 0.01 左右,说明两个引擎高度一致。
10.3 代码透露的混合架构训练细节
读 Miles 里的 Flash 模型代码,能看到三件对训练者很重要的事:
- Miles 的 RL 不训练索引器。 闪电索引器的输入被 detach,打分在
torch.no_grad下进行,kpool 池化参数的requires_grad设为 False。另有可选的--freeze-indexer参数,会把索引器的投影也冻结。这与 GLM-5 报告的 RL 默认做法一致(§5.7);两份材料都没有说明 Z.ai 训练 GLM-5.3 或 Flash 时如何处理索引器。 - 索引器的选择可以重放。 除了 MoE 路由重放(R3),代码里还有一条可选的索引器重放路径,可以复用推理时选出的 top-k 位置。我们的理解:这样训练和 rollout 关注的是同一批 token。GLM-5 报告认为在 $k = 2{,}048$ 时做这种重放不现实,改用确定性 top-k(§5.7)。
- 上下文并行(CP)卡在 DSA 层。 KDA 层已经支持上下文并行,但只要 CP 大于 1,kpool 选择就会抛出
NotImplementedError。所以 Flash 目前只能用 CP 1 训练,无法把一条长序列拆到多张 GPU 上。
10.4 RL 中容易踩坑的对话模板细节
GLM-5.3 和 GLM-5.3-Flash 共用一套新的对话模板。两者的模板即使在 enable_thinking=False 时也会以 <think> 开始生成。因此 Miles 对这一系列固定 enable_thinking=True 和 clear_thinking=False,并要求 reasoning_effort 在整个会话中保持一致。智能体 rollout 指南用 --tito-model glm53 选择对应的 TITO 分词器(GLM-4.7、GLM-5 和 GLM-5.2 用 glm47)。对 Flash 而言,这项支持只覆盖文本输入,不覆盖多模态处理器。
两张模型卡都写了对应的推理参数。reasoning_effort 可取 low、high 或 max,默认 max,卡中建议复现评测时保持 max。clear_thinking 默认为 false,卡中要求聊天场景显式传 true。我们的理解:默认值会把之前的推理保留在上下文里,适合智能体循环,也让多轮 RL 时 token 前缀只追加、不改写;true 则在普通聊天中把它去掉。
GLM-5.3 本身呢?
Miles 没有单独的 GLM-5.3(非 Flash)页面;模型索引把 GLM-5 和 GLM-5.2 列为“744 B-A40B”。由于 GLM-5.3 的配置除 FP8 打包外与 GLM-5.2 相同,我们的理解是 Miles 里 GLM-5.2 的路径同样适用,但没有任何材料明确这么说。这条 GLM-5.2 路径就是我们 Miles 文章 第 9 节的 64 卡案例。这里没有任何信息表明 Z.ai 用 Miles 训练了 GLM-5.3。
11. 悬而未决的问题
单凭配置、模型卡、论文和 Miles 代码,哪些事我们定不下来?本节把这些缺口直接列出来,方便你分辨文中哪些说法依据的是我们的理解,而不是资料原文。
参数量与计数口径
- 744B 与 320B 两个总数。 我们的复算与两个官方数字都相差不到约 1%,但口径相反:旗舰的 744B(针对 GLM-5 / GLM-5.2 基座给出;GLM-5.3 卡片没有给参数量)只有不计 MTP 层时才对得上(§2.3),Flash 的 320B 只有计入 MTP 层和视觉编码器时才对得上(§8.9)。要么两个数字口径不同,要么 Flash 有我们没有建模的权重。safetensors 索引能解决这个问题,但我们手上没有。
没有文档说明的配置字段
index_share_for_mtp_iteration在 GLM-5.2、GLM-5.3 和 Flash 中都是true。从名字看,像是 MTP 层在多步草稿之间复用索引器结果,但没有资料证实。index_topk_pattern在 GLM-5.2 和 GLM-5.3 中为null。它也许是留给显式共享模式的接口,这只是猜测。- Flash 的
indexer_types把 45 层全部标成"full",包括 34 个根本没有索引器的 KDA 层。这些条目对 KDA 层意味着什么,没有文档说明。
Flash 的位置信息
- 旋转基数与索引器 RoPE。 Miles 文档、Miles 脚本和配置给出的旋转基数互相矛盾(旋转维度为 0 时这个值不起作用,所以我们不引用任何基数),配置还把
indexer_rope_interleave设为true,而 Miles 的索引器并不做旋转(见 §8.3 注)。参考的 HF 或 SGLang 实现是否在索引器里做部分 RoPE,我们无法核实。
依据论文而非代码描述的机制
- KDA 门控与 mHC 方程。 KDA 门控公式和分块大小取自 fla commit 8024667ab58f;Miles 只要求 fla ≥ 0.4.2,没有固定 commit,所以 Z.ai 训练时用的确切版本以及推理服务用的 kernel 都不在我们的资料中。mHC 的权重形状和混合方程在 radixark/Megatron-LM#89 里,我们没有查看;§8.6 采用公开发表的 mHC(arXiv:2512.24880)形式,约 35M 的 mHC 参数估算假设了一种形状。
GLM-5.2 与 GLM-5.3 是怎么训练的
- IndexShare 的训练。 GLM-5.2 和 GLM-5.3 采用规则的布局(前 3 层为 full,之后每 4 层一个),接近 IndexCache 论文中的均匀交错;论文发现这种做法不经训练直接套用会掉点,而用它的训练感知方法则大致追平完整 DSA(§5.6)。对 GLM-5,论文只说作者“计划在不久的将来”把训练感知 IndexCache 用到这个生产规模模型上;两张卡片都没有说 GLM-5.2 或 GLM-5.3 是否用了它。
- 1M 上下文。 GLM-5 报告的中期训练止于 200K token;GLM-5.2 如何扩展到 1,048,576 token(除了
rope_theta的变化),我们的资料没有描述(§6.1)。 - GLM-5.3 的后训练。 模型卡说相对 GLM-5.2 的提升全部来自后训练,但并不存在 GLM-5.3 技术报告。GLM-5 的配方只是谱系上的参考,不能确认就是 GLM-5.3 的做法。
Flash 的成绩与价格
- 基准。 Flash 模型卡的基准结果只有一张图片,Agents’ Last Exam 的脚注还是空的。我们不引用任何 Flash 分数。
- “十分之一的价格”。 模型卡没说比较的是哪种价格、哪个档位、哪个时间点。
其他小问题
- GLM-5 报告说模型有 80 层;所有配置都是 78 层加 1 个 MTP 层。
- Flash 的 MTP 层(第 45 层)有 DSA 注意力和 MoE FFN,但没有
hc_*参数。我们的理解是 mHC 没有包住这一层;Miles 训练时丢弃了 MTP,所以代码无法证实。 - GLM-5.3 采用自定义许可证(
other,glm-5.3),条款内容不在我们的资料里。GLM-5.2 和 Flash 是 MIT。 - GLM-5.2 模型卡的
new_version指向zai-org/GLM-5.3-BF16,而我们读到的 GLM-5.3 配置是 FP8 版本。BF16 与 FP8 两个仓库如何命名,并不完全清楚。
参考资料
论文
- GLM-5: from Vibe Coding to Agentic Engineering(arXiv:2602.15763):GLM-5 技术报告,涵盖 MoE、MLA、DSA 和后训练谱系。
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(arXiv:2603.12201):GLM-5.2 模型卡以 IndexShare 之名链接的论文。
- mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880):仅用于引用 mHC 公式。
- Kimi Linear(arXiv:2510.26692):KDA 的出处,§8.2 用到其更新规则、分块算法、混合比例消融和实验结果。
- DeepSeek-V3 技术报告(arXiv:2412.19437):背景资料,§4.3 的无辅助损失(
noaux_tc)偏置均衡。
模型卡与配置
开源实现
- radixark/miles:参见
docs/models/glm/glm5-3-flash.md与docs/models/glm/glm5-2.md。 - radixark/miles#2786:Miles 对 GLM-5.3-Flash 的支持。
- radixark/Megatron-LM#89:Megatron 一侧的实现,包括 mHC(本文未核查)。
- flash-linear-attention:Miles 调用的 KDA kernel;§8.2 阅读的是 commit 8024667ab58f 上的门控、分块训练与解码代码。
本站相关文章
- Miles v0.1 深度解析:R3、TITO 以及 GLM-5.2 744B 案例。