上下文到了百万 token,贵的就不再是模型权重。真正的账单是 KV cache:每个注意力层都要为每个 token 存一份键值,供后面的 token 回看;再加上每生成一个新 token 读这份缓存的计算量。DeepSeek-V3.2 已经压低了读的成本:它的 DeepSeek 稀疏注意力(DSA)让每个查询只读一小批选出来的历史 token。但它仍然在每一层为每个 token 存一条缓存。
DeepSeek-V4 瞄准的是账单的另一半:沿序列维度压缩缓存。一个小的可学习压缩器把每 4 个 token(或每 128 个 token)折成一条 512 维的条目,注意力读的是这些条目,而不是原始 token。每一层还会为最近 128 个 token 保留未压缩的键值。V4 的主干层里,没有任何一层对全部原始 token 做稠密注意力。
收益用 DeepSeek 自己的数字说:在 1M token 上下文下,DeepSeek-V4-Pro 的单 token 推理 FLOPs 只有 DeepSeek-V3.2 的 27%(估算值,按等效 FP8 FLOPs 计),KV cache 只有 10%,尽管它每个 token 激活的参数更多。更小的 DeepSeek-V4-Flash 只需 10% 的 FLOPs 和 7% 的缓存。Pro 有 1.6T 参数(每个 token 激活 49B),Flash 有 284B(激活 13B)。
本文逐层拆解这两个模型。所有内容都来自公开资料,并注明每条结论的出处:
- 论文:DeepSeek-V4 技术报告《DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence》(arXiv 2606.19348;摘要页显示提交于 2026 年 4 月 26 日)。
- 配置与模型卡:V4-Pro 与 V4-Flash 的 Hugging Face 仓库,后续发布的 V4-Pro-DSpark、V4-Flash-0731、V4-Pro-0813 与 V4-Flash-Vision-Exp,以及后继模型 DeepSeek-V4.1-Flash。
- 代码:仓库里附带的 DeepSeek 官方参考推理代码(
inference/model.py与kernel.py)。Pro 与 Flash 的model.py完全相同,区别只在配置。 - 第二份报告:DeepSeek-V4.1-Flash 技术报告,以 PDF 形式放在它的仓库里。
- 训练代码:Miles 中开源的 DeepSeek-V4 实现,Miles 本身我们在 Miles v0.1 深度解读里介绍过。
论文和代码不一致时,我们会直接指出。我们根据配置自己算出的数字(比如参数拆分、缓存大小)标为“按配置推算”;我们对证据的解读标为“我们的理解”。资料没有说的,我们也明说,并在 §14 汇总这些空白。
阅读本文需要知道什么是大语言模型(LLM)、注意力和 Transformer 层。V4 还建立在我们在 GLM-5.3 深度解读里讲过的几个概念上:多头潜在注意力(MLA,见该文 §3)、带偏置负载均衡的混合专家(MoE)路由(§4.3)、DSA 及其闪电索引器(lightning indexer,§5.1–5.4),以及流形约束超连接(mHC,§8.6)。本文对每个概念只用一两句话回顾,篇幅留给 V4 的不同之处。
各节层层递进:
- §1:家族总览:从 V3.2 到 V4 预览版,再到后续发布;外加一张 Pro 与 Flash 的对照表。
- §2:V4 逐层导览:一个 token 的旅程、每层注意力类型的排布,以及参数都在哪里(3D 模型:层堆叠)。
- §3:注意力核心:每个 token 一条 512 维向量,同时充当所有查询头的键和值;只作用于部分维度的旋转位置编码(RoPE),以及在输出上撤销的旋转;分组输出投影(3D 模型:共享 KV 注意力)。
- §4:KV 压缩器:按通道可学习地把 4 个或 128 个 token 汇聚成一条条目(3D 模型:压缩器)。
- §5:压缩稀疏注意力(CSA):闪电索引器挑出得分最高的压缩条目(3D 模型:一个 CSA 查询)。
- §6:重度压缩注意力(HCA):128 合 1,然后全部读取;以及 V4 为什么让两者交替(3D 模型:HCA 与 CSA 对比)。
- §7:mHC:4 路残差流,由一个双随机矩阵混合(3D 模型:残差流)。
- §8:MoE 层:384 或 256 个专家,每个 token 用 6 个;前三层用哈希路由;FP4 专家(3D 模型:专家之城)。
- §9:长上下文:位置编码到 1M,与 V3.2 对比 KV cache 和每 token 计算量,以及推理服务如何管理混合缓存(3D 模型:缓存随长度的变化)。
- §10:训练:数据、Muon 优化器、稳定性技巧,以及 FP4 量化感知训练(在后训练阶段使用)。
- §11:后训练与三种推理模式。
- §12:预览版之后:投机解码模块、0731 与 0813 正式版、视觉模型,以及 V4.1-Flash 的新设计。
- §13:来自 Miles 开源实现的训练笔记。
- §14:资料尚未回答的开放问题。
1. 家族总览
V4-Pro 和 V4-Flash 从哪里来,两者又有什么不同?本节先把它们放到 DeepSeek 的时间线上,再用一张表并排对比。一句话概括:一套架构、两种尺寸,外加一串沿用骨架、改进训练并加挂投机解码模块的后续版本。
1.1 从 V3.2 到 V4,以及之后的发布
按技术报告的说法,V4 从 DeepSeek-V3 继承了两样东西:DeepSeekMoE 的专家布局和多 token 预测(MTP)。从 DeepSeek-V3.2 那里,它拿来 DSA 的闪电索引器,用在两种新注意力中的一种里。注意力路径上的其余部分大多是新的(低秩查询投影是它保留的唯一 MLA 部件),残差连接也是新的。下面的动画梳理了整个家族。

| 模型 | 定位 | 总参数 / 激活参数 |
|---|---|---|
| DeepSeek-V3.2 | 前代:MLA 加 DSA | 671B / 37B |
| DeepSeek-V4-Pro(预览版) | 新架构,61 层 + 1 个 MTP 层,1M 上下文 | 1.6T / 49B |
| DeepSeek-V4-Flash(预览版) | 同一架构,43 层 + 1 个 MTP 层,1M 上下文 | 284B / 13B |
| DeepSeek-V4-Pro-DSpark | “并非新模型”(not a new model):Pro 的同一个 checkpoint,外挂一个投机解码模块 | 同 Pro |
| DeepSeek-V4-Flash-0731 | Flash 正式版,“取代预览版”(superseding the preview version);结构与 V4-Flash-DSpark 相同 | 同 Flash |
| DeepSeek-V4-Pro-0813 | Pro 正式版,沿用预览版结构,外挂 DSpark 模块 | 同 Pro |
| DeepSeek-V4-Flash-Vision-Exp | “DeepSeek-V4 家族首个实验性多模态模型”:V4-Flash 加视觉模块,再继续训练 | 未说明 |
| DeepSeek-V4.1-Flash | 新架构,带 Engram 记忆(按 token n-gram 查表的大型记忆,§12.4) | 552B 主干 + 196B Engram 记忆;解码激活 16B,预填充激活 8B |
表中各行按模型卡所暗示的顺序排列:后面的模型卡都建立在前面的模型之上,或拿前面的模型做对比。对后文最重要的有三点:
- 一副骨架。 预览版 Pro 和 Flash 共用一套架构、一份参考实现,只是尺寸不同(§1.2)。
- 骨架没变。 DSpark、0731、0813 和 Vision-Exp 都保留预览版的文本主干。速度来自投机解码模块,质量提升来自新的后训练;Vision-Exp 则加了视觉模块并继续训练(§12.1–12.3)。
- V4.1-Flash 才是真正的后继者。 它重新设计了注意力,是一个更大的不同模型(§12.4)。
我们读到的所有模型卡都采用 MIT 许可证。
日期与命名
- 资料中唯一能核实的日期是技术报告的:arXiv 摘要页写着“Submitted on 26 Apr 2026”,且只有第 1 版。但编号 2606.19348 通常对应 2026 年 6 月提交。我们只指出这处矛盾,不做裁定。
- 所有模型卡都没有写发布日期,所以表里不列日期。后缀 -0731 和 -0813 看起来是“月日”命名,指 7 月 31 日和 8 月 13 日;这是我们的理解,模型卡本身没有明说。
- 0731 的模型卡说 V4-Flash-0731 与“DeepSeek-V4-Flash-DSpark”结构相同。我们没有读到 V4-Flash-DSpark 的仓库,资料里只有 V4-Pro-DSpark。
- V3.2 一行的参数量取自 V4 模型卡基座模型表格中的“# Activated Params”和“# Total Params”两行(37B 与 671B)。
1.2 Pro 与 Flash 并排对比
Pro 和 Flash 的设计选择完全一致:注意力类型、512 维的头、128 token 的窗口、残差流和路由器都一样。不同的是宽度、深度和专家数,外加前两层的一个细节:
| DeepSeek-V4-Pro | DeepSeek-V4-Flash | |
|---|---|---|
| 总参数 / 激活参数 | 1.6T / 49B | 284B / 13B |
| 预训练 token 数 | 33T | 32T |
| 层数 | 61(+1 MTP) | 43(+1 MTP) |
| 隐藏维度 | 7,168 | 4,096 |
| 查询头数 × 头维度 | 128 × 512 | 64 × 512 |
| KV 头数 | 1(所有查询头共享) | 1 |
| 查询低秩宽度 | 1,536 | 1,024 |
| 输出投影 | 16 组,每组投到 1,024 | 8 组,每组投到 1,024 |
| 滑动窗口(每层都有) | 128 token | 128 token |
| 压缩比 | 4(CSA)和 128(HCA) | 4(CSA)和 128(HCA) |
| 注意力层构成 | 30 CSA + 31 HCA | 21 CSA + 20 HCA + 2 纯窗口 |
| 第 0–1 层 | HCA | 纯滑动窗口 |
| 索引器头数 × 维度 / 保留条目数 | 64 × 128 / 1,024 | 64 × 128 / 512 |
| 每层专家 | 384 路由 + 1 共享,top-6 | 256 路由 + 1 共享,top-6 |
| 专家中间维度 | 3,072 | 2,048 |
| 路由缩放系数 | 2.5 | 1.5 |
| 哈希路由层 | 0–2 | 0–2 |
| 残差流(mHC) | 4 路,20 次 Sinkhorn 迭代 | 4 路,20 次 Sinkhorn 迭代 |
| 词表 / 最大位置数 | 129,280 / 1,048,576 | 129,280 / 1,048,576 |
表里有几个术语,这里先给简短定义,后面各有专节。滑动窗口为最近 128 个 token 保留未压缩的键值。压缩比为 4,意思是每 4 个连续 token 对应一条缓存条目(§4)。CSA 层用索引器挑出固定数量的条目(§5);HCA 层每 128 个 token 折成一条,并全部读取(§6)。哈希路由层按 token ID 查一张固定表来选专家(§8.3)。
两个模型每个 token 只激活一小部分权重:Pro 是 3.06%,Flash 是 4.58%,V3.2 是 5.51%(按官方总参数推算)。Pro 虽然大得多,却是更稀疏的那个。
数字从哪来
- 所有结构类的行都来自两份
config.json(键名如num_hidden_layers、hidden_size、num_attention_heads、head_dim、num_key_value_heads、q_lora_rank、o_groups、o_lora_rank、sliding_window、index_n_heads、index_head_dim、index_topk、n_routed_experts、moe_intermediate_size、routed_scaling_factor、num_hash_layers、hc_mult、hc_sinkhorn_iters)。技术报告 §4.2.1 的模型设置重述了其中的结构类数值,给出的每一项都与配置一致;路由缩放系数、KV 头数、词表和最大位置数只来自配置。 - 层构成来自逐层列表
compress_ratios(Pro 62 项,Flash 44 项:每个主干层一项,MTP 层一项),§2.2 会逐项解读。报告也用文字说了同一件事。Flash:“For the first two layers, we use pure sliding window attention.” Pro:“For the first two layers, we use HCA.” - 总参数(1.6T / 49B 和 284B / 13B)来自报告和模型卡;token 数(Pro 33T,Flash 32T)来自报告。模型卡对两者都写的是“more than 32T”。
- 激活比例 = 激活参数 ÷ 总参数:49 / 1,600、13 / 284、37 / 671。
基座模型(后训练之前)和 V3.2 比怎么样?下面摘几行模型卡里的基座模型表:
| 基准(shot 数) | V3.2-Base | V4-Flash-Base | V4-Pro-Base |
|---|---|---|---|
| MMLU-Pro(5) | 65.5 | 68.3 | 73.5 |
| Simple-QA verified(25) | 28.3 | 30.1 | 55.2 |
| FACTS Parametric(25) | 27.1 | 33.9 | 62.6 |
| HumanEval(0) | 62.8 | 69.5 | 76.8 |
| LongBench-V2(1) | 40.2 | 44.7 | 51.5 |
| BBH(3) | 87.6 | 86.9 | 87.5 |
| BigCodeBench(3) | 63.9 | 56.8 | 59.2 |
| MATH(4) | 60.5 | 57.4 | 64.5 |
Pro-Base 在大多数行领先,知识类测试优势最大:Simple-QA verified 的分数接近 V3.2-Base 的两倍,FACTS Parametric 超过两倍。Flash-Base 的激活参数约为 V3.2 的三分之一,在多数行上胜过 V3.2-Base,但不是全部:在模型卡 25 个基准行中落后 7 行,最明显的是 BigCodeBench(56.8 对 63.9)和 MATH(57.4 对 60.5);在 BigCodeBench 和 BBH(87.6 对 86.9 / 87.5)上,V3.2-Base 还同时领先两个 V4 基座。
1.3 一个家族,两条故事线
后文按一个简单的划分展开。第一条故事线是预览版架构(§2–§11):V4 怎样压缩注意力、拓宽残差流、把 token 路由给专家,DeepSeek 又是怎样训练它的。这些内容对 Pro 和 Flash 都适用,只是各有各的数字。
第二条故事线是之后发生的事(§12)。0731 与 0813 正式版保持主干的权重形状不变,外挂一个投机解码模块,提升主要来自面向智能体(agentic)任务的后训练。随后 V4.1-Flash 重新设计了注意力,把 KV 压缩推得更远。
2. V4 逐层导览
一个 token 穿过 V4 时会经历什么?它要爬过一摞形状相同的层:先是注意力块,再是 MoE 块,两者都包在一个加宽的残差连接里。层与层的主要区别只有一处:注意力读的是哪种记忆。本节讲清楚每一层读什么。
2.1 一个 token 的旅程
下面以 V4-Pro 为例,括号里是 Flash 的尺寸。“隐藏状态”指 token 在层与层之间用来表示自己的那串数字。
- 嵌入。 用 token 的 ID 从一张 129,280 × 7,168 的表(Flash 为 × 4,096)里取出一行。
- 复制成四路。 把这个向量复制 4 份。此后每个 token 携带的残差是 4 × 7,168 个数,而不是一个向量。这就是 mHC(§7)。
- 注意力子层。 先用一个小的可学习混合把 4 路合成一个输入,然后经过 RMSNorm(一种尺度归一化)和注意力,再以可学习的方式写回全部 4 路。
- MoE 子层。 同样的套路:4 路混合成一路,RMSNorm,再进入 MoE 层。MoE 层有 384 个路由专家(Flash 为 256)加 1 个共享专家,每个 token 用 6 个路由专家和这个共享专家。最后写回。
- 重复 第 3–4 步,共 61 层(Flash 43 层)。
- 输出。 最后用一组 sigmoid 权重把 4 路合成一个向量,经过 RMSNorm 和输出投影(
lm_head)得到 129,280 个词表得分。输出投影不复用嵌入表。 - MTP 层。 额外一层,有自己的注意力和 MoE,多预测一个 token,并在训练时贡献 MTP 损失。报告说 MTP 配置与 V3 完全相同。
和 V3 一类的模型相比,这张清单里少了两样东西。一是没有稠密前馈层:每一层(包括第一层)都是 MoE。二是没有任何一层的注意力以全分辨率读取全部历史 token。
实现细节
model.py里,Transformer.forward先做嵌入,再沿新增的“流”维度复制(h.unsqueeze(2).repeat(1, 1, hc_mult, 1),hc_mult= 4)。每个Block.forward依次执行hc_pre→attn_norm→attn→hc_post,再执行hc_pre→ffn_norm→ffn→hc_post,两个子层的混合权重各自独立。- 最后的合并是
ParallelHead.hc_head:对 4 路做 sigmoid 加权,不经过 Sinkhorn。推理时只对最后一个位置计算 logits。 - MTP 块(
MTPBlock)复用主模型的嵌入和lm_head。它先分别归一化 token 嵌入和传入的隐藏状态(enorm、hnorm),再各用一个 7,168 × 7,168 的矩阵投影(e_proj、h_proj),两者相加后进入一个普通的Block。它有自己的流合并参数(hc_head_fn)。 Block总是构建MoE,没有类似first_k_dense_replace的开关。报告也写明:“We employ MoE layers in all Transformer blocks.”
在注意力子层里,V4 的每一层做的事都一样:拼出一张键列表,然后在上面做一次 softmax。列表开头总是最近 128 个 token 的原始键,也就是滑动窗口。后面接什么,取决于层的类型:
- CSA 层(压缩比 4):窗口,加上闪电索引器打分最高的压缩条目(每 4 个 token 一条),Pro 最多 1,024 条,Flash 最多 512 条。
- HCA 层(压缩比 128):窗口,加上所有已完成的压缩条目(每 128 个 token 一条)。
- 纯窗口层:只有窗口里的 128 个键。
每个头还有一个可学习的“sink”logit,加进 softmax 的分母,让这个头可以把权重放在“什么都不看”上(§3.4)。下面的动画展示两条压缩通道和窗口如何汇入同一个 softmax。

举个小例子。取 Pro 某个 CSA 层里位置 10,000 处的查询。窗口覆盖位置 9,873 到 10,000。位置 0 到 9,999 构成 2,500 个完整的 4-token 块,于是索引器给 2,500 条压缩条目打分,保留前 1,024 条。softmax 作用在 128 + 1,024 = 1,152 个键上。换成 HCA 层,同一个查询能看到 78 条已完成的 128-token 条目(78 × 128 = 9,984),加上窗口,一共 206 个键(以上计数均按代码规则推算)。
列表里的每个键都是同一种东西:一条 512 维向量,同时充当所有查询头的键和值。原始窗口 token 和压缩条目处在同一个 512 维空间里,所以一个 kernel 就能同时处理两者。§3 讲这条向量,§4 讲压缩条目怎么来。
实现细节
- 在
Attention.forward中,窗口索引来自get_window_topk_idxs(最近 128 个位置,含查询自身)。CSA 层追加索引器的 top-k(min(index_topk, 已完成条目数));HCA 层追加全部已完成条目(get_compress_topk_idxs)。两部分索引一起交给一次sparse_attn调用,并带上每个头的attn_sink。 - 对压缩比 $r$,第 $j$ 块的压缩条目要等整块完成才可见,即查询位置 $s$ 满足 $s \ge jr + r - 1$。例子里位置 10,000 正好开启一个新的 4-token 块(10,000 = 4 × 2,500),所以查询看到第 0 到 2,499 块;它自己的 token 由窗口覆盖。
- 没有任何门控或第二个 softmax 去平衡窗口与压缩部分。两者在同一个 softmax 里竞争。
2.2 层的排布
哪些层是 CSA,哪些是 HCA,哪些只有窗口?配置用一个列表回答:compress_ratios,每层一个数,4 表示 CSA,128 表示 HCA,0 表示纯窗口。最后一项属于 MTP 层。两个列表逐层读出来是这样:
| 层 | 0 | 1 | 2 | 3 | 4 | 5 | … | 最后一个主干层 | MTP |
|---|---|---|---|---|---|---|---|---|---|
| Pro | 128 | 128 | 4 | 128 | 4 | 128 | … | 4(第 60 层) | 0 |
| Flash | 0 | 0 | 4 | 128 | 4 | 128 | … | 4(第 42 层) | 0 |
从第 2 层起,两个模型都交替排布:偶数层是 CSA,奇数层是 HCA,最后一层是 CSA。数一数:
- Pro(61 层):第 0–1 层是 HCA。第 2–60 层里有 30 个 CSA 层(2, 4, …, 60)和 29 个 HCA 层(3, 5, …, 59)。合计 30 CSA + 31 HCA,没有纯窗口的主干层。
- Flash(43 层):第 0–1 层是纯窗口。第 2–42 层里有 21 个 CSA 层(2, 4, …, 42)和 20 个 HCA 层(3, 5, …, 41)。合计 21 CSA + 20 HCA + 2 纯窗口。
- MTP 层(两者相同):纯窗口。
还有两个逐层开关挂在同一个层号上。第 0、1、2 层的 MoE 用哈希路由:一张固定表把每个 token ID 映射到它的 6 个专家(§8.3)。RoPE 也随层类型变化:压缩层用 160,000 的 RoPE 基数,并用 YaRN(一种把 RoPE 拉伸到更长上下文的方法)缩放到 1M 个位置;纯窗口层用基数 10,000,不用 YaRN(§9.1)。论文正文没有讨论 YaRN,这部分来自配置和代码。
下面的 3D 模型把两份排布并排堆起来;悬停在某一层上,可以看到它的类型、RoPE 设置,以及在选定上下文长度下一个查询要读多少个键。
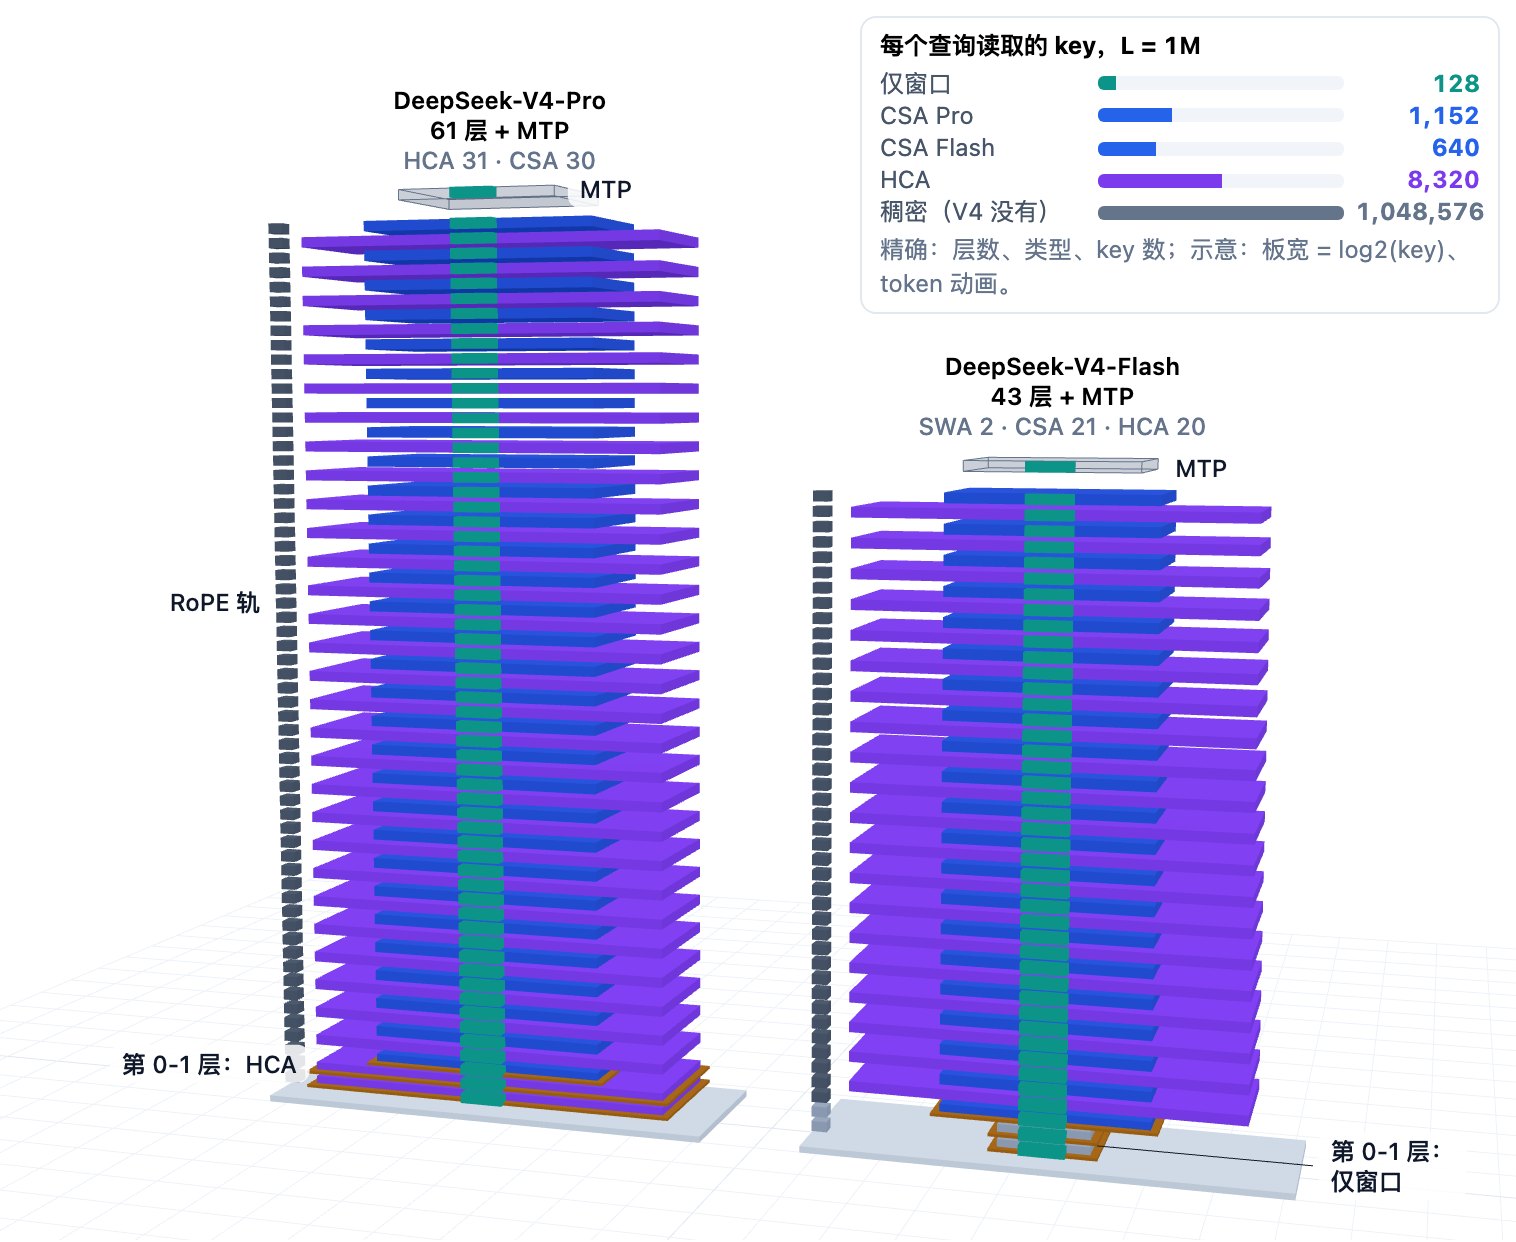
所以,V4 里没有任何稠密的全注意力层。每个主干层都读 128 token 的窗口;除了 Flash 的前两层,其余各层还会读一份压缩记忆。
实现细节
- 列表长度为 62 项(Pro)和 44 项(Flash)。MTP 块构建时用的是
layer_id = n_layers + i,所以它读最后一项,两个模型都是 0。 - 压缩比为 0 的
Attention不构建压缩器,KV cache 恰好 128 个槽位,并把original_seq_len设为 0 以关闭 YaRN(代码注释写着“disable YaRN and use base rope_theta in pure sliding-window attention”)。压缩层的注意力、压缩器和索引器共用一张 RoPE 表。 - 后来的配置(DSpark、0731、0813、Vision-Exp)多出两项:Pro 64 项,Flash 46 项,末尾都是 0。它们还新增了
dspark_block_size: 5和dspark_target_layer_ids(Pro 为 [58, 59, 60],Flash 为 [40, 41, 42])。我们的理解是,多出的两项对应投机解码模块自己的纯窗口块;配置本身没有标注(§12.1)。
2.3 参数都在哪里
V4 几乎所有权重都在路由专家里,而每个 token 每层只碰其中 6 个。下表是我们按配置里的张量形状自己数的;官方总数是 1.6T / 49B(Pro)和 284B / 13B(Flash)。
| 组件(按配置推算) | Pro | Flash |
|---|---|---|
| 注意力核心(查询、KV 与输出投影),全部层 | 18.3B(每层 299.9M) | 4.6B(每层 107.0M) |
| 压缩器与索引器 | 1.2B | 0.5B |
| 路由专家 | 1,547.4B(每个 66.1M) | 277.0B(每个 25.2M) |
| 共享专家 | 4.0B | 1.1B |
| 路由器 | 0.17B | 0.05B |
嵌入 + lm_head |
1.9B | 1.1B |
| 合计(主干层) | ≈ 1,573B | ≈ 284B |
| 路由专家占比 | 98.4% | 97.4% |
| 每 token 激活(每层 6 个路由专家 + 1 个共享专家,加上其余全部) | ≈ 49.7B | ≈ 13.8B |
我们的计数和官方数字很接近,这张表也勾勒出两个模型的形状。专家几乎占了全部参数,但在激活参数里,注意力占了很大一块。Pro 的注意力连同压缩器和索引器约 19.5B,占 49.7B 激活参数的 39%(按配置推算);Flash 是 13.8B 中的 5.1B(37%)。
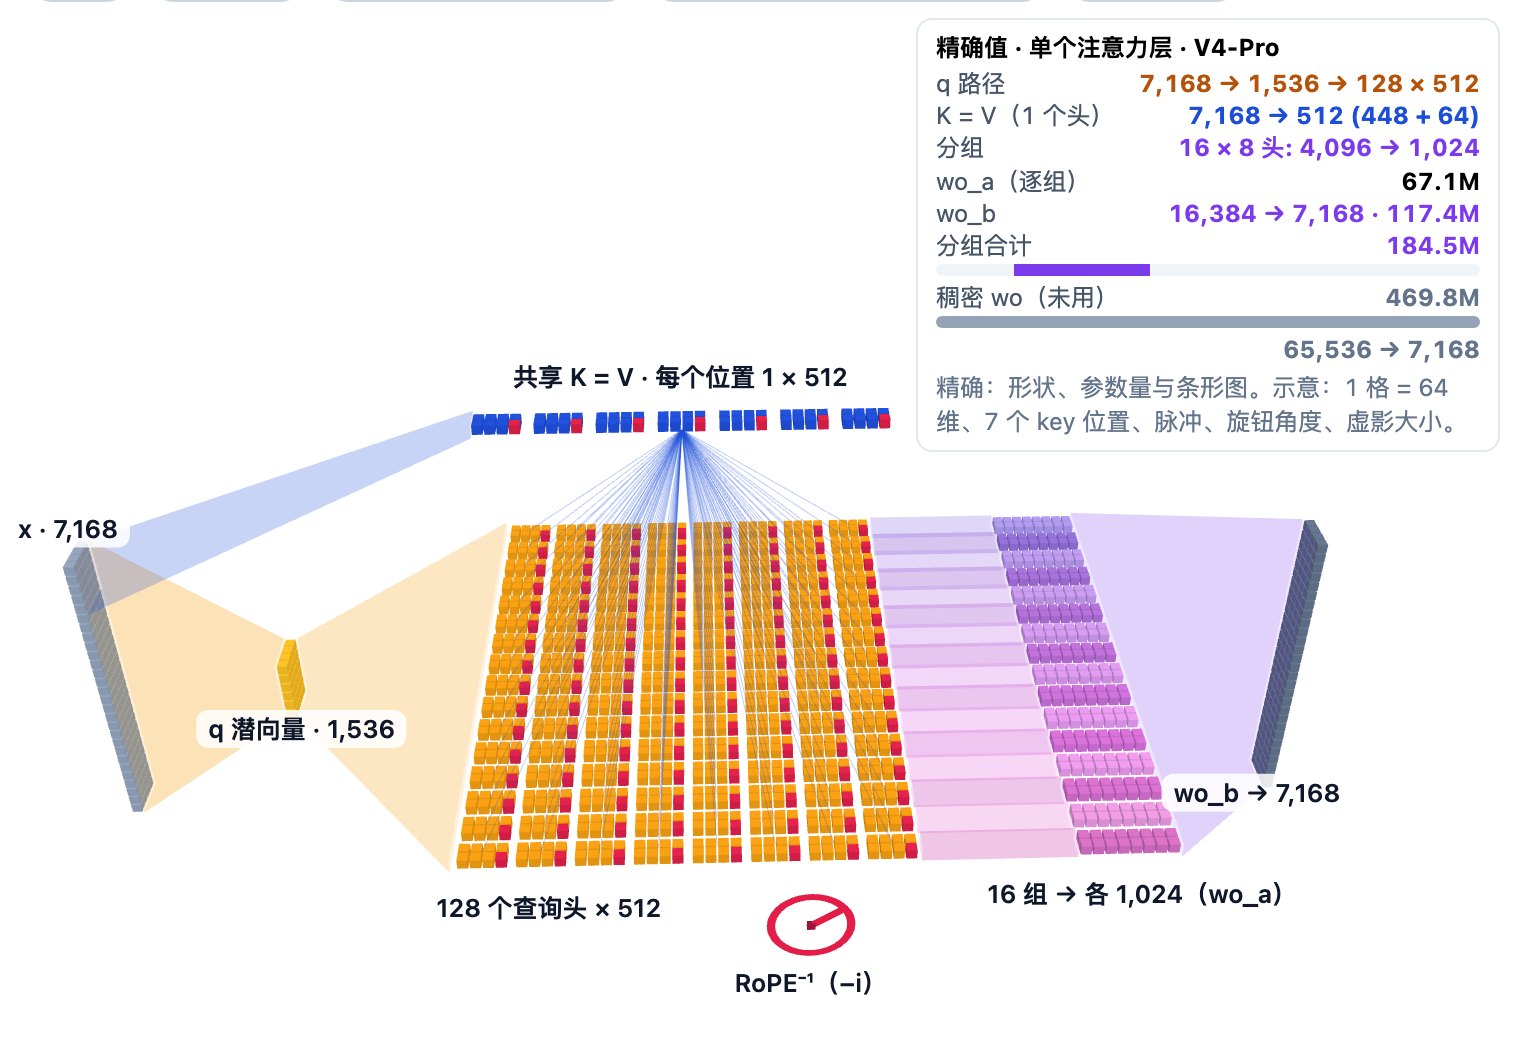
要不是有一个技巧,注意力还会更大。从 128 个头 × 512 = 65,536 维稠密投影到 7,168 维,每层需要 469.8M 参数。V4 的分组低秩投影只要 184.5M,每层省下约 285M,Pro 的 61 层合计约 17.4B(按配置推算)。Flash 每层是 67.1M,而稠密投影要 134.2M。§3.5 讲分组是怎么做的。
我们怎么数的
- 每层注意力核心:
wq_a(7,168 × 1,536)+wq_b(1,536 × 65,536)+wkv(7,168 × 512)+wo_a(16 组 × 1,024 × 4,096)+wo_b(16,384 × 7,168)= 11.0M + 100.7M + 3.7M + 67.1M + 117.4M = 299.9M(Pro)。Flash:4.2M + 33.6M + 2.1M + 33.6M + 33.6M = 107.0M。 - 压缩器与索引器:每个 CSA 层多出 31.4M(Pro)或 19.1M(Flash),包括它的 KV 压缩器、索引器自己的压缩器、索引器查询投影和头权重;每个 HCA 层多出一个 7.41M 或 4.26M 的压缩器。纯窗口层不额外增加参数。
- 专家:一个 SwiGLU 专家有三个矩阵,3 × 7,168 × 3,072 = 66.1M(Pro),或 3 × 4,096 × 2,048 = 25.2M(Flash)。路由器每层是 384 × 7,168(或 256 × 4,096)。
- 未计入:RMSNorm 权重、注意力 sink,以及 mHC 混合权重(Pro 每个子层 24 × 28,672 = 688,128,全模型约 84M)。
- MTP 层:它会给 Pro 增加约 25.7B(我们的计数随之变为约 1,599B,与“1.6T”吻合),给 Flash 增加约 6.6B(约 290.6B,高于官方的 284B)。Pro 的计数无论算不算 MTP 都约等于 1.6T,Flash 却只有不算 MTP 层时才吻合 284B。所以官方总数是否包含 MTP 层并不清楚,我们只把这种吻合视为近似。
- 把嵌入表算作“激活参数”是一种常见口径;实际上一个 token 只读其中一行。
3. 注意力核心:每个 token 一个 512 维向量,128 个头共用
不管一层拿到的是哪些 key,V4 每个注意力层跑的都是同一套核心计算。这一节回答一个问题:拿到要读的 key 列表之后,这一层具体做什么?核心思路是彻底共享。每个缓存位置只存一个向量,这一个向量同时充当所有查询头的 key 和 value。其余设计(很宽的头、窄的查询瓶颈、输出端的位置修正、更省的输出投影)都是为了让这种共享成立。
3.1 先说思路:K = V,只有一个头
标准多头注意力里,每个头对每个 token 都有自己的 key 和 value。V4 对每个缓存条目只存一个 512 维向量。条目可以是 128 token 窗口里的原始 token,也可以是 §4 产生的压缩块。所有查询头(Pro 128 个,Flash 64 个)读的都是同一个向量,而且用两次:打分时当 key,加权求和时当 value。
这是多查询注意力(Multi-Query Attention,MQA)再往前一步:所有查询头共用一个 key/value 头,而且 key 和 value 就是同一个向量。配置里 num_key_value_heads 为 1、head_dim 为 512;参考代码只用一个投影生成每个原始(窗口)条目:wkv = Linear(dim, 512);压缩条目则来自压缩器(§4)。技术报告称之为 “Shared Key-Value MQA”,每个条目 “serves as both attention key and value”。
举个例子:看 Pro 某一层里的一个 token。如果按经典做法给 128 个头各配一个 512 维的 key 和 value,这个 token 要存 $128 \times 512 \times 2 = 131{,}072$ 个数;V4 只存 512 个,少 256 倍(我们的算术,仅作示意)。
| 每头独立的 key/value(经典多头注意力,MHA) | MLA(DeepSeek-V2/V3、GLM-5.3) | V4 共享 KV 的 MQA | |
|---|---|---|---|
| 每个 token 或条目缓存什么 | 每个头一个 key、一个 value | 512 维潜向量 + 64 维 RoPE key | 一个 512 维向量 |
| 各头怎样拿到 key 和 value | 直接读取 | 按头重新展开(或吸收进查询) | 缓存向量本身就是 key 和 value |
| KV 上投影 | 不需要 | 有 | 没有 |
读过 GLM-5.3 那篇(§3)的读者,要特别注意它和 MLA 的区别。MLA 缓存的也是 512 维向量,但那是潜向量:每个头要通过上投影矩阵从中重建自己的 key 和 value,位置信息走一个单独的 64 维 key。V4 完全没有上投影,512 个数原样使用,位置信息也藏在这 512 个数里面(§3.3)。
数字从哪来
- 配置(
DeepSeek-V4-Pro与DeepSeek-V4-Flash的config.json):head_dim512,num_key_value_heads1,num_attention_heads128(Pro)和 64(Flash),qk_rope_head_dim64。报告自己列出的超参数取值相同($c = 512$,$n_h$ = 128 / 64)。 - 参考代码(
inference/model.py的Attention类;Pro 和 Flash 仓库里这个文件完全相同):wkv = Linear(dim, head_dim),后接kv_norm = RMSNorm(512)。注意力 kernelsparse_attn(kernel.py)接收的kv是一个[batch, n, 512]张量,没有头这一维,打分和加权求和用的是同一个张量。 - 命名:类的 docstring 仍写着 “Multi-head Latent Attention (MLA)”,但结构是 K = V 的单头 MQA,报告也称之为 “Shared Key-Value MQA”(式 18-19)。
- 存储:报告把 64 个 RoPE 维度存成 BF16,其余 448 维存成 FP8,体积接近纯 BF16 的一半(原文 “nearly half”)。按我们的计算,每个条目是 $448 \times 1 + 64 \times 2 = 576$ 字节,而不是 1,024 字节。每层具体缓存什么见 §4.3。
由此直接带来一个系统层面的好处。这是我们读 kernel 得出的理解,报告没有这样说。sparse_attn 每次把 64 行 key 搬进片上高速内存,只搬一次;这一份拷贝先给本 GPU 上的每个头(Pro 最多 128 个)算分数,几行之后又拿来做加权求和,所以一次读取最多完成 $2 \times 128$ 份工作。解码阶段的瓶颈正是读缓存,这种复用很对路。
3.2 查询路径:与索引器共用的低秩潜向量
key 这一侧只有一个投影。查询这一侧更宽,因为每个头都要一个自己的 512 维查询。V4 先把 token 压进一个窄瓶颈,即潜向量,再展开成各头的查询,这和 MLA 处理查询的低秩做法相同。以 Pro 的一个 token 为例(括号里是 Flash):
- 下投影。 隐状态 $x$(7,168 维;Flash 4,096 维)经
wq_a变成 1,536 维潜向量(Flash 1,024 维)。 - 归一化潜向量。 经过带可学习权重的 RMSNorm
q_norm,得到潜向量 $c^Q$,代码里叫qr。 - 上投影。
wq_b把 $c^Q$ 展开成 $128 \times 512 = 65{,}536$ 维(Flash $64 \times 512 = 32{,}768$),每个头一个 512 维查询。 - 逐头缩放。 每个头的查询除以自身的均方根,缩放后每个头的 RMS 都是 1。这一步没有可学习权重。
- key 侧。 与此同时,
wkv把 $x$ 映射成 512 维窗口条目,再由带可学习权重的 RMSNormkv_norm归一化。
报告用两个矩阵写出同一条路径:
\[c^Q_t = h_t\, W^{DQ}, \qquad [\,q_{t,1};\, q_{t,2};\, \dots;\, q_{t,n_h}\,] = c^Q_t\, W^{UQ}\]直白地说:先把 token 压到 1,536 维,再扇出到 128 个头。按形状推算,Pro 的 wq_a 加 wq_b 约 111.7M 参数;直接从 7,168 维投到 65,536 维则要 469.8M。
两处归一化是为了稳定。报告说,对每个查询头和唯一的 KV 头做 RMSNorm,可以避免 attention logit 爆炸(原文 “avoids exploding attention logits”);也正因如此,V4 的 Muon 优化器(§10)没有使用 QK-Clip 这种截断 logit 的技巧(Liu et al., 2025)。归一化给 logit 设了上限,下面用一个小例子看这个上限。
举个例子:第 4 步之后,RMS 为 1 的 512 维查询长度是 $\sqrt{512} \approx 22.6$。假如 key 的 RMS 也是 1(即 kv_norm 的可学习权重全为 1),两者点积最大只有 512,乘上 softmax 缩放 $512^{-1/2}$ 后,logit 最大约 22.6,不论隐状态变得多大(我们的算术;可学习权重会移动这个上限,但上限始终有限)。
潜向量 $c^Q$ 还有第二个用户。在 CSA 层里,闪电索引器(lightning indexer,负责挑选读哪些压缩块的小打分器)用另一组上投影,从同一个 qr 生成自己的查询。报告原话是 “the latent query vector is shared with that used for the indexer queries”。索引器一侧见 §5.2。
实现细节
- 代码(
model.py的Attention.forward):qr = q = self.q_norm(self.wq_a(x)),然后q = self.wq_b(q)展开成[heads, 512],再执行q *= torch.rsqrt(q.square().mean(-1, keepdim=True) + self.eps)。索引器的调用是self.indexer(x, qr, ...)。 - 论文与代码的差别:报告写的是 “RMSNorm operation on each head of the queries”。参考代码里这一步逐头操作不带可学习缩放;可学习缩放在
q_norm(作用于 1,536 维潜向量)和kv_norm(作用于 512 维条目)里。压缩条目则经过压缩器自己的 RMSNorm(§4)。 - 训练框架 Miles 的做法一致:查询下投影、归一化、上投影,然后在 FP32 下做不带权重的逐头 RMS 缩放。
- 参数量(按配置形状推算;
attention_bias为 false,没有偏置):Pro 的wq_a为 $7{,}168 \times 1{,}536 \approx 11.0$M,wq_b为 $1{,}536 \times 65{,}536 \approx 100.7$M,wkv为 $7{,}168 \times 512 \approx 3.7$M。Flash 分别是 4.2M、33.6M 和 2.1M。
3.3 部分 RoPE,以及输出端的反向旋转
注意力需要知道 token 在哪里。RoPE 按位置把查询和 key 的维度两两成对旋转一个角度,旋转角与位置成正比,这样查询与 key 的分数只取决于两者的距离。V4 只旋转向量的一部分:每个查询头和每个 KV 条目的 512 维里,前 448 维不带位置(NoPE,即“无位置编码”),后 64 维参与旋转。
这种布局相当于缩小版的 MLA 解耦 RoPE,但有一个关键不同。MLA 里旋转过的 key 是一个单独的小向量,只用来打分。V4 里旋转过的 64 维就在条目内部,而条目同时也是 value。于是一个头输出的加权和里混进了旋转过的分量,每一份都带着对应 key 的绝对位置。
报告把问题和解法都说清楚了:既然 KV 条目 “serve as both attention keys and values, the naive core attention outputs will carry absolute position embeddings”。对策是在每个输出的后 64 维上施加 “RoPE with position $-i$”。报告这里的记号不严谨;参考代码表明转回的角度是查询位置的相反数:注意力 kernel 算完之后,用查询旋转的共轭,把输出的后 64 维转回去。
为什么这样可行?看一对旋转维度即可。记 $R(\phi)$ 为把二维向量旋转 $\phi$ 角,$\theta$ 是这一对维度的频率,$u_j$ 是条目 $j$ 旋转前的这一对数。头的输出是 $\sum_j p_j R(\theta j)\, u_j$,其中 $p_j$ 是注意力权重。按查询位置 $i$ 转回去,得到
\[R(-\theta i) \sum_j p_j\, R(\theta j)\, u_j \;=\; \sum_j p_j\, R\big(\theta (j - i)\big)\, u_j ,\]因为二维旋转的角度可以直接相加。
举个例子:取 $\theta = 10^\circ$,key 在位置 3,查询在位置 5。这个 key 的分量存进去时转了 $30^\circ$,输出又反转 $50^\circ$,所以它最终以 $-20^\circ$ 的净角度计入。把两个 token 都往后挪 100 个位置(103 和 105),净角度仍是 $-20^\circ$。传给下一层的东西只取决于查询与 key 的距离,与它们在文档中的绝对位置无关。
报告用一句话说明目的:加上反向旋转后,“the contribution of each KV entry to the core attention outputs will also be related to the distance between the query and the KV entry”。至于 DeepSeek 为什么不像 MLA 那样保留一个单独的旋转 key,资料没有说明。我们的理解是:这样一个 512 维向量就能包揽全部工作,不需要再缓存第二份东西。
实现细节
- 代码(
model.py):注意力之前,apply_rotary_emb(q[..., -64:], freqs_cis),kv[..., -64:]同样处理;注意力之后,apply_rotary_emb(o[..., -64:], freqs_cis, True),True表示“取共轭”,也就是反向旋转同样的角度。freqs_cis按查询位置取值,所以每个输出都按自己查询的位置转回去。Miles 训练时也一样,在稀疏注意力 kernel 之后立刻做这一步。 - 配对方式:代码把 64 维看成由相邻两维组成的 32 个复数,每个频率旋转第 $(2k, 2k{+}1)$ 维。
- 精度:参考代码把每个窗口条目的 448 个 NoPE 维度按 64 一块伪量化为 FP8,与量化感知训练保持一致,而 “rope dims stay bf16 for positional precision”(代码注释)。这与报告的 BF16/FP8 混合存储格式吻合。
- 压缩条目的位置:压缩块按其第一个 token 的位置旋转(§4.2),所以上式中的 $j$ 就是这个位置。
- 频率:压缩层使用 RoPE base 160,000 并启用 YaRN;纯窗口层(Flash 的第 0、1 层,以及两个模型的 MTP 层)使用 base 10,000,不启用 YaRN(§2.2、§9)。
3.4 一个 softmax、一个 sink,再加窗口
每一层交给核心计算的是一份位置列表。第一部分永远是滑动窗口:最近 128 个原始 token,包括当前 token。第二部分取决于层的类型:CSA 层是 top-k 个压缩块(§5),HCA 层是所有已完成的压缩块(§6),纯窗口层则没有这部分。代码把两部分拼成一份索引列表。
随后,一个 kernel sparse_attn 一次扫完整份列表。原始窗口条目和压缩条目处在同一个 512 维空间里,用同一个查询打分,在同一个 softmax 里竞争。窗口和压缩部分没有各自的 softmax,也没有可学习的门控去混合“窗口输出”和“压缩输出”。代码里不存在这样的分支或权重。
softmax 之上还有一个注意力 sink:每个头一个可学习的数 $z’_h$,它进入分母,但不带任何 value。头 $h$ 中查询 $i$ 对条目 $j$ 的权重如下(式 27;logit 的定义和 $1/\sqrt{512}$ 缩放取自参考代码):
\[s_{h,i,j} \;=\; \frac{\exp(z_{h,i,j})}{\sum_k \exp(z_{h,i,k}) \;+\; \exp(z'_h)}, \qquad z_{h,i,j} = \frac{q_{i,h} \cdot c_j}{\sqrt{512}},\]其中 $c_j$ 是 §3.1 的共享条目。头的输出为 $o_{i,h} = \sum_j s_{h,i,j}\, c_j$。
举个例子:某个头看到三个条目,logit 分别是 2、1、0,sink logit 为 1。没有 sink 时权重是 0.665、0.245、0.090,加起来等于 1。加上 sink 后变成 0.534、0.197、0.072,加起来只有 0.803,剩下的 0.197 分给了“什么都不看”。报告的说法是:sink 让每个头的注意力总和可以 “not equal to 1, and even to be near 0”。一个头没有值得读的东西时,可以保持安静。
实现细节
- 索引列表(
model.py):get_window_topk_idxs给出 128 个窗口位置(序列开头不足时用 $-1$ 填充);压缩索引来自索引器(比率 4)或get_compress_topk_idxs(比率 128),再由torch.cat拼接。预填充时代码在[所有 token 的原始 kv ; 压缩 kv]上做注意力;解码时窗口是每层缓存最前面的 128 槽环形缓冲区。 - Kernel(
kernel.py的sparse_attn):每次收集 64 行,把 $-1$ 索引屏蔽为 $-\infty$,并像 FlashAttention 那样维护运行中的最大值和累加和。循环结束后,先把exp(attn_sink[h] - max)加进累加和,再做除法。sink 只影响分母。 - 缩放:
softmax_scale = head_dim ** -0.5$= 512^{-1/2}$。 attn_sink是 FP32 参数,每个查询头一个(Pro 128 个,Flash 64 个)。报告注明这一技巧出自 OpenAI(2025)和 Xiao et al.(2024)。
3.5 分组低秩输出投影
头宽了,出口就贵。Pro 的 128 个头输出合起来有 $128 \times 512 = 65{,}536$ 维,要映射回 7,168 维的隐状态。如果用一个稠密输出矩阵,每层需要 $65{,}536 \times 7{,}168 \approx 469.8$M 参数。报告说这样做 “will impose a substantial computational burden”,于是换成两段式的分组输出投影:
- 分组。 128 个头按顺序分成 $g = 16$ 组,每组 8 个头,每组输出 $8 \times 512 = 4{,}096$ 维。
- 组内压缩。 每组有自己的矩阵(
wo_a中属于该组的一片),把 4,096 维压到 1,024 维(o_lora_rank)。 - 拼接。 16 组压缩结果拼成 $16 \times 1{,}024 = 16{,}384$ 维。
- 混合。 一个稠密矩阵
wo_b把 16,384 维映射到 7,168 维隐状态。
Flash 按自己的尺寸照搬:64 个头分成 8 组,每组 8 个头(4,096 维),各压到 1,024 维,拼成 8,192 维,再映射到 4,096 维。
写成公式,记 $o^G_{t,k}$ 为第 $k$ 组的 4,096 维输出:
\[o'_{t,k} = o^G_{t,k}\, W^{A}_k \in \mathbb{R}^{1024}, \qquad \hat{o}_t = [\,o'_{t,1};\, \dots;\, o'_{t,g}\,]\, W^{B} \in \mathbb{R}^{d}\]举个例子:Pro 的第 3 组是第 24 到 31 个头(从 0 开始数)。它在 wo_a 里的那一片把这 4,096 维变成 1,024 维,参数量 $1{,}024 \times 4{,}096 \approx 4.19$M。16 片这样的矩阵加上 wo_b,取代了原来那个大矩阵。
| 每层(按配置形状推算) | Pro | Flash |
|---|---|---|
| 头输出总维度($n_h \times 512$) | 65,536 | 32,768 |
| 组数 × 每组头数 | 16 × 8 | 8 × 8 |
wo_a(全部组) |
67.1M | 33.6M |
wo_b |
117.4M | 33.6M |
| 分组方案合计 | 184.5M | 67.1M |
| 对照:稠密输出矩阵 | 469.8M | 134.2M |

按我们的计算,Pro 每层省下约 285M 参数,Flash 每层省下约 67M。每个 token 的计算量同比例下降,因为矩阵乘向量大约每个权重两次运算:Pro 每层每个 token 约 369M 次运算,稠密方案约 940M 次(推算值)。512 维宽头的代价,就在这里赚了回来。
我们对这个结构的理解:第一段是块对角的,每组只混合自己的 8 个头。整个投影因此等于 16 份之和,每组一份;每一份都要经过 1,024 维,所以每组那一份的秩最多是 1,024;整个映射的秩仍可达到 7,168。正因为每组是低秩结构,代码才把它叫作 “grouped low-rank” 投影,并把这个宽度命名为 o_lora_rank。报告没有分析这样做损失多少质量。
实现细节
- 代码(
model.py):wo_a = ColumnParallelLinear(n_heads*head_dim // n_groups, n_groups*o_lora_rank),wo_b = RowParallelLinear(n_groups*o_lora_rank, dim)。前向时o被看成[batch, seq, groups, 4096],wo_a.weight被看成[groups, 1024, 4096],再由torch.einsum("bsgd,grd->bsgr", o, wo_a)让每组用自己的那一片。 - 精度:参考代码用 BF16 构建
wo_a;有一条注释说明wo_a在 checkpoint 里是 FP8,改用 FP8 einsum 会更快。 - 并行(我们的理解):代码像切分头一样把组分到各 GPU 上(
n_local_groups = n_groups // world_size)。每个 GPU 用wo_a处理自己的头时无需通信,只有行并行的wo_b需要跨 GPU 求和。Miles 的切法相同:先做列并行的逐组投影(linear_o_group_proj),再做行并行的linear_proj,并断言o_lora_rank等于 1,024。 - 配置:
o_groups为 16(Pro)和 8(Flash),o_lora_rank两者都是 1,024;与报告里的 $g$ 和 $d_g$ 一致。
下面的 3D 模型覆盖两个模型,从查询路径一直走到分组输出投影,把整层串起来。
4. KV 压缩器:把 4 个或 128 个 token 学成一条
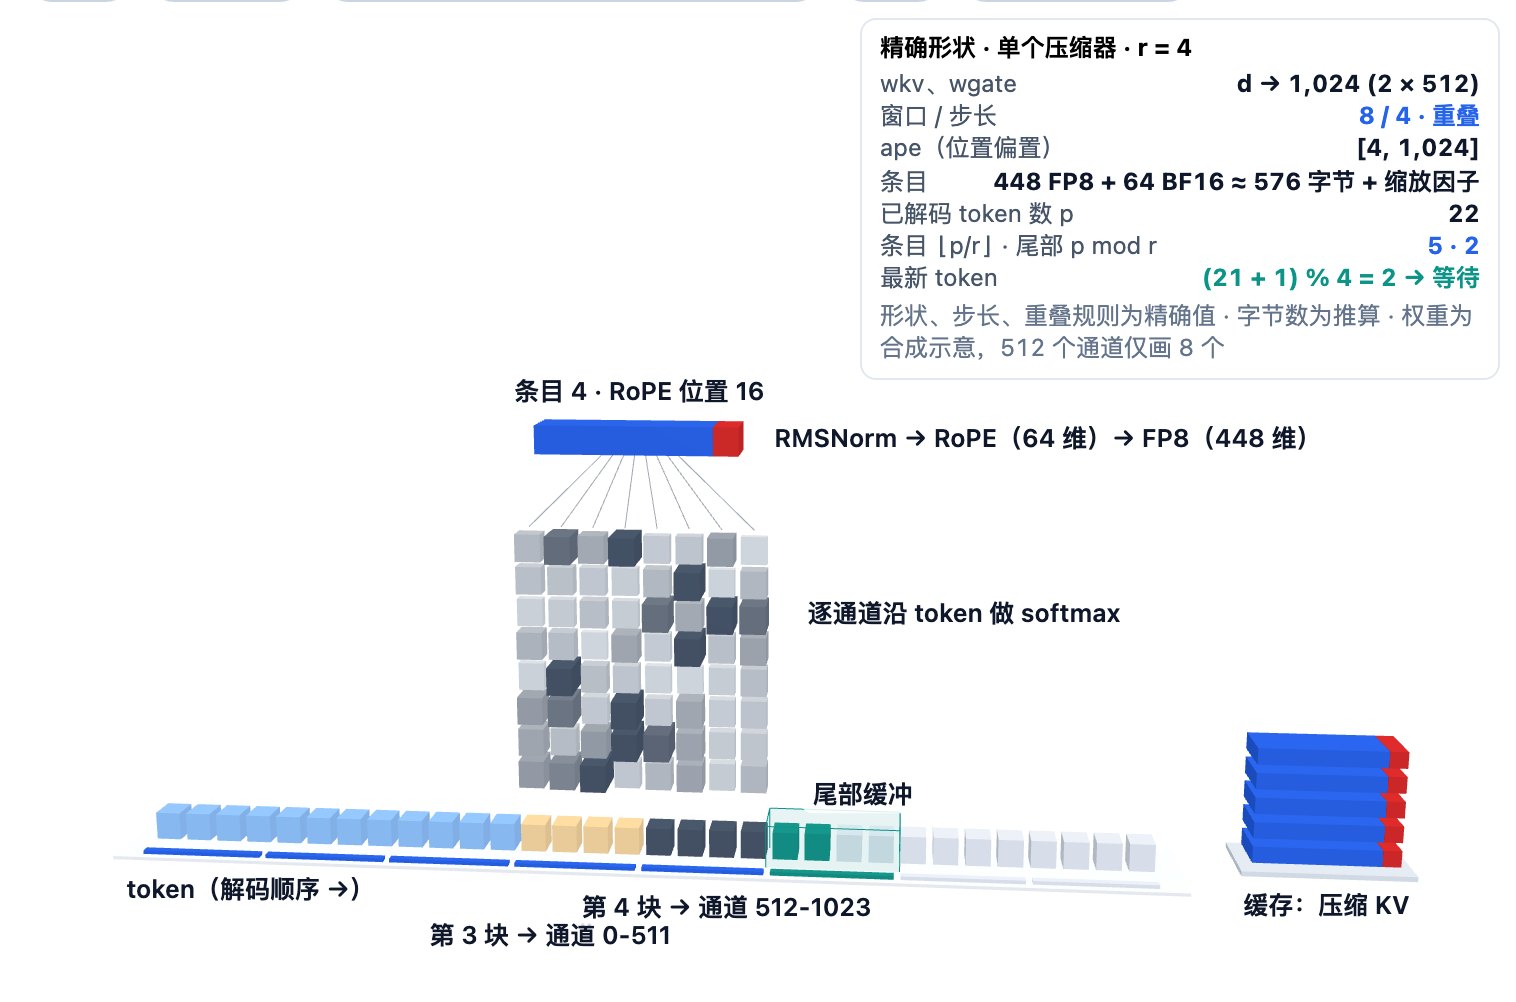
V4 的每个压缩层都需要一份更短的记忆:每几个 token 只存一条,而不是每个 token 存一条。这份记忆由压缩器生成。它本质上是加权平均,但权重由模型自己学:512 个通道各自决定块内哪个 token 更重要。CSA 层把每 4 个 token 压成一条,HCA 层把每 128 个压成一条。
4.1 思路:还是求平均,但每个通道自己挑权重
均值池化(mean pooling)让块内每个 token 的话语权完全一样。V4 的压缩器把每个 token 投影两次:一次得到值 $v$(这个 token 贡献什么),一次得到门控分数 $s$(它的话该占多大分量)。两者对 512 通道条目的每个通道各有一个数,所以每个通道都有自己的分数(压缩比为 4 时投影宽度翻倍,见 §4.2)。在块内的 token 之间做 softmax,分数就变成权重,每个通道一套;条目就是值的加权和。
设块长为 $r$(压缩比,4 或 128),第 $i$ 条、第 $c$ 个通道(这里写的是不重叠的情形,压缩比 4 的重叠见 §4.2):
\[s_j = W_{\text{gate}}\, x_j + B_{\,j \bmod r}, \qquad v_j = W_{\text{kv}}\, x_j, \qquad C_{i,c} = \sum_{j \in \text{block } i} \frac{\exp(s_{j,c})}{\sum_{j' \in \text{block } i} \exp(s_{j',c})}\; v_{j,c}\]$x_j$ 是第 $j$ 个 token 进入注意力层的输入(归一化后的隐藏状态,Pro 为 7,168 维,Flash 为 4,096 维)。$B$ 是一张很小的可学习表,块内每个位置一行,比如可以让门控偏爱每块的最后一个 token。论文用式 20–23(HCA)和式 9–12(CSA,含 §4.2 讲的重叠)写的是同一件事。
举个玩具例子:一个 4 token 的块,两个通道(数字是编的):
| token 0 | token 1 | token 2 | token 3 | 条目 | |
|---|---|---|---|---|---|
| 通道 A:值 $v$ | 2 | 4 | 6 | 8 | |
| 通道 A:分数 $s$ | 0 | 0 | 0 | $\ln 5$ | |
| 通道 A:权重 | 0.125 | 0.125 | 0.125 | 0.625 | 6.5 |
| 通道 B:值 $v$ | 2 | 4 | 6 | 8 | |
| 通道 B:分数 $s$ | 1 | 1 | 1 | 1 | |
| 通道 B:权重 | 0.25 | 0.25 | 0.25 | 0.25 | 5.0 |
通道 B 的分数全相等,结果就是普通平均值 5.0。通道 A 把大部分权重给了 token 3,结果是 6.5。均值池化只是压缩器能学到的一个特例,每个通道都可以偏离它。我们的理解:这是一种注意力池化,每个通道有一个可学习的打分器。官方参考代码的 docstring 称之为 “learned gated pooling”(可学习的门控池化)。
压缩器本身很小:两个投影($W_{\text{kv}}$、$W_{\text{gate}}$)、位置偏置表 $B$,再加一个作用在 512 维输出上的 RMSNorm:
| 压缩器(按配置推算) | Pro,压缩比 4(CSA) | Pro,压缩比 128(HCA) | Flash,压缩比 4 | Flash,压缩比 128 |
|---|---|---|---|---|
| 投影宽度($W_{\text{kv}}$、$W_{\text{gate}}$ 各一个) | 7,168 → 1,024 | 7,168 → 512 | 4,096 → 1,024 | 4,096 → 512 |
| 位置偏置 $B$ | 4 × 1,024 | 128 × 512 | 4 × 1,024 | 128 × 512 |
| 参数量(按配置推算) | 约 14.7M | 约 7.41M | 约 8.39M | 约 4.26M |
压缩比 4 的投影宽一倍(1,024),原因是下一节要讲的重叠。作为对照,Pro 的一个路由专家约有 66.1M 参数(按配置推算,见 §8)。
数字从哪来
- 官方
inference/model.py(Pro 与 Flash 仓库里是同一份)中的Compressor类。docstring 写道:“Compresses KV cache via learned gated pooling overcompress_ratioconsecutive tokens.”wkv和wgate都是Linear(dim, coff * head_dim);ape是形状为[compress_ratio, coff * head_dim]的参数(即位置偏置 $B$,“ape” 应是 absolute position embedding 的缩写,V4.1-Flash 报告称之为 “absolute positional embedding”);norm是RMSNorm(head_dim)。压缩比为 4 时coff为 2,否则为 1;head_dim为 512。 - 加权和那一行就是
(kv * score.softmax(dim=2)).sum(dim=2):softmax 沿 token 轴做,每个通道各自独立。上面的公式是我们对这行代码的转写。 - 两份配置的
hidden_size分别为 7,168(Pro)和 4,096(Flash),head_dim都是 512;压缩比 4 和 128 见compress_ratios和论文的模型设置。 - 参数量是我们算的:Pro CSA $2 \times 7{,}168 \times 1{,}024 + 4 \times 1{,}024 + 512 = 14{,}684{,}672$;Pro HCA $2 \times 7{,}168 \times 512 + 128 \times 512 + 512 = 7{,}406{,}080$;Flash CSA 8,393,216;Flash HCA 4,260,352。CSA 层的索引器里还有第二个更窄的压缩器(§5.2),未计入。
- 精度:checkpoint 中
wkv/wgate以 BF16 存储,参考代码把它们和输入一起升到 FP32 计算(注释为 “compression need fp32”)。压缩器权重没有做 FP8 量化。
4.2 压缩比 4(CSA)有重叠,压缩比 128(HCA)没有
4 个 token 的块很小。一种理解方式(这是我们对代码里 “smoother compression boundaries” 的理解):如果每个 token 只属于一条,块边界把一个短语切开,它就会落进两条互不相干的摘要里。CSA 的压缩器让每一条也读上一块,相邻两条共享 4 个 token。HCA 的 128 token 大块不做重叠。
下面是 Pro 的 CSA 层里压缩比 4 的完整流程,序列长 $n$,形状都是真实的:
- 投影两次,宽 1,024。 $v = W_{\text{kv}} x$ 和 $s = W_{\text{gate}} x$ 的形状都是 $[n, 1{,}024]$。按每个 token 在块内的位置,把位置偏置 $B$($[4, 1{,}024]$)加到分数上。
- 切成 4 个一块: $[n/4,\ 4,\ 1{,}024]$。
- 为每一条拼出 8 个槽位,宽 512。 槽位 0–3 放上一块的 4 个 token,取它们投影的第 0–511 通道;槽位 4–7 放当前块的 4 个 token,取第 512–1,023 通道。结果为 $[n/4,\ 8,\ 512]$。
- 在 8 个槽位上做 softmax,512 个通道各做各的,再求加权和:$[n/4,\ 512]$。
于是第 $i$ 条汇聚 token $4i-4$ 到 $4i+3$,相邻两条的起点相差 4 个 token。每个 token 都会进入两条:作为“上一块”走投影的前半,作为“当前块”走后半。两半的权重相互独立,所以同一个 token 可以对两条说不同的话。第 0 条没有上一块,前 4 个槽位的值填 0、分数填 $-\infty$,权重即为 0。
论文的写法是两个序列:$C^a$ 对应当前块,$C^b$ 对应上一块,二者一起归一化,“across the total of $2m$ elements”(式 9–12)。Flash 的各项宽度完全相同,只有输入一侧是 4,096。

压缩比 128 是朴素版本。 投影宽 512,只有一个序列,每条只汇聚自己块里的 128 个 token:token $128i$ 到 $128i+127$,步长 128。论文明确说 HCA “does not perform overlapped compression”(不做重叠压缩)。参考代码的 docstring 给出了压缩比 4 做重叠的理由(“for smoother compression boundaries”,让压缩边界更平滑);但两份来源都没说 HCA 为什么不做。我们的猜测(属于解读):每条覆盖 128 个 token 时,边界切分的相对影响更小,而投影宽度翻倍会让压缩器的开销也翻倍。
池化之后,两种压缩比对 512 维条目做同样的三步:
- RMSNorm,作用在 512 个通道上,带可学习权重。
- 对最后 64 维做 RoPE,位置取该条所属块的第一个 token:0、$r$、$2r$……。压缩比 4 的重叠条目虽然往回读到 token $4i-4$,旋转位置仍是 $4i$。
- 其余 448 维做 FP8 舍入(参考代码里是模拟量化,与量化感知训练对齐);64 个 RoPE 维保持 BF16。这和窗口里原始 KV 的 448 + 64 划分一致(§3.1)。
块凑齐了,条目才会出现。 解码时,压缩比为 $r$ 的压缩器在 token 位置 $p$ 满足 $(p+1) \bmod r = 0$ 时产出一条新条目。位置 $t$ 的 query 只有在 $\lfloor (t+1)/r \rfloor > i$ 时才能用第 $i$ 条。未凑满的块绝不提前压缩,由 128 token 的窗口兜底。对压缩比 128 来说刚好够用:最多 127 个 token 在等待,而窗口能装 128 个(由索引规则推算)。
举例来说,一个 10 token 的 prompt(位置 0–9):
- CSA 层(压缩比 4)。 第 0 条汇聚 token 0–3(位置 0)。第 1 条汇聚 token 0–7(0–3 作为“上一块”,4–7 作为“当前块”;位置 4)。token 8、9 在等待。位置 9 的 query 能看到第 0、1 条,外加窗口里的原始 token 0–9。
- HCA 层(压缩比 128)。 还没有任何条目;10 个 token 全在等待,只靠窗口覆盖。token 127 到来时才会产出第 0 条。
因此,最近的 token 可能出现两次:一次以原始形式在窗口里,一次汇聚在某个已完成的条目里(HCA 读取所有条目,所以必然如此;CSA 只有在索引器选中该条时才会)。两类 key 进入同一个 softmax(§3.4)。
下面的 3D 模型可以在两种压缩比之间切换、高亮重叠部分,并逐个 token 步进。
实现细节
overlap = compress_ratio == 4,coff = 1 + overlap。代码注释:“When overlap, the first half of dims is for overlapping compression, second half for normal.”(重叠时前半通道用于重叠压缩,后半用于常规压缩。)overlap_transform拼出[b, s/r, 2r, d]的窗口:new[:, :, r:] = x[:, :, :, d:](当前块,后半)、new[:, 1:, :r] = x[:, :-1, :, :d](上一块,前半);kv的填充值为 0,score为-inf。- 位置偏置在重叠变换之前加上,所以槽位 0–3 带的是
ape[:, :512],槽位 4–7 带的是ape[:, 512:],正好对应论文的两个偏置 $B^b$(上一块)和 $B^a$(当前块)。论文的 $W^{aKV}$、$W^{bKV}$ 就是代码里单个wkv的两半;$W^{aZ}$、$W^{bZ}$ 与wgate同理。 - RoPE 位置:预填充用
freqs_cis[:cutoff:ratio](位置 $0, r, 2r, \dots$);解码用freqs_cis[start_pos + 1 - ratio],即刚凑满的那一块的第一个位置。压缩层使用compress_rope_theta160,000 并启用 YaRN(§9)。 - FP8:
act_quant(kv[..., :-64], 64, ...)对 448 个 NoPE 维按 64 一块原地舍入,缩放因子为 UE8M0(2 的幂)格式。索引器自己的压缩器(rotate=True,头维度 128)则先做 Hadamard 旋转,再对整个向量做 FP4 舍入(§5.2)。 - 可见性:HCA 列出压缩条目 $0 \dots \lfloor (t+1)/128 \rfloor - 1$(
get_compress_topk_idxs);CSA 的索引器屏蔽编号 $\ge \lfloor (t+1)/4 \rfloor$ 的条目。论文给出同样的规则,并把它的后果(“a query cannot access information from other tokens within its own compressed block”,query 看不到自己所在压缩块里的其他 token)列为加窗口的理由之一。 - 开源训练实现 Miles 采用相同的重叠规则和步长为 $r$ 的 RoPE 位置。它的压缩器矩阵乘是 BF16 × BF16、FP32 输出,为的是和 SGLang 的 rollout kernel 对齐;参考推理代码则先升到 FP32 再算(§13)。
4.3 缓存里存什么
压缩器把一堆不断增长的逐 token key,变成一张短得多的条目表。一层在解码步之间要保留什么,取决于它的类型:
| 每条序列保留 | CSA 层(压缩比 4) | HCA 层(压缩比 128) | 纯窗口层(Flash 第 0–1 层、MTP 层) |
|---|---|---|---|
| 压缩后的主 KV | $\lfloor n/4 \rfloor$ 条 × 512 维 | $\lfloor n/128 \rfloor$ 条 × 512 维 | 无 |
| 压缩后的索引器 key | $\lfloor n/4 \rfloor$ × 128 维,FP4(§5.2) | 无 | 无 |
| 原始窗口 | 最近 128 个 token × 512 维 | 最近 128 个 token × 512 维 | 最近 128 个 token × 512 维 |
| 未压缩的尾部 | 不到 4 个 token(另含上一块,供重叠使用) | 不到 128 个 token | 无 |
只有压缩条目会随上下文增长,每 4 个或 128 个 token 一条。按论文的混合存储格式,每条主 KV 占 576 字节(448 FP8 + 64 BF16,按我们的计数;§3.1)。窗口和尾部大小固定,所以论文把它们放进按请求分配、大小固定的“状态缓存”(state cache),当作状态空间模型的状态来管理。
举例来说,Pro 读完一个 1,000 token 的 prompt 之后:
- CSA 层保存 250 条主 KV、250 个索引器 key、128 token 的窗口;没有待压缩的 token(1,000 是 4 的倍数),但状态里仍保留 token 996–999 这一块,供下一条重叠使用;
- HCA 层保存 7 条(覆盖 token 0–895)、窗口,以及 104 个 token 的尾部(896–999),要等到 token 1,023 才能凑满。
§9 会把这笔账放大到百万 token,并与 DeepSeek-V3.2 对比。
实现细节
- 参考代码的解码状态:每个压缩器维护
kv_state和score_state两个 FP32 缓冲区,形状为[batch, coff·r, coff·512](分数初始化为 $-\infty$)。压缩比 4 时是 8 个槽位 × 1,024:上一块的 4 个投影后 token(重叠要用)加当前块的 4 个。一块凑满时,代码把槽位 0–3 的前半通道和槽位 4–7 的后半通道拼起来,在 8 个槽位上做 softmax,写入第pos // ratio条,再把当前块挪到“上一块”的槽位。压缩比 128 时是 128 个槽位 × 512,不需要挪动。 - 所以参考代码的尾部存的是投影后的值和门控分数,不是原始隐藏状态;论文的描述是 “all pending tokens and their associated hidden states”(所有待压缩的 token 及其隐藏状态)。无论哪种,上限都是一块。
- 参考代码对缓存的 KV 做的是 FP8 模拟(注释:“kv could also use fp8 format, though current implementation uses bf16”);576 字节这个数按论文部署时的混合格式计算,且未计 FP8 缩放因子的字节。
- 论文如何按块组织这份缓存(图 6),以及如何做磁盘前缀缓存,见 §9.4。
- 训练必须与此一致。Miles 在每个打包片段里,把末尾
seqlen % ratio个 token 排除在压缩之外;docstring 说这样 “matches inference, where a decode token sitting in an incomplete buffer has no compressed entry either”(与推理一致:解码时停在未满缓冲区里的 token 也没有压缩条目)。论文的上下文并行方案同样丢弃每条打包序列末尾不足一个压缩比(m 个)的 token。 - 后来的 V4.1-Flash 简化了这个压缩器,去掉了重叠和位置偏置(§12.4)。
5. CSA:压缩稀疏注意力
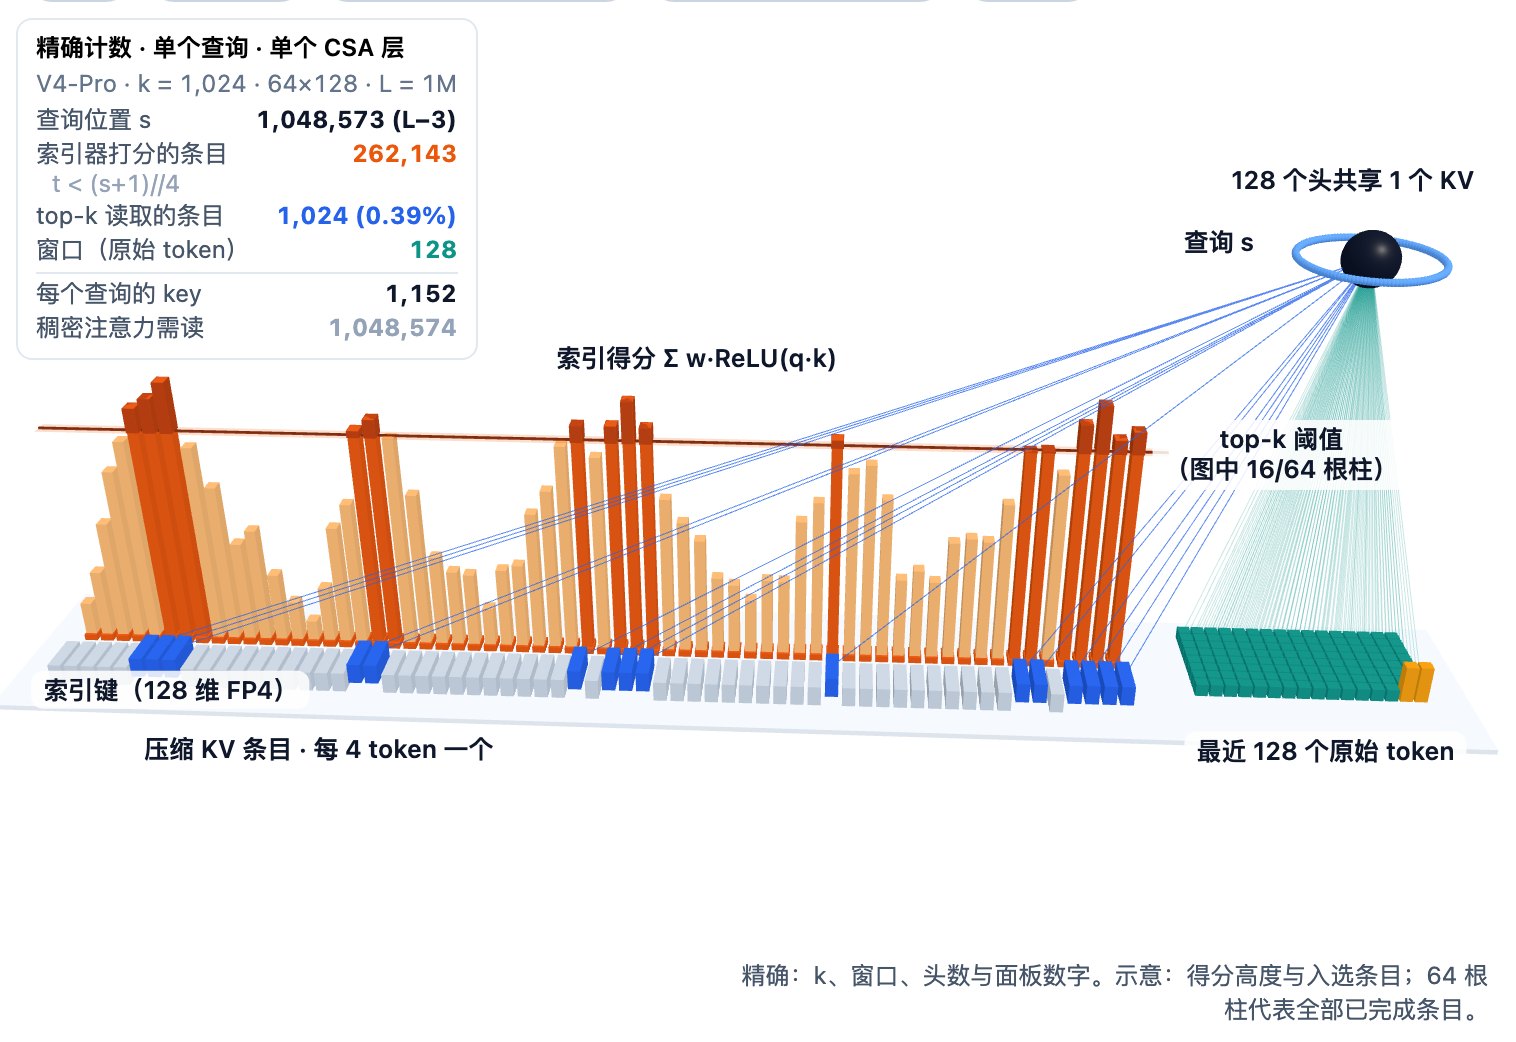
一层注意力,怎样在一百万个 token 里找到任意位置的细节,同时只读大约一千个键?CSA 先用 §4 的压缩器把记忆缩小到 1/4,再让一个便宜的打分器,也就是闪电索引器(lightning indexer),挑出值得读的少数压缩条目,最近的若干 token 则无条件加进来。
5.1 思路:把 DSA 搬到压缩块上
DeepSeek-V3.2 提出了 DSA:一个小小的闪电索引器给之前的每个 token 打分,真正的注意力只读得分最高的 2,048 个。DSA 和索引器的细节,GLM-5.3 那篇文章的 §5.1–5.2 已经讲过。V4 报告对 CSA 的描述正是在压缩之后套用这套做法:CSA “先把每 $m$ 个 token 的 KV cache 压成一个条目,再施加 DeepSeek 稀疏注意力”,其中 $m = 4$。
对一个查询 token,CSA 层走四步:
- 主记忆。 压缩器(§4)已经用相互重叠的 8 token 窗口,把每 4 个 token 压成一个 512 维条目。
- 索引记忆。 另一个更小的压缩器,把同样的 4 token 块各压成一个 128 维的索引键。
- 选择。 索引器给每个已完成的块打分,保留前 $k$ 个:Pro 是 1,024,Flash 是 512。
- 注意力。 选中的条目加上最近 128 个 token 的原始键,一起进入 softmax:每个头在同一份列表上做一次带 sink 的 softmax(§3.4)。
放到完整的 1M 上下文、查询位于末尾时,数字如下:
| 每个查询、每个 CSA 层 | V4-Pro | V4-Flash |
|---|---|---|
| 记忆中的压缩条目($n/4$) | 262,144 | 262,144 |
选中条目数(index_topk) |
1,024 | 512 |
| 窗口原始键 | 128 | 128 |
| softmax 中的键,最多 | 1,152 | 640 |
| 读到的压缩条目占比 | 0.39% | 0.20% |
第 1、4、5 行按配置推算。
说白了:索引器仍要扫一遍整个压缩记忆;但贵的那部分,即 128 个(Pro)或 64 个(Flash)头用 512 维键做注意力,最多只碰 1,152 或 640 个键。这个数在 64K 和 1M 时一样。随长度增长的是索引器对 $n/4$ 个小键的扫描。和给每个 token 打分相比,CSA 把这次扫描缩短到 1/4;§5.2 还会讲到它怎样让扫描的每一步也更便宜。
数字从哪来
- $m = 4$、索引器 64 头 × 128 维、top-k 1,024(Pro)/ 512(Flash)、窗口 128:报告 §4.2.1 与配置(
compress_ratios、index_n_heads、index_head_dim、index_topk、sliding_window)。配置与报告一致。 - 1,048,576 / 4 = 262,144 个条目;128 + 1,024 = 1,152、128 + 512 = 640 个键;1,024 / 262,144 ≈ 0.39%,512 / 262,144 ≈ 0.20%。均为我们的计算。
- V3.2 的 top-2,048 来自 V3.2 配置,GLM-5.3 那篇文章有讨论。V4 报告只说 V4 选用了比 V3.2“更小的注意力 top-k”,这对“短、中等长度文本”的效率有帮助。
5.2 与 V3.2 索引器的不同
打分公式还是 DSA 那一套。变的是给什么打分,以及打分有多便宜。下表把两者并排列出;V3.2 一栏依据 GLM-5.3 那篇文章 §5 对 V3.2 设计的介绍。
| DeepSeek-V3.2(DSA) | DeepSeek-V4(CSA) | |
|---|---|---|
| 每个索引键对应 | 1 个 token | 1 个 4 token 块(重叠的 8 token 窗口) |
| 索引键从哪来 | 每个 token 的一次投影 | 索引器自己的压缩器(压缩比 4,128 维) |
| 选完之后注意力读什么 | 选中 token 的缓存条目 | 选中的压缩条目(512 维,键即值) |
| Top-k | 2,048 个 token | 1,024 个条目(Pro),512 个(Flash) |
| 每个查询另外还读 | 无:没有窗口,查询自身也不强制入选(见 GLM-5.3 那篇 §5.3) | 最近 128 个 token 的原始键(窗口) |
下面跟着一个查询走一遍 V4-Pro 的索引器。形状取自配置和参考代码,方括号内是 Flash。
- 索引键:每个块写一次。 索引器有自己的压缩器,和 §4 一样是可学习的池化,压缩比 4、带重叠,只是宽度为 128。每个 token 的隐状态(7,168 [4,096] 维)投影成 2 × 128 个值和 2 × 128 个门控分数。每个完成的 4 token 块产出一个 128 维键:先做 RMSNorm,最后 64 维加 RoPE,再做 Hadamard 旋转(对 128 个维度做一次固定的正交混合,见下文),最后舍入到 FP4。缓存里存 $n/4$ 个这样的键。
- 索引查询:复用注意力的潜向量。 主注意力已经把 token 压成 1,536 [1,024] 维的查询潜向量(§3.2)。索引器用自己的
wq_b把同一个潜向量投影成 64 头 × 128 = 8,192 个数,每个头的最后 64 维加 RoPE,再旋转、舍入到 FP4。论文明确写了这种共享:这个潜向量“与索引器查询所用的相同”。 - 头权重。 一个小投影
weights_proj把隐状态映射成 64 个标量,每个索引头一个,再乘以 $128^{-1/2}\cdot 64^{-1/2}$。 - 给每个可见块打分。 对查询位置 $s$ 和块 $t$,用下面的公式。
- 留下最好的。 选择器保留 $\min(k,\ \text{可见块数})$ 个条目。
说白了:这就是 V3.2 的打分器,只是换了一本短到 1/4 的目录。目录里每张卡片代表一个 4 token 块,V4 用 4 位浮点存卡片、算卡片。可见性规则意味着:一个块要等最后一个 token 到齐,才能被选中。查询自己所在、尚未写完的块,交给窗口处理(§5.3)。
有两个细节容易漏掉。第一,Hadamard 旋转同时作用在查询和键上,而正交旋转不改变任何点积;在精确算术下,它对分数毫无影响。代码的 docstring 写明了用途:在 FP8 量化前把信息“摊到各个维度”(索引器这一路实际舍入到 FP4)。换句话说,它把个别很大的离群通道摊到全部 128 维上,让舍入的损失小一些。论文没有讨论。
第二,这套精度技巧是后训练阶段加的。报告的 FP4 量化感知训练(QAT)让索引器的 QK 激活“全程以 FP4”缓存、读取和相乘,并把索引分数从 FP32 量化到 BF16。报告称这让 top-k 选择器“提速 2 倍,同时保持 99.7% 的 KV 条目召回率”。
GLM-5.3-Flash 的“kpool”索引器(那篇 §8.5)同样按 4 个一组池化键。区别在选完之后:GLM 把选中的块展开回 4 个原始 token;V4 直接对压缩条目本身做注意力,不会去取选中块的原始 token;原始 token 只经由窗口进入。
实现细节
- 代码位置。 参考实现
inference/model.py里的class Indexer只在压缩比为 4 的层构建;压缩比 128 的层indexer = None。它由三部分组成:wq_b(Pro 为 1,536 → 8,192,Flash 为 1,024 → 8,192)、weights_proj(隐状态 → 64,BF16),以及Compressor(ratio 4, head_dim 128, rotate=True),后者有自己的缓存,形状为[batch, max_seq_len / 4, 128]。 - 缩放。
weights = weights_proj(x) * (128 ** -0.5 * 64 ** -0.5),两个因子分别对应索引头维度和头数。点积过 ReLU 后乘以这些权重,再在头之间求和。 - 代码里的 FP4。 查询和压缩键都在 Hadamard 旋转(
rotate_activation)之后经过fp4_act_quant,块大小 32。代码注释提到存下的键“也可以用 fp8 格式,不过当前实现用的是 bf16”。参考代码是在模拟 QAT 的舍入,并没有真的存成打包的 FP4。 - 参数量(按配置推算)。 每个 CSA 层的索引器在 Pro 中约 16.7M 参数(压缩器 3.7M、
wq_b12.6M、weights_proj0.46M),Flash 中约 10.8M。加上 512 维的主压缩器,一个 CSA 层约有 31.4M(Pro)/ 19.1M(Flash)参数是 HCA 层没有的,或在 HCA 中规模更小(HCA 压缩比 128 的压缩器:7.4M / 4.3M)。 - 下标约定。 报告把可见性写成 $s < \lfloor t/m \rfloor$,其中 $t$ 是查询。代码用从 0 开始的位置,写作
block < (pos + 1) // 4,于是一个块在它自己的最后一个 token(包括查询本身)到达时就可见。我们的理解是两者含义相同,只是下标起点不同。 - 训练代码不一致。 Miles 对索引器压缩器的输出做的是 FP8 QAT(块大小 128),参考推理代码用的是 FP4(块大小 32)。这是开源训练栈里一个真实存在的训练/推理精度差异(§13)。
5.3 选择结果与窗口进同一个 softmax
索引器返回的是压缩记忆里的位置,而注意力 kernel 只接收一份指向同一块缓冲区的行号列表。所以参考代码把原始 token 的键放在缓冲区前面,压缩条目接在后面,再给每个选中的条目编号加上一个偏移量:
- 预填充(一次处理整段提示):缓冲区 = [提示的全部 $L$ 个原始键 ; 它的 $\lfloor L/4 \rfloor$ 个压缩条目],偏移量 = $L$。
- 解码(一次一个 token):缓冲区 = [128 个槽位的近期键环形缓冲 ; 压缩条目],偏移量 = 128。
一个查询最终的下标列表,是 128 个窗口位置,后面跟着 $k$ 个加过偏移的条目编号。sparse_attn 按这些行号取数,在全部键上跑一次在线 softmax(一遍流式算完),外加每个头的 sink(§3.4)。没有第二个 softmax,也没有在“局部”和“压缩”之间加权的门控。
一个小例子。 全部缩小:压缩比 4、窗口 8、$k = 3$,查询在位置 21。
- 可见块:$\lfloor 22/4 \rfloor = 5$,即块 0–4(token 0–19)。token 20–21 在块 5 里,这个块还没写完。
- 块 0–4 的索引分数(随手编的):0.1、0.9、0.0、0.4、0.7。前 3 名是块 1、4、3。
- 窗口:token 14–21,包括查询本身。
- 下标列表:8 个原始键 + 3 个压缩条目 = 11 个键,一个 softmax。
块 4 覆盖 token 16–19(再通过重叠通道覆盖 12–15),而这些 token 也在窗口里。模型会看到它们两次:一次原样,一次池化后。代码不会去掉这种重复。
换成真实尺寸,同样的算术就得到 §5.1 的数字。以位置 9,999 的 V4-Pro 查询为例:可见块 2,500 个,索引器留下 1,024 个,窗口再加上 token 9,872–9,999,共 1,152 个键。Flash 从 2,500 个里留 512 个,共 640 个键。
只有可见块多于 $k$ 时,稀疏才真正开始。Pro 在位置 4,099(1,025 个可见块)、Flash 在位置 2,051(513 个)跨过这条线。在此之前,top-k 会保留所有块,CSA 层实际上是对压缩记忆做稠密注意力。这两个阈值由代码里的 $\min(k, \cdot)$ 推算而来。
索引器怎么训练。 报告给了时间表,没给损失函数。Flash 先“在前 1T token 用稠密注意力预热”,Pro“的稠密注意力阶段更长”。序列长度到 64K 那一阶段才引入稀疏注意力:先用“一个短阶段预热 CSA 的闪电索引器”,然后在剩下的大部分训练中保持稀疏。
报告没说这里的“稠密”是指读全部压缩条目还是别的含义,也没写索引器的训练目标。V3.2 训练索引器去拟合稠密注意力的分布(见 GLM-5.3 那篇 §5.4);V4 是否照做,现有资料没有交代。
实现细节
- 下标布局。 在
Attention.forward里:offset = kv.size(1) if start_pos == 0 else win。索引器返回的编号加上offset,窗口编号排在前面:torch.cat([window_idxs, compress_idxs])。解码缓存分配window_size + max_seq_len // ratio行。 - 掩码。 预填充时,尚未完成的块,其条目记为
-1,kernel 把-1当作 $-\infty$ 屏蔽。前 127 个位置的窗口列表也用同样方式补齐。 - Miles 构造同样的列表:先窗口编号,再加上
kv_compress_offset偏移的压缩编号。对打包序列(THD),它还把每个查询的 top-k 限制在自己所在的片段内。Miles 最近有一个提交,让 CSA 索引器在上下文并行的各个 rank 之间负载均衡(§13)。 - 报告图 3 画的是同一条流水线:token 级压缩器 → 压缩 KV;另一个压缩器 → 压缩索引键;闪电索引器 → top-k 选择器;再与滑动窗口 KV 拼接,送入共享 KV 的 MQA。
6. HCA:重度压缩注意力
CSA 保留细节,代价是多一道选择。HCA 反过来:压得足够狠,读全部也变得便宜,于是干脆不要索引器。每 128 个 token 压成一个条目,每个查询读全部条目,再加上最近的窗口。
6.1 思路:压到稠密注意力也便宜
报告对 HCA 的描述是:以“更重的方式”压缩 KV cache,“但不使用稀疏注意力”。一个压缩比 128 的层,按步骤看:
- 压缩。 运行 §4 的压缩器,压缩比 128,不重叠。投影只有一路,宽 512;块内 128 个槽位各有一个可学习的位置偏置。每个完成的 128 token 块变成一个 512 维条目,RoPE 用块内第一个 token 的位置。
- 跳过选择。 没有索引器,没有索引键,也没有 top-k。下标列表就是全部已完成的条目。
- 注意力。 和 CSA 一样,列表是 128 个窗口位置加上这些条目,在上面跑一个带每头 sink 的 softmax。核心同样是共享 KV 的 MQA 加分组输出投影(§3),报告对此有明确说明。
于是每个查询的键数会随上下文增长,但长得很慢。下表是单层每个查询的键数,并列出 CSA 作对比:
| 上下文 | HCA:$128 + \lfloor n/128 \rfloor$ | CSA,Pro | CSA,Flash |
|---|---|---|---|
| 8K | 64 + 128 = 192 | 1,152 | 640 |
| 64K | 512 + 128 = 640 | 1,152 | 640 |
| 128K | 1,024 + 128 = 1,152 | 1,152 | 640 |
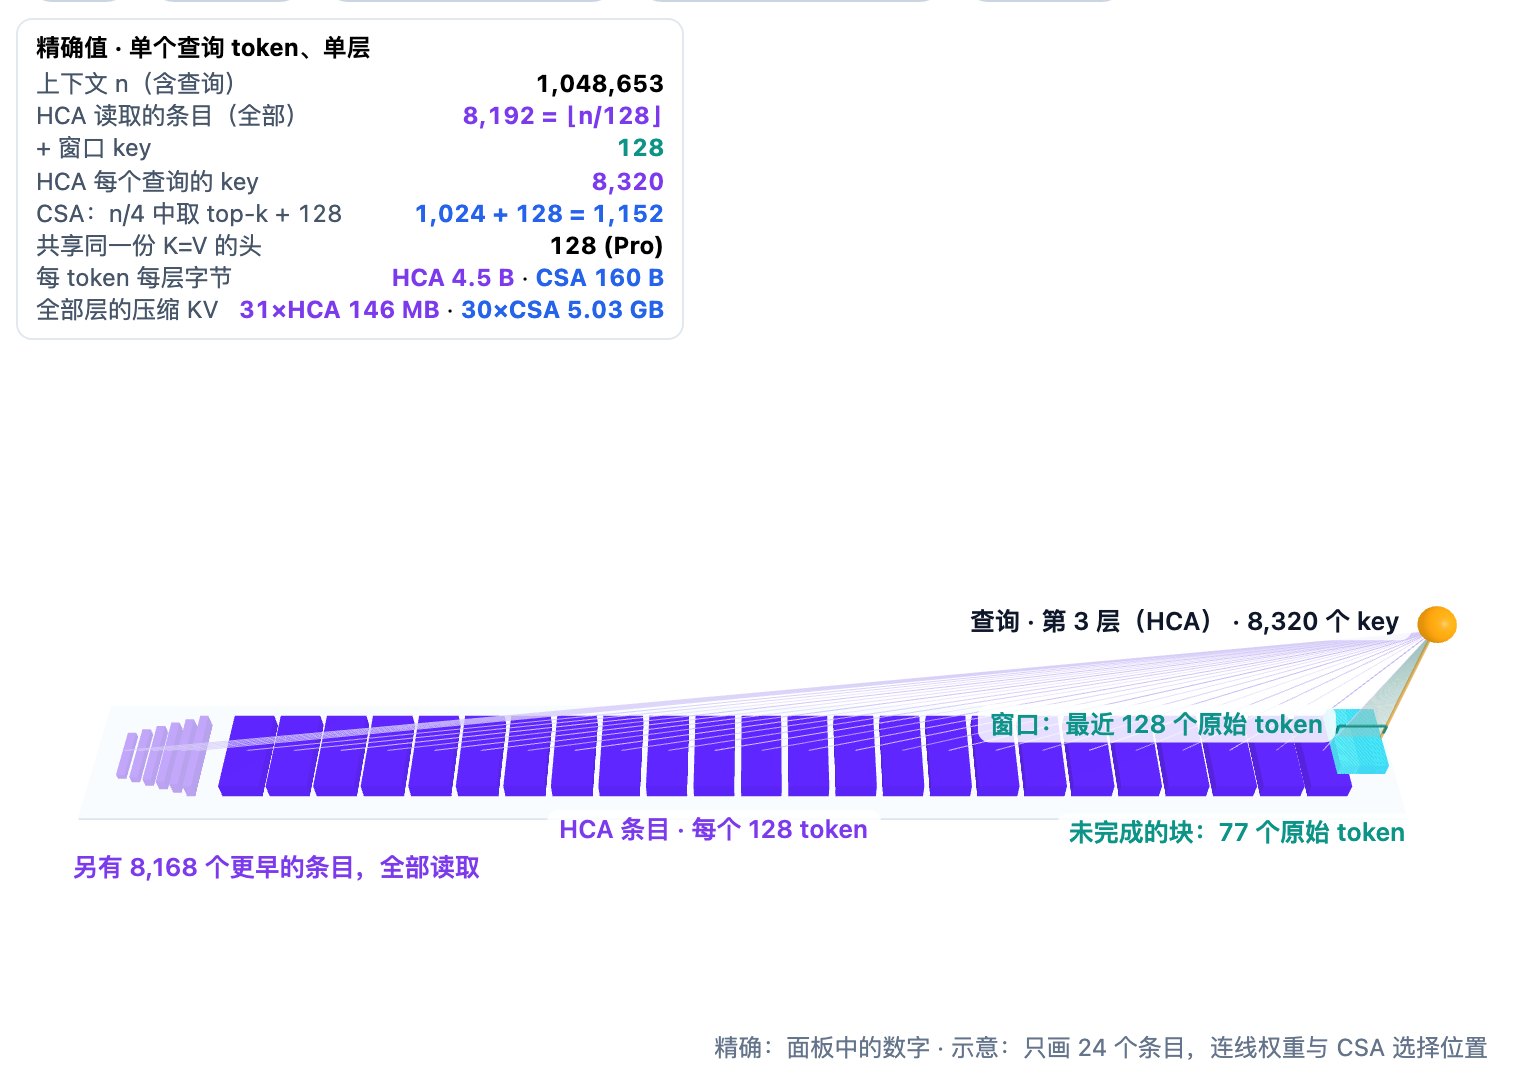
| 1M | 8,192 + 128 = 8,320 | 1,152 | 640 |
所有数字均按配置和代码推算,查询位于上下文末尾。
说白了:到 128K 为止,HCA 层读的键不比 Pro 的 CSA 层多,而且完全不用扫索引。到 1M 时它要读 8,320 个键,约为 CSA 1,152 个的 7.2 倍。换来的是:每个键概括 128 个 token,上下文一处也没有跳过。
它的缓存极小。一个条目占 576 字节(448 维 FP8 + 64 维 BF16,§3.1),对应 128 个 token,即每层每 token 4.5 字节(按论文的存储精度推算)。CSA 层算上 FP4 索引键,每 token 要 (576 + 64) / 4 = 160 字节(推算)。在 1M token 时,一个 HCA 层的压缩条目约 4.7 MB,一个 CSA 层约 168 MB(推算)。
一个小例子。 设 HCA 层里的查询在位置 1,000。
- 已完成的块:$\lfloor 1{,}001/128 \rfloor = 7$,即条目 0–6,合起来覆盖 token 0–895;条目 6 的 RoPE 位置是 768。
- token 896–1,000(共 105 个,含查询本身)在块 7 里,这个块还没写完。
- 窗口覆盖 token 873–1,000,所以这 105 个未完成的 token 都以原始键的形式出现。token 873–895 出现两次:一次原样,一次在条目 6 里。
- 合计 7 + 128 = 135 个键,一个 softmax。
这就是窗口不可或缺的原因。查询永远看不到自己所在、尚未写完的块的压缩形式。压缩比 128 时,这段空缺有 0 到 127 个 token;128 token 的窗口(含查询本身)在任何情况下都恰好够把它盖住。
数字从哪来
- 代码。 HCA 层构建压缩比 128 的
Compressor(overlap = False,所以coff = 1;Pro 中wkv/wgate为 7,168 → 512,ape形状[128, 512]),并设indexer = None。压缩部分的下标列表来自get_compress_topk_idxs,它返回所有小于(pos + 1) // 128的条目编号(加上与 §5.3 相同的偏移)。 - 报告。 式 20–23 定义了 HCA 的单路压缩:在每个 $m’$ token 块上做 softmax,外加可学习的位置偏置 $B \in \mathbb{R}^{m’ \times c}$。§4.2.1 为两个模型都设 $m’ = 128$。
- 参数量(按配置推算)。 HCA 压缩器每层约 7.4M 参数(Pro)/ 4.3M(Flash);CSA 的两个压缩器加索引器约为 31.4M / 19.1M。
- 字节数(按论文的存储精度推算)。 576 / 128 = 4.5 B;(576 + 64) / 4 = 160 B,其中 64 B 是一个 128 维 FP4 索引键,忽略了很小的缩放因子。在 1,048,576 个 token 时,每层 8,192 × 576 B ≈ 4.7 MB,262,144 × 640 B ≈ 168 MB。全模型总量见 §9。
6.2 为什么让 CSA 和 HCA 交替
两种层回答的是关于过去的不同问题:
| CSA | HCA | |
|---|---|---|
| 一个条目的分辨率 | 4 个 token(含重叠为 8 个) | 128 个 token |
| 读多少过去 | 前 1,024 个(Pro)/ 512 个(Flash)条目 | 全部已完成条目 |
| 谁来决定 | 闪电索引器 | 无需决定,全读 |
| 最近的 token | 128 token 原始窗口 | 128 token 原始窗口 |
| 每层每 token 缓存(推算) | 160 B | 4.5 B |
一个精细但有取舍,一个粗糙但完整。拿读一本厚书打比方:CSA 层挑出一千段仔细重读,HCA 层把每一页的一句话摘要都扫一遍。两者都盯着最后一页。
V4 让两者交替。从第 2 层起,偶数层是 CSA,奇数层是 HCA。这样 Pro 有 30 个 CSA 层、31 个 HCA 层(它的前两层也是 HCA),Flash 有 21 个 CSA 层、20 个 HCA 层(§2.2)。报告没有给出理由,只说这是一种能降低长上下文开销的“交错混合配置”。
我们的理解是:交替让每隔几层的深度都同时拥有两种视角,一张覆盖全文的粗地图,加上索引器认为相关部分的清晰副本。一层发现的东西,可以引导下一层去看哪里。
下面的动画把两者在 1M token 下并排对比。

没有哪种层在所有长度下都是“便宜的那个”。§6.1 的表显示:到 128K 为止,HCA 读的键不多于 Pro 的 CSA,到 1M 时反而更多。另一方面,CSA 永远要为索引器扫描 $n/4$ 个键付费。混合结构让每种层都待在开销有上界的区间里:CSA 的注意力受 $k$ 限制,HCA 的缓存受 128:1 的压缩比限制。
1M 时单个 Pro 层每个查询的粗略工作量(按配置推算)
这里只粗算一个查询在注意力一侧的乘加次数,忽略投影、softmax 和精度差异。它不是报告的 FLOPs 口径;报告对整个模型使用“等效 FP8 FLOPs”。
- CSA 主注意力: 1,152 个键 × 128 个头 ×(打分 512 + 取值 512)≈ 151M。
- CSA 索引器扫描: 262,144 个键 × 64 个头 × 128 ≈ 2.1B,后训练 QAT 之后以 FP4 计算。
- HCA 注意力: 8,320 个键 × 128 个头 × 1,024 ≈ 1.1B。
在这个长度下,最大的一项是索引器扫描,而不是 CSA 的稀疏注意力。我们的理解是,这与报告专门把这条路径做成 FP4 的思路吻合。报告层面与 V3.2 的 FLOPs 对比见 §9.3。
至于压缩比为什么是 4 和 128、为什么一比一交替,资料几乎没有解释;我们在报告中也没找到针对这两个选择的消融实验。两者都留作开放问题(§14)。
7. mHC:四路残差流,用双随机矩阵混合
普通 Transformer 只有一条残差流:每个子层从中读取输入,再把输出加回去。DeepSeek-V4 把这条流并排复制成四份,并按 token 学习三件事:进入子层前怎样混合四路,子层输出怎样写回,四路之间怎样互相搬运信号。对“搬运”加一条数学约束,就能让 61 层(Flash 为 43 层)叠起来也不发散。
7.1 V4 继承了什么,新增了什么
GLM-5.3 那篇文章(第 8.6 节)在介绍 GLM-5.3-Flash 时讲过 mHC。当时我们没有读过实现它的 Megatron 模块,公式只能取自 mHC 论文。V4 的材料更完整:技术报告写出了全部公式,DeepSeek 的参考推理代码(inference/model.py 加上 kernel.py 里的一个 TileLang kernel)给出了每一步。本节以代码为准。
报告把 mHC 列为 V4 相对 DeepSeek-V3 的三项关键升级之一,另外两项是混合注意力和 Muon 优化器。它的目标是“加强常规残差连接”。更早的超连接(HC,Zhu et al., 2025)已经把残差拓宽,但用 DeepSeek 的话说,训练“在堆叠多层时经常出现数值不稳定”。mHC 保留更宽的残差,再加一条针对这种不稳定的约束。
报告给出的单个子层 $F_l$(注意力或 MoE)更新式是:
\[X_{l+1} = B_l\,X_l + C_l\,F_l\!\left(A_l\,X_l\right), \qquad X_l \in \mathbb{R}^{n_{hc}\times d}\]其中 $n_{hc} = 4$ 路,每路宽 $d$(Pro 为 7,168,Flash 为 4,096)。$A_l$($1\times4$)把四路混成一个子层输入,$C_l$($4\times1$)把子层输出分回四路,$B_l$($4\times4$)负责四路之间的互相混合。
直白地说:普通残差相当于 $n_{hc} = 1$、$A = B = C = 1$,代回去就是 $x + F(x)$。mHC 把这三个 1 换成了小型可学习矩阵,而且每个 token 各不相同。
数字从哪来
- Pro 和 Flash 的配置里都是
hc_mult4、hc_sinkhorn_iters20、hc_eps1e-6;报告的模型设置部分也为两个模型重述了 $n_{hc} = 4$ 与 $t_{\max} = 20$。 - 本节用到的公式 1–8 出自报告 §2.2(“Manifold-Constrained Hyper-Connections”);三项升级的说法见引言与 §2。
- mHC 方法本身来自 Xie et al.(2026),V4 报告引用了这篇论文。
7.2 一个混合点,逐步拆开
V4 每层有两个混合点:一个包住注意力,一个包住 MoE。单个 token 的残差状态在 Pro 中是 $4 \times 7{,}168$ 的块(28,672 个数),在 Flash 中是 $4 \times 4{,}096$(16,384 个数)。嵌入向量复制四份后进入这个状态。每个混合点上,代码做五件事:
- 读取整个状态。 把四路展平成一个长 $4d$ 的向量(Pro 为 28,672)。
- 算出 24 个数。 乘以形状为 $24 \times 4d$ 的可学习矩阵
hc_fn,再除以该向量的均方根。24 个输出分成三组:4 个给 $A$,4 个给 $C$,16 个给 $B$。 - 整形。 $A$ 取
sigmoid(...),每路一个 (0, 1) 内的值;$C$ 取2 * sigmoid(...),落在 (0, 2);$B$ 的 16 个原始值做 Sinkhorn 归一化(见 §7.3)。 - 运行子层。 子层输入是 $\sum_j A_j X_j$,即四路的加权和(一个 $d$ 维向量),随后照常做 RMSNorm,再进入注意力或 MoE。
- 写回。 新的第 $k$ 路 = $C_k \cdot F(\text{输入}) + \sum_j B_{kj} X_j$。
这 24 个数都按报告的方式拆成动态部分和静态部分。记 $\hat{X}_l = \mathrm{RMSNorm}(\mathrm{vec}(X_l))$,$\alpha$ 为可学习的标量门控,$S$ 为可学习的静态偏置:
\[\tilde{A}_l = \alpha^{\text{pre}}_l\,\hat{X}_l W^{\text{pre}}_l + S^{\text{pre}}_l,\qquad A_l = \sigma(\tilde{A}_l),\qquad C_l = 2\,\sigma(\tilde{C}_l)\]$\tilde{B}_l$ 和 $\tilde{C}_l$ 形式相同。门控 $\alpha$“初始化为较小的值”,所以按我们的理解,训练初期主要靠静态偏置起作用。
直白地说,取 Pro 中某个 token 的一个通道,假设四路的值为 $X = [1.0,\ 0.0,\ 2.0,\ 1.0]$(示意数值):
- 混合输入。 设 $A = [0.5, 0.5, 0.5, 0.5]$,子层输入为 $0.5 + 0 + 1.0 + 0.5 = 2.0$。假设子层返回 $0.4$。
- 四路互混。 设 $B$ 对角线为 0.7、其余为 0.1。新的第 $k$ 路得到 $0.7X_k + 0.1 \times$(其余三路之和),结果是 $[1.0,\ 0.4,\ 1.6,\ 1.0]$。总和仍是 4.0:互混只在四路之间搬运信号。
- 加上输出。 设 $C = [1.2, 0.8, 1.0, 1.0]$,四路分别加上 $[0.48, 0.32, 0.40, 0.40]$,变成 $[1.48,\ 0.72,\ 2.00,\ 1.40]$。
有个细节容易漏掉:四个 $A$ 权重是各自独立的 sigmoid,不必加起来等于 1,总和可以在 0 到 4 之间。我们的理解是这无妨:混合之后紧跟子层的 RMSNorm,整体尺度会被归一化掉,所以 $A$ 实际决定的是四路的比例。报告自己给出的理由是,对 $A$ 和 $C$ 用 sigmoid 是为了让它们“非负且有界……避免信号相互抵消”。
实现细节:每一步对应的代码
- 每个混合点的参数(
Block.__init__,全部 float32):hc_attn_fn/hc_ffn_fn形状为 $[24,\ 4d]$,其中 $24 = (2 + 4) \times 4$;hc_*_base形状 $[24]$,即报告中的静态偏置 $S$;hc_*_scale形状 $[3]$,存放三个门控 $\alpha^{\text{pre}}, \alpha^{\text{post}}, \alpha^{\text{res}}$。 - RMSNorm 被折叠进去。
hc_pre在展平后的 float32 状态上计算mixes = linear(x, hc_fn) * rsqrt(mean(x**2) + eps)。矩阵乘之后再缩放,等价于先归一化再乘;这里没有可学习的归一化权重(对应报告中的 $\mathrm{RMSNorm}(\mathrm{vec}(X_l))$)。 - 拆分(
hc_split_sinkhornkernel):$j < 4$ 时pre[j] = sigmoid(mixes[j] * scale[0] + base[j]) + eps;post[j] = 2 * sigmoid(mixes[4 + j] * scale[1] + base[4 + j]);Sinkhorn 之前comb[j, k] = mixes[8 + 4j + k] * scale[2] + base[8 + 4j + k]。eps即hc_eps= 1e-6。 - 层内顺序(
Block.forward):hc_pre→attn_norm→ 注意力 →hc_post,然后hc_pre→ffn_norm→ MoE →hc_post,两个混合点各有一套参数。 - 下标约定。
hc_post把新的第 $k$ 路算成 $C_k F + \sum_j \texttt{comb}[j,k]\,X_j$,所以代码里的comb是报告中 $B_l$ 的转置。§7.3 说明为什么两种写法仍然一致。 - 精度。 系数计算和混合都在 float32 中进行;
hc_pre的输出转回其输入的 dtype,hc_post的输出转回子层(注意力或 MoE)输出的 dtype。
7.3 Sinkhorn:把 4 × 4 混合矩阵压成双随机矩阵
mHC 名字里的“约束”加在 $B_l$ 上:它必须是双随机矩阵,即所有元素非负,且每行、每列之和都为 1。报告指出了其中关键的两条性质:
- 这样的矩阵谱范数不超过 1,残差混合因此是“非扩张”的:它不会放大信号。报告认为这提升了“前向传播和反向传播中”的数值稳定性。
- 这个集合“对乘法封闭”:Pro 的 61 层共 122 个混合矩阵(Flash 为 86 个),乘起来仍是双随机矩阵,所以整个深层堆叠也保持有界。
不加约束的 HC 两条都没有保证。谱范数略大于 1 的混合矩阵,每过一个混合点就把信号放大一点;122 个混合点下来,这一点会不断累积。
为了落到这个集合上,V4 使用 Sinkhorn–Knopp 算法:先用 $\exp(\cdot)$ 把 16 个原始值变成正数,再交替归一化:
\[M^{(0)} = \exp\!\big(\tilde{B}_l\big),\qquad M^{(t)} = \mathcal{T}_r\!\big(\mathcal{T}_c(M^{(t-1)})\big),\qquad B_l = M^{(t_{\max})},\quad t_{\max} = 20\]其中 $\mathcal{T}_c$ 把每列除以该列之和,$\mathcal{T}_r$ 对行做同样的事。每一步把一个方向的和校正为 1,同时略微打乱另一个方向;几轮之后两者都接近 1。报告称 20 是“一个实用的取值”。
直白地说,看一个 $2\times 2$ 的例子:从两行 $(2, 1)$ 和 $(1, 1)$ 出发。先做列归一化,两行变成 $(0.667, 0.5)$ 和 $(0.333, 0.5)$,行和为 1.167 和 0.833。再做行归一化,得到 $(0.571, 0.429)$ 和 $(0.4, 0.6)$,这时两列之和为 0.971 和 1.029。一轮下来,最大误差从 0.167 降到 0.029,之后每轮继续缩小。
每轮最后一步是精确归一化,所以最终的 $B_l$ 在一个方向上精确、另一个方向上近似。按报告的顺序(先列后行),$B_l$ 每行之和精确为 1(误差仅来自每次求和时加上的 1e-6 eps)。对更新式来说,这正是要紧的方向:每条新流都是旧流的加权平均。
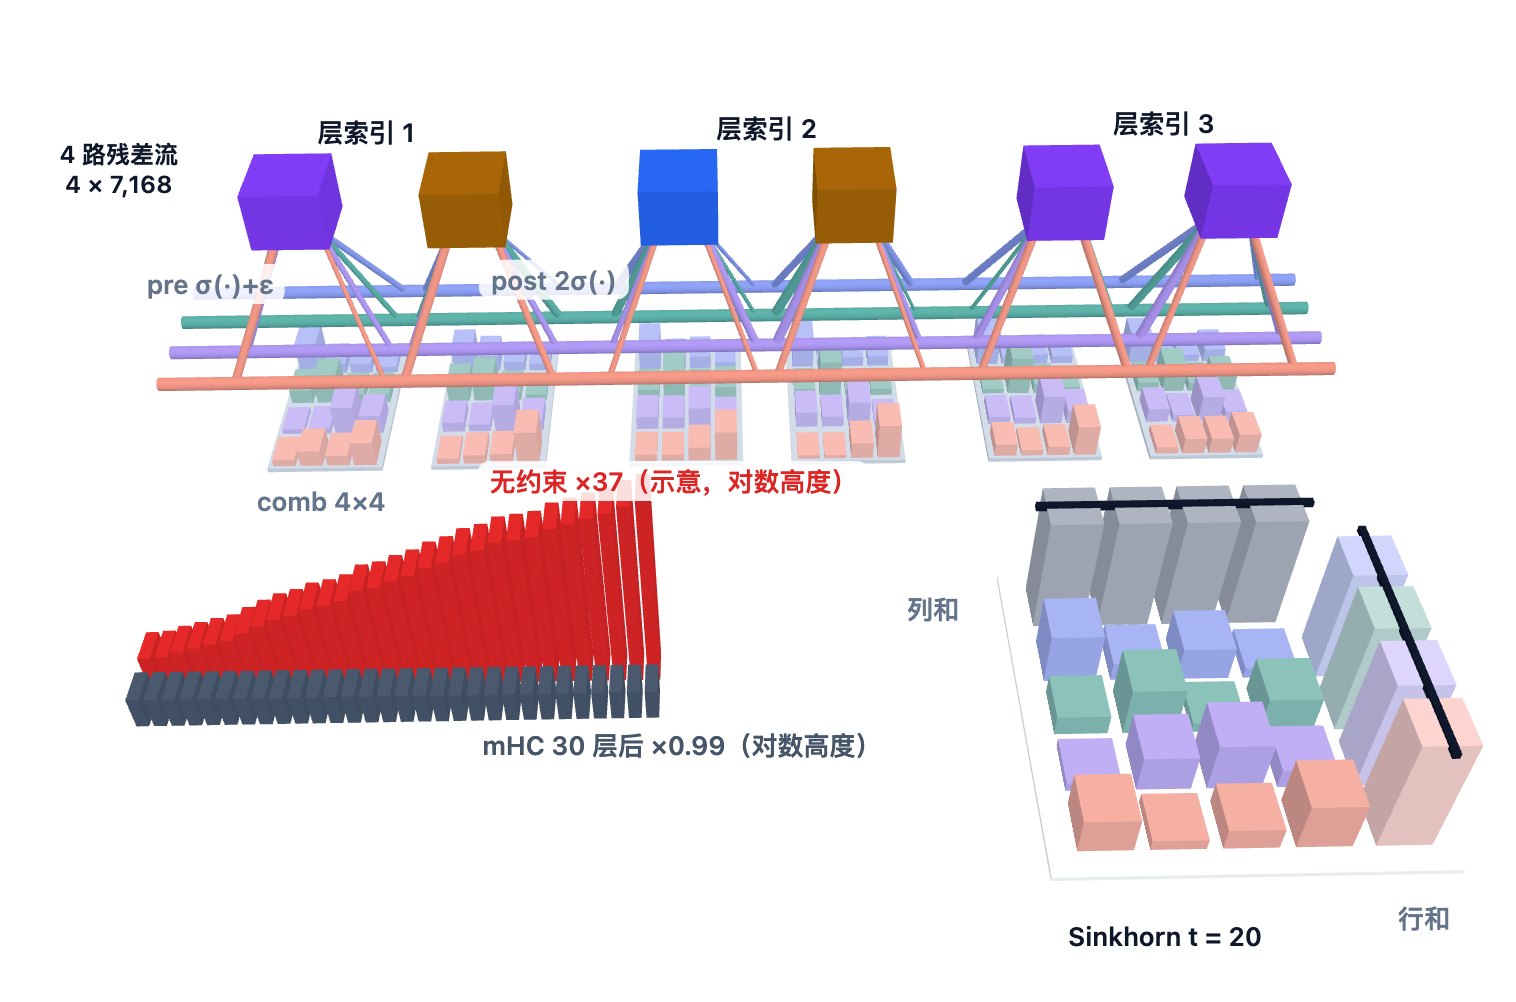
上面的 3D 模型可以逐轮拖动 20 次 Sinkhorn 迭代,并对比有约束和无约束的混合矩阵;其中的矩阵数值仅作示意。
实现细节:kernel 里的 Sinkhorn,以及代码与报告为何一致
- TileLang kernel
hc_split_sinkhorn为每个 token 分配一个 GPU 线程块,把 $4 \times 4$ 矩阵放在片上存储里计算。 - 第一轮是行 softmax 加
eps(即 $\exp$ 后做行归一化),再做一次列归一化;之后再跑sinkhorn_iters - 1= 19 轮“先行后列”的归一化,总共 20 轮。后续每次除法都在和上加eps(1e-6)。 - 代码先行后列,和报告公式 8 的顺序相反。但代码里的
comb是报告中 $B_l$ 的转置(见 §7.2 的实现细节),转置恰好交换行与列,所以两者描述的是同一个计算。两种写法下,每条新流收到的权重之和都精确为 1,每条旧流分出去的权重之和约为 1。 - 只跑有限的 20 轮,矩阵只是近似双随机;上面的保证在这个微小误差范围内成立。
7.4 四路残差的代价
参数上几乎不花钱。每个混合点的 hc_fn 在 Pro 中是 $24 \times 28{,}672 = 688{,}128$ 个权重,在 Flash 中是 $24 \times 16{,}384 = 393{,}216$ 个。Pro 共 122 个混合点、Flash 共 86 个,按我们的统计合计约 84.0M 和 33.8M 个权重,约占总参数的 0.005% 和 0.01%。计算量也很小:每个混合点上,算这 24 个系数的乘加次数约为每个 token 过一个 Pro 专家的 1%(按形状推算)。
真正的代价在宽度。层与层之间,每个 token 要携带 $4d$ 个数而不是 $d$ 个:Pro 中是 28,672 而非 7,168。报告说 mHC“同时增加了激活显存占用和流水线阶段之间的通信量”,并列出三项对策:
- 融合 kernel:训练和推理都为 mHC 写了融合 kernel。
- 选择性重计算:层间的大部分隐藏状态和全部归一化后的层输入在反向时重算,不做存储;计算密集的算子不重算。
- 调整流水线调度:DeepSeek 修改了 DualPipe 的 1F1B(一前向一反向交替)流水线调度中的重叠方案,以吸收多出来的流水线通信,并让 mHC 的部分操作并发执行。
有了这些措施,报告给出的 mHC 墙钟开销“仅为重叠后 1F1B 流水线阶段的 6.7%”。
到了网络顶端,四路必须重新合成一个向量交给 LM head。V4 用的是又一次可学习的混合(hc_head):从状态算出四个 sigmoid 权重,算法与混合点上的 $A$ 相同,但没有 Sinkhorn,也没有写回。之后是最终的 RMSNorm 和 LM head。(相比之下,GLM-5.3-Flash 只是把四路简单取平均。)
实现细节:输出头、MTP、优化器、确定性
hc_head(ParallelHead):hc_head_fn形状 $[4,\ 4d]$,hc_head_base形状 $[4]$,hc_head_scale形状 $[1]$;先做同样折叠进去的 RMS 归一化,再算权重sigmoid(mixes * scale + base) + eps。推理时只计算最后一个位置的 logits。- MTP。
MTPBlock继承自Block,所以多 token 预测层也有自己的两个混合点,以及自己的hc_head(hc_head_fn/_base/_scale)。上面的 122 / 86 只统计主干层。 - 优化器。 V4 大部分权重用 Muon 训练,但报告对“mHC 的静态偏置和门控因子”(代码中的
hc_*_base与hc_*_scale)保留 AdamW,同样用 AdamW 的还有嵌入、预测头和全部 RMSNorm 权重。按这条规则,动态投影(hc_*_fn)和其余参数一样用 Muon。 - 确定性。 报告在确定性 kernel 部分专门提到 mHC:它的矩阵乘输出维度只有 24,batch 很小时不得不用 split-k。为保证结果确定,每个分片单独输出,再由后续 kernel 做确定性归约。24 即 $4 + 4 + 16$。
- 统计口径。 参数量和计算量都按上面的形状推算(只算
hc_fn;每个混合点的偏置和门控另有 27 个数)。“1%”是 688,128 次乘加与 Pro 单个专家 $3 \times 7{,}168 \times 3{,}072 \approx 66.1$M 的对比。
8. MoE:384 或 256 个专家,每次只用 6 个
V4 每一层的前馈部分都是 MoE 层:一大批小网络,每个 token 只用其中几个。V4 沿用 DeepSeek-V3 的设计,报告称“只做了少量调整”。但这些调整值得了解:新的打分函数;完全取消稠密层;前三层由固定查表挑选专家;专家内部加了截断;路由专家用 4 位浮点存储。
8.1 一层 MoE 的数字
每个 MoE 层有大量路由专家,每个 token 访问其中 6 个;另有 1 个共享专家,所有 token 都会经过。每个专家是一个小型 SwiGLU 前馈网络,含三个矩阵(gate、up、down)。
| V4-Pro | V4-Flash | |
|---|---|---|
| 每层路由专家数 | 384 | 256 |
| 每层共享专家数 | 1 | 1 |
| 每个 token 选用的路由专家数 | 6 | 6 |
| 专家宽度(中间维度) | 3,072 | 2,048 |
| 单个专家参数量(推算) | $3 \times 7{,}168 \times 3{,}072 \approx 66.1$M | $3 \times 4{,}096 \times 2{,}048 \approx 25.2$M |
| 每层每个 token 用到的专家参数(推算) | 385 个专家中的 7 个,约 462M(1.8%) | 257 个专家中的 7 个,约 176M(2.7%) |
路由缩放系数(routed_scaling_factor) |
2.5 | 1.5 |
| MoE 层数 | 全部 61 层 | 全部 43 层 |
| 哈希路由层 | 第 0、1、2 层 | 第 0、1、2 层 |
最后两行体现了第一处变化:DeepSeek-V3 开头几层是稠密前馈层,V4 一层都没有。报告说它把“开头若干个 Transformer 块中的稠密 FFN 层替换为采用哈希路由的 MoE 层”,参考代码也在每个块里都构建 MoE。路由专家占了模型的绝大部分:按我们的统计,约占 Pro 参数的 98%、Flash 的 97%(见 §2.3)。
数字从哪来
- 配置键(Pro / Flash):
n_routed_experts384 / 256,n_shared_experts1,num_experts_per_tok6,moe_intermediate_size3072 / 2048,scoring_funcsqrtsoftplus,topk_methodnoaux_tc,norm_topk_probtrue,routed_scaling_factor2.5 / 1.5,num_hash_layers3,swiglu_limit10.0,expert_dtypefp4。报告的模型设置部分(§4.2.1)重述了专家数、宽度、top-6 以及前三层哈希路由。 - 参考代码的
MoE类断言共享专家恰好 1 个,宽度与路由专家相同。Block总是构建MoE,没有稠密 FFN 分支,配置里也没有first_k_dense_replace键。 - 单个专家参数量不含 FP4 缩放因子张量。每 token 参数按 6 个路由专家 + 1 个共享专家计,不含路由器。
8.2 用 sqrt(softplus) 打分,用偏置挑选
路由器(gate)把 token 的隐藏向量 $h$ 变成 6 个专家的选择,以及每个专家的权重。在可学习路由层(第 3 层及以上)分四步:
- 打分。 在 float32 中把 $h$ 乘以门控矩阵(Pro 为 $384 \times 7{,}168$,Flash 为 $256 \times 4{,}096$),再对每个 logit $\ell_i$ 计算 $s_i = \sqrt{\mathrm{softplus}(\ell_i)}$,其中 $\mathrm{softplus}(x) = \ln(1 + e^x)$。
- 挑选。 给每个专家加上偏置 $b_i$,取 $s_i + b_i$ 最大的 6 个。
- 加权。 去掉偏置,用 6 个胜出者的原始分数除以它们的和,再乘以路由缩放系数:Pro 为 2.5,Flash 为 1.5。
- 合并。 6 个路由专家的加权和,再加上共享专家的输出。
其中 $\lambda = 2.5$(Pro)或 $1.5$(Flash)。参考代码用一行注释说清了这一点:偏置“只为专家选择(topk)平移分数,不影响路由权重”。
直白地说:专家 41 得分 1.10、偏置 −0.05,专家 7 得分 1.00、偏置 +0.08。挑选时比较 1.05 和 1.08,名额归专家 7。如果 6 个胜出者的原始分数之和为 6.4,Pro 中专家 7 的权重就是 $2.5 \times 1.00 / 6.4 \approx 0.39$。偏置决定选谁,原始分数决定给多少。
第 3 步有个副作用(由代码推出):6 个路由权重之和在 Pro 中恒为 2.5(Flash 为 1.5),而共享专家相当于固定权重 1。
为什么用 sqrt(softplus)? DeepSeek-V3 这里用的是 sigmoid。报告只说 V4 把亲和度函数“从 Sigmoid(·) 换成 Sqrt(Softplus(·))”,没有给出理由。两条曲线的行为不同:
| Logit $\ell$ | −2 | 0 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|---|
| $\sigma(\ell)$ | 0.119 | 0.500 | 0.881 | 0.982 | 1.000 | 1.000 |
| $\sqrt{\mathrm{softplus}(\ell)}$ | 0.356 | 0.833 | 1.458 | 2.005 | 2.828 | 4.000 |
两者都恒为正,第 3 步的归一化需要这一点。sigmoid 在 1 处饱和,logit 为 8 和 16 的两个专家看起来一样;$\sqrt{\mathrm{softplus}}$ 会继续缓慢增长,logit 大时约为 $\sqrt{\ell}$,所以强烈的偏好仍能体现在权重里。这是我们对曲线的解读,不是报告给出的动机。
保持负载均衡。 和 V3 一样,V4 主要靠偏置均衡专家负载:“无辅助损失策略”把过载专家的偏置调低、把空闲专家的偏置调高(GLM-5.3 那篇文章第 4.3 节有详细讲解)。V4 另外加了“一个轻微的序列级均衡损失,防止单条序列内出现极端失衡”。报告给出的偏置更新速度为 0.001,均衡损失权重为 0.0001。
V4 还去掉了 V3 的一项限制。V3 限制一个 token 的专家最多分布在几个节点上;V4“取消了对路由目标节点数的约束”,并重新设计并行策略来维持训练效率。参考代码的 gate 中,所有专家在同一个池子里竞争,没有分组限制。
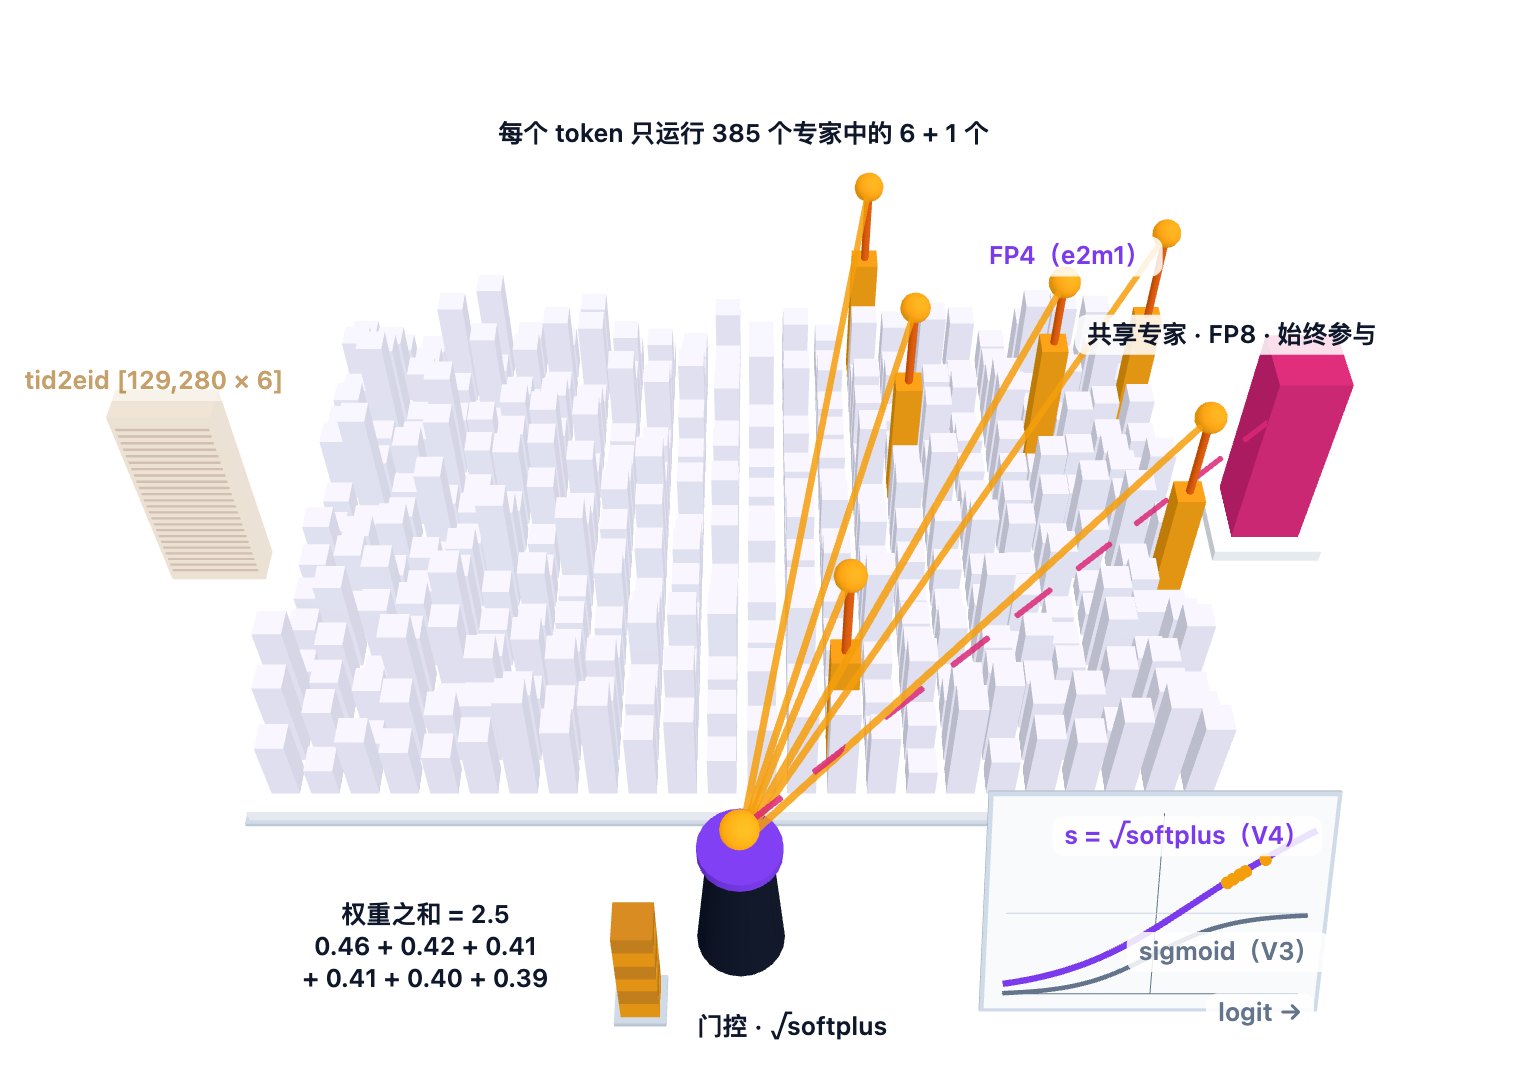
上面的 3D 模型可以让一个 token 走哈希层或可学习路由层,并切换偏置开关。专家数、公式和数据类型都是精确的;分数和查表内容是合成的。
实现细节:参考代码中的 gate
Gate.forward先算scores = linear(x.float(), weight.float());score_func为 sqrtsoftplus 时再算softplus(scores).sqrt()。代码也支持softmax和sigmoid,V4 的配置选的是 sqrtsoftplus。- 它保留
original_scores,只在调用topk时加上 float32 偏置(形状[n_routed_experts]),权重则从original_scores中取。除 softmax 外,所有打分函数都会做归一化,然后weights *= route_scale。 - 路由权重在专家内部生效:乘在 SwiGLU 输出上、down 投影之前(见 §8.4)。共享专家调用时不带权重。
- gate 的输入是该层
ffn_norm的输出,也就是 §7.2 中经 mHC 混合并归一化后的向量。
8.3 前三层的哈希路由
在第 0、1、2 层,路由器根本不挑专家,挑专家的是一张固定的表:词表里 129,280 个 token ID,每个都对应一份预先定好的 6 个专家名单。报告把它称为“哈希路由(Roller et al., 2021)”,即“每个 token 的目标专家”由“关于输入 token ID 的一个预定义哈希函数”决定。
参考代码把这件事落到了实处。哈希层的 gate 持有一张形状为 $[129{,}280 \times 6]$ 的表 tid2eid,以 int32 存在 checkpoint 里,并且冻结(requires_grad=False)。路由一个 token 就是一次查表:
- 选谁: 读出表中第
token_id行,得到 6 个专家编号。这里不涉及偏置,哈希层根本没有偏置。 - 给多少: 像 §8.2 一样,为所有专家计算可学习的 sqrt(softplus) 分数,取出这 6 个专家的分数,归一化后乘以路由缩放系数。
所以哈希层并不是等权层:查表决定谁接收 token,可学习的 gate 仍然决定 6 个专家各贡献多少。下面的动画把两种情况都走一遍。

直白地说:假设表的第 4,821 行是 $[17, 203, 88, 350, 5, 129]$(合成数据),那么在第 1 层,token 4,821 无论出现在什么上下文里,都会被送到这 6 个专家。但每次出现时的权重可以不同,因为 gate 分数取决于隐藏状态。
为什么在网络底部按 token ID 路由?资料没有说明。我们的理解是:前几层里,token 的隐藏状态还很接近它的嵌入向量,可学习路由器能利用的信息基本只有 token 本身是谁;固定的表在这里提供完全可预测、稳定的路由,同时让这几层保持稀疏。
资料没有告诉我们的
- 表是怎么生成的。 checkpoint 只把
tid2eid当作数据发布;参考代码和报告都没有给出哈希函数,也没说它是否在专家之间均衡负载、一行里能否出现重复专家。 - 哈希层的 gate 怎么训练。 它的权重决定路由权重,所以推测它像其他 gate 一样接收梯度,但这些层的训练细节没有描述。
- 表的大小(推算):$129{,}280 \times 6$ 个 int32,每个哈希层约 3.1 MB。
Gate.__init__中self.hash = layer_id < n_hash_layers,两份配置的num_hash_layers都是 3。多 token 预测层的层号大于 60(Pro)或 42(Flash),所以它用的是可学习路由。
8.4 专家内部:带截断的 SwiGLU
每个专家,无论路由专家还是共享专家,都是一个 SwiGLU 网络:输入经过两个投影,gate 投影 $W_1 h$ 和 up 投影 $W_3 h$;gate 分支过 SiLU 后与 up 分支逐元素相乘;down 投影 $W_2$ 再把结果映射回宽度 $d$。V4 只加了一件事:相乘之前,两个分支都要截断。
\[u = \mathrm{clip}(W_3 h,\,-10,\,10),\qquad v = \min(W_1 h,\ 10),\qquad E(h) = W_2\big(g \cdot \mathrm{SiLU}(v) \odot u\big)\]这里 $g$ 是 §8.2 中该 token 分给这个专家的路由权重(共享专家 $g = 1$)。代码在 down 投影之前乘上它;$W_2$ 是线性的,所以数学上与对输出加权等价。
直白地说:SiLU 在输入为 10 时最大约 9.9995,最小也不低于约 −0.28,所以两边都截断后,$\mathrm{SiLU}(v) \odot u$ 的每个元素都在约 ±100 以内(推算)。没有截断时,一个异常大的激活值会直接进入 down 投影。
这道截断是训练稳定性措施,并且保留在模型里。报告说 V4 训练中的 loss 尖峰“始终与 MoE 层中的离群值相关”,而 SwiGLU 截断“有效消除了离群值……且不损害性能”。两个模型的整个训练过程中,线性(up)部分都截断到 $[-10, 10]$,gate 的上限为 10。配置里对应的值是 swiglu_limit 10.0,参考推理代码在每个路由专家和共享专家中都执行这一截断。§10.3 把这道截断与另一项稳定性措施“预判式路由”(anticipatory routing)放在一起讨论。
8.5 路由专家用 FP4,共享专家用 FP8
路由专家以 FP4 存储:4 位浮点数,1 位符号、2 位指数、1 位尾数(E2M1),两个数打包成一个字节,每 32 个权重共用一个 8 位、2 的幂形式的缩放因子。共享专家保持 FP8(E4M3,每个 128 × 128 块一个缩放因子),这是 checkpoint 中量化权重的默认格式。运行时,FP4 权重与 FP8 激活相乘。
按我们的统计,Pro 单个专家用 FP4 存储约 35.1 MB(含缩放因子),用 FP8 则约 66.1 MB。全部 61 层加起来,Pro 的路由专家约 822 GB;Flash 的 43 层约 147 GB。
FP4 目前换不来的是算力。报告说得很明确:“在现有硬件上,FP4 × FP8 运算的峰值 FLOPs 目前与 FP8 × FP8 相同”,不过“理论上可以在未来硬件上实现高出 1/3 的效率”。眼下的收益在显存:存储的字节更少,每个 token 要读的字节也更少(我们的理解:这在解码阶段最重要,因为那时专家权重每次只服务寥寥几个 token)。
FP4 权重来自后训练阶段的量化感知训练,而不是预训练;具体做法见 §10.4。
实现细节:数据类型、大小与融合 MoE kernel
- 代码中的数据类型。 配置为
expert_dtype: fp4时,MoE.__init__用torch.float4_e2m1fn_x2构建路由专家;共享专家构建时不指定 dtype,因此采用模型默认的 FP8 E4M3(quantization_config:e4m3、动态激活缩放、ue8m0 缩放格式、128 × 128 权重块)。FP4 的Linear把权重存为[out, in/2]的打包字节,外加形状为[out, in/32]的float8_e8m0fnu缩放因子;前向时先把激活量化为 FP8,再调用fp4_gemm。 - 专家计算精度。
Expert.forward在 float32 中计算 gate 与 up 分支、截断和 SiLU,然后转回原 dtype 再做 down 投影。 - 大小推算:含缩放因子时,FP4 每个权重占 $0.5 + 1/32 = 0.53125$ 字节,所以 Pro 单个专家为 $66{,}060{,}288 \times 0.53125 \approx 35.1$ MB(Flash:$25{,}165{,}824 \times 0.53125 \approx 13.4$ MB)。路由专家总量按 $61 \times 384$ 个(Pro)和 $43 \times 256$ 个(Flash)计算,只算主干层。
- 融合 MoE kernel(报告 §3.1)。DeepSeek 把 dispatch、两次专家矩阵乘和 combine 融合成一个 kernel,并把专家分成若干“波次”(wave),让当前波次的计算、下一波次的 token 接收和已完成结果的发送同时进行。与强力的非融合基线相比,报告称通用推理提速 1.50–1.73 倍,强化学习 rollout 等延迟敏感场景最高 1.96 倍,在 NVIDIA GPU 和华为昇腾 NPU 上都做了验证。CUDA 版本以 MegaMoE 之名开源在 DeepGEMM 中。
- 同一节里的一条硬件经验。 V4-Pro 中每个 token–专家对需要 $6hd$ FLOPs 计算,却只有 $3h$ 字节通信(FP8 dispatch、BF16 combine),所以当算力与带宽之比 $C/B \le 2d = 6{,}144$ FLOPs/字节时,通信可以被完全隐藏,其中 $d = 3{,}072$ 为专家宽度。报告还建议用不含指数和除法的廉价逐元素激活函数替代 SwiGLU。
9. 长上下文:YaRN、KV cache,以及与 V3.2 的 FLOPs 对比
百万 token 的上下文,V4 到底要付出多少代价,又该怎么部署?这一节把前面的机制拼起来,回答三个问题:位置编码怎样延伸到 1,048,576 个 token;这么长的上下文,cache 要多少字节;每层 cache 形状都不一样,服务端怎么存。
9.1 把位置延伸到 1M
RoPE 把通道两两配对,每一对以不同的速度旋转,以此编码位置。转得快的通道对负责区分相邻 token,转得慢的负责区分相距很远的 token。只在短序列上训练过的模型,从没见过最慢的那几对转出很大的角度,要读懂没训练过的位置就需要帮助。YaRN 是常用的办法:只让慢速通道对转得更慢,快速通道对保持不动。
两份 config 的 YaRN 设置完全相同:
设置(config 中的 rope_scaling 及相关字段) |
V4-Pro | V4-Flash |
|---|---|---|
type |
yarn | yarn |
original_max_position_embeddings |
65,536 | 65,536 |
factor |
16 | 16 |
beta_fast / beta_slow |
32 / 1 | 32 / 1 |
max_position_embeddings |
1,048,576 | 1,048,576 |
压缩层的 RoPE 基数(compress_rope_theta) |
160,000 | 160,000 |
纯窗口层的 RoPE 基数(rope_theta) |
10,000 | 10,000 |
直白地说:65,536 × 16 = 1,048,576,16 倍的放大系数正好把 64K 的设计长度变成宣传的 1M 窗口。
参考代码里还有一个论文从没提过的细节(技术报告正文完全没有讨论 YaRN):YaRN 和更大的基数只用在带压缩器的层。压缩比为 0 的层只看自己的 128 token 窗口,用的是基数 10,000 的普通 RoPE,不开 YaRN。代码注释写得很直接:“disable YaRN and use base rope_theta in pure sliding-window attention”。
由于两个模型的前两层不同(§2.2),这条规则落到两者身上也不一样:
- V4-Pro:61 个主干层全是 CSA 或 HCA,因此全部使用 YaRN,基数 160,000。
- V4-Flash:第 0、1 层是纯窗口层,用基数 10,000、不开 YaRN;其余 41 层使用 YaRN。
- 两者共同:MTP 模块在
compress_ratios里对应的值是 0,所以它也是纯窗口层(按 config 与代码推算)。
我们的理解:纯窗口层比较的两个位置相距从不超过 128 个 token,不会碰到训练中没见过的距离;拉伸它的旋转反而只会让位置变模糊。
举一个小例子,看 16 倍系数对 V4 的 64 个 RoPE 通道(32 个旋转对)做了什么。用参考代码里的修正区间公式,代入基数 160,000、原始长度 65,536、beta 32 / 1,得到下面的划分(公式来自代码,数字是我们自己算的):
| 通道对(共 32 对) | 基数 160,000 下的波长 | YaRN 的处理 |
|---|---|---|
| 0–15 | 约 6 到 1,700 个 token | 不变:在 64K 内已经转了很多圈 |
| 16–24 | 介于两者之间 | 沿线性斜坡混合 |
| 25–31 | 约 73,000 到 691,000 个 token | 频率除以 16 |
最慢的几对在 64K 的跨度内连一圈都转不完。把它们的速度除以 16,1M 的范围就被映射回 64K 设计已经覆盖的角度。V4 确实在长达 1M 的序列上训练过(见下方细节),但资料没有说明 YaRN 表是在哪个阶段启用的。
实现细节
Attention.__init__按层选择 RoPE 表:compress_ratio > 0时取original_seq_len, rope_theta = args.original_seq_len, args.compress_rope_theta,否则取0, args.rope_theta(inference/model.py约第 475–482 行)。precompute_freqs_cis只在original_seq_len > 0时应用 YaRN(第 200–228 行)。- 每层只有一个
freqs_cis缓冲区,窗口 key、压缩器和索引器共用。因此在 CSA 或 HCA 层里,连窗口内 128 个原始 token 也用 YaRN 表旋转。 - YaRN 公式为
freqs = freqs / factor * (1 - smooth) + freqs * smooth,其中smooth是按通道对序号变化的斜坡,区间由find_correction_range(32, 1, 64, 160000, 65536)给出,我们算得 (15, 25)。 - 参考实现的 softmax 缩放为 $512^{-1/2}$(
self.softmax_scale = self.head_dim ** -0.5);在 V4 的model.py里没有找到 YaRN 的注意力温度(mscale)因子。 - 训练长度来自论文:预训练期间序列长度从 4K 逐步扩展到 16K、64K,最后到 1M(报告 §4.2.2)。论文没有把这些阶段和 YaRN 设置联系起来,我们也不做推测。
9.2 1M 上下文下的 cache
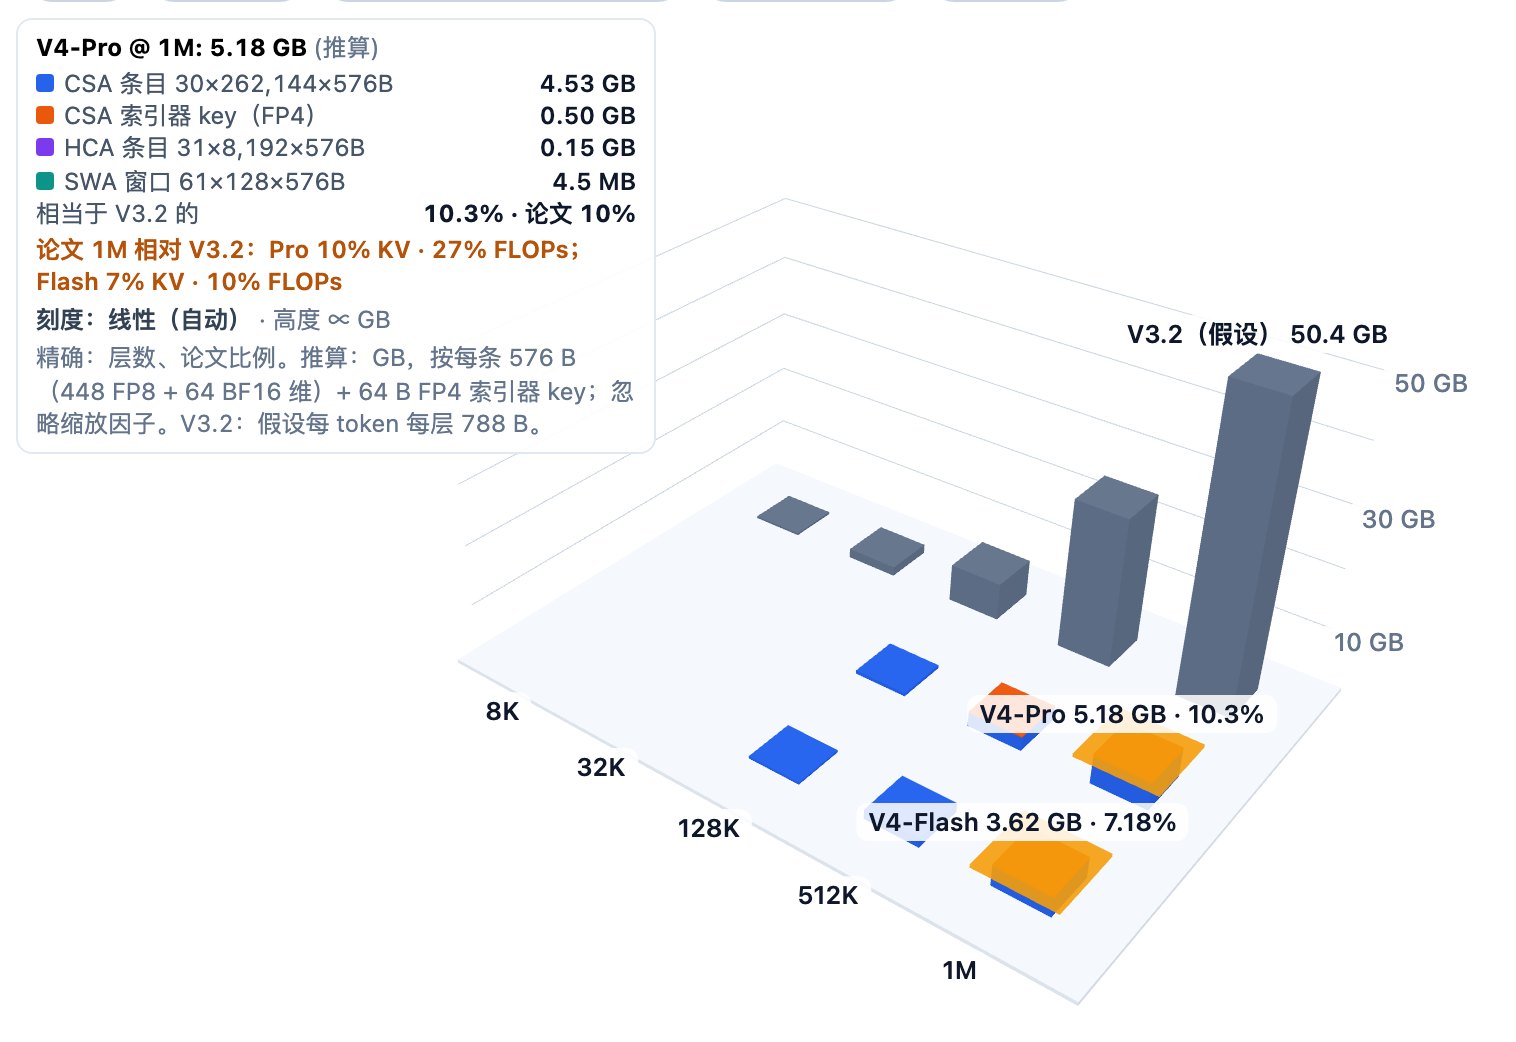
KV cache 是模型为每个历史 token 保存的记忆,免得重复计算。V4 同时从三个方向压缩它:每层的条目更少(压缩),所有头共享同一个 512 维条目(§3),每个数用的字节更少。核心结论来自论文:按论文的估算,在 1M token 下,V4-Pro 的 KV cache 只有 DeepSeek-V3.2 的 10%,V4-Flash 只有 7%。
用一个简单的字节模型,可以从 config 重建这两个百分比。每层、每个存储条目:
- 主条目:448 维 FP8 加 64 维 BF16 的 RoPE 部分,448 + 128 = 576 字节(忽略少量 FP8 缩放因子字节)。论文说这种混合格式让 cache 比纯 BF16(512 × 2 = 1,024 字节)“减少近一半”。
- 索引器 key(仅 CSA):128 维 FP4 = 64 字节(忽略少量 MXFP4 缩放因子字节)。
- 窗口:每层 128 个主条目,固定 128 × 576 = 73,728 字节,与上下文长度无关。
再数一数 $n$ = 1,048,576 个 token 时的条目数。CSA 层存 $n/4$ = 262,144 个条目,HCA 层存 $n/128$ = 8,192 个。以 V4-Pro(30 个 CSA 层、31 个 HCA 层)为例:
\[\underbrace{30 \times 262{,}144 \times (576+64)}_{\text{CSA: } 5.03\ \text{GB}} + \underbrace{31 \times 8{,}192 \times 576}_{\text{HCA: } 0.146\ \text{GB}} + \underbrace{61 \times 128 \times 576}_{\text{窗口: } 4.5\ \text{MB}} \approx 5.18\ \text{GB}\]直白地说:每层、每个上下文 token,CSA 层花 (576 + 64) / 4 = 160 字节,HCA 层只花 576 / 128 = 4.5 字节。
| 1M token 时(按配置推算) | CSA 层 | HCA 层 | 窗口 | 合计 | 相对 V3.2 | 论文 |
|---|---|---|---|---|---|---|
| DeepSeek-V3.2(外部假设) | — | — | — | 约 50.4 GB | 100% | — |
| V4-Pro | 5.03 GB(30 层) | 0.146 GB(31 层) | 4.5 MB(61 层) | 约 5.18 GB | 10.3% | 10%(“9.5x smaller”) |
| V4-Flash | 3.52 GB(21 层) | 0.094 GB(20 层) | 3.2 MB(43 层) | 约 3.62 GB | 7.2% | 7%(“13.7x smaller”) |
推算出的比例与论文数字只差舍入误差,所以这个字节模型可以用来看 V4 的字节花在哪里。有三点值得注意:
- cache 几乎全是 CSA。V4-Pro 的 5.18 GB 中约 97% 在 CSA 层,其中大约十分之一是索引器 key。我们的理解:4:1 的条目加上索引器 key,是细粒度稀疏检索的代价。
- HCA 几乎免费。31 层、每层都能看到全部百万 token,加起来只要 0.146 GB。
- 窗口是常数。不论提示词是 1,000 个 token 还是一百万个,V4-Pro 的窗口都是 4.5 MB。
论文还给了另一个参照:与 8 个 KV 头、头维度 128 的 BF16 分组查询注意力(GQA8)基线(一种常见的注意力配置)相比,V4 在 1M 时的 cache“约为 2%”。我们的算术与之吻合:该基线每层每 token 存 2 × 8 × 128 × 2 = 4,096 字节,61 层、1M token 约 262 GB,5.18 / 262 ≈ 2.0%(按配置推算,假设层数相同)。
数字从哪来
- 确切值(论文):1M 时为 V3.2 KV cache 的 10% / 7%(报告摘要与 §1;图 1 右侧标注“9.5x smaller”和“13.7x smaller”);BF16/FP8 混合存储比纯 BF16“减少近一半”;索引器注意力用 FP4 计算;约为 BF16 GQA8、头维度 128 基线的“2%”(报告 §2.3.4)。
- 确切值(config):层类型来自
compress_ratios(Pro:30 CSA + 31 HCA;Flash:21 CSA + 20 HCA + 2 个纯窗口层),head_dim512,qk_rope_head_dim64,index_head_dim128,sliding_window128。 - 推算值(我们算的):上面所有 GB 数字。字节大小依据论文的存储描述和参考代码的量化方式(448 个非 RoPE 维度用
act_quant,索引器 key 用fp4_act_quant)。GB 按十进制(10⁹ 字节)。 - 外部假设:V3.2 参照值为每层每 token 788 字节(656 字节 FP8 MLA 潜向量加 132 字节索引器 key,参照 FlashMLA 的 FP8 cache 布局),共 61 层。V4 报告没有给出这个数;它与图 1 KV 轴约 50 GB 的上限吻合。
- 参考代码把每层的窗口和压缩条目放在同一个缓冲区里,共
window_size + max_seq_len // compress_ratio行、每行 512 维(inference/model.py第 473 行)。上面的字节数按论文的存储格式计算,而不是按这个缓冲区的 dtype。
9.3 每个 token 的计算量
字节只是一半,另一半是每生成一个 token 的算术量。论文在 1M 上下文处给了两个锚点,单位是论文估算的“等效 FP8 FLOPs”(论文使用的单位,未给出换算方式):V4-Pro 的单 token FLOPs 只有 V3.2 的 27%(图 1 标注“3.7x lower”),V4-Flash 只有 10%(“9.8x lower”)。论文特别强调,即便 Pro 每个 token 的激活参数比 V3.2 还多,也做到了这一点。
论文只公布了 1M 处的数字,没有分项,所以我们不画 FLOPs 曲线。能精确给出的,是每种层里一个 query 要读多少个缓存条目:
| 层类型 | 每个 query 读取的 key 数(上下文 $n$) | $n$ = 1M 时 | 来源 |
|---|---|---|---|
| 纯窗口层 | 128 | 128 | config |
| CSA,V4-Pro | 128 + min(1,024, ⌊$n$/4⌋) | 1,152 | config index_topk 1,024 |
| CSA,V4-Flash | 128 + min(512, ⌊$n$/4⌋) | 640 | config index_topk 512 |
| HCA(两者) | 128 + ⌊$n$/128⌋ | 8,320 | 由压缩比 128 推算 |
| V3.2 DSA(参照) | min(2,048, $n$) | 2,048 | 外部:V3.2 的 index_topk |
直白地说:1M 时,V4-Pro 的一个 CSA 层读 1,024 个选中的压缩条目,加上最新的 128 个原始 token;每个选中条目由 8 个 token 压缩而来(步长 4,每 4 个 token 生成一个条目)。
有两点要说清楚。第一,1M 时 HCA 层读的条目(8,320)比 V3.2 层(2,048)还多,所以只看条目数解释不了 27%。第二,CSA 层的闪电索引器在选 top-k 之前,仍要给每个压缩条目打分:1M 时有 262,144 个候选,用 64 个头、每头 128 维、FP4 计算。V3.2 的索引器要给每个 token 打分,候选数是它的四倍(来自 V3.2 的设计,不在 V4 报告里)。我们的理解是,节省来自几方面的叠加:索引器的候选更少;top-k 更小(论文把它列为提升中短文本效率的选择);HCA 的稠密注意力很便宜;再加上 FP4/FP8 运算。
9.4 异构 cache 怎么部署
常见的推理服务器把每层 cache 切成大小相同的页,每页对应固定数量的 token。V4 打破了这个习惯:CSA 层每 4 个 token 新增一个条目,HCA 层每 128 个 token 新增一个,而且每层都还有一个滑动的 128 token 窗口。论文的办法是把 cache 拆成两个池:一个随上下文增长,一个不增长。
论文指出 PagedAttention 式分页不能直接套用的两个原因:各层的缓存策略不同(滑动窗口会淘汰旧条目,压缩条目不会);高性能注意力 kernel 要求块对齐。它的设计是:
- 压缩条目放进块 cache。每个块覆盖 lcm(4, 128) = 128 个原始 token 的整数倍。一个 128 token 的块里,CSA 层存 32 个条目(外加对应的索引器 key),HCA 层存 1 个(由压缩比推算)。稀疏注意力 kernel 经过协同设计,这类大小的块都能全速运行。
- 还在变化的部分放进状态 cache。每个请求分到一个固定大小的槽位,存放窗口里最近 128 个 KV 条目,以及“未压缩的尾部”:已经到达、但还凑不满一个压缩块的 token。论文把这个槽位当作状态空间模型的状态来对待,它只取决于当前位置;系统预先分配一个固定的槽位池。
沿用 §4.3 那个 1,000 token 的 V4-Pro 提示词(按配置推算)。块缓存收下压缩条目:每个 CSA 层 250 个,每个 HCA 层 7 个。状态槽存放仍在变化的部分:每层的窗口(第 872 到第 999 个 token)、每个 HCA 层待压缩的 104 个 token,以及每个 CSA 层最后一个 4 token 的块,供重叠压缩器生成下一个条目时复用。
同样的拆分也决定了磁盘前缀缓存的设计。它让共享长前缀的请求跳过预填充:
- 压缩条目(CSA 和 HCA)全部写入磁盘。命中时复用到最后一个完整的压缩块为止;不完整的尾块重新计算。
- 窗口条目每层都有且不压缩,如果为每个 token 都存,体积约为压缩条目的 8 倍(论文数字)。论文给了三种策略(SWA 即滑动窗口注意力):Full SWA Caching(全部存下,不必重算,但对 SSD 是写密集的访问模式);Periodic Checkpointing(每 $p$ 个 token 存一次最近 128 个窗口条目,命中后从最近的检查点重算);Zero SWA Caching(一个都不存,全部重算)。
Zero SWA Caching 之所以可行,是因为某一层里一个 token 的窗口条目,只依赖前一层最近 128 个 token 的窗口条目。在已缓存的压缩条目之上重算最后 $n_\text{win} \cdot L$ 个 token,就能恢复每一层的窗口。V4-Pro 是 128 × 61 = 7,808 个 token,V4-Flash 是 128 × 43 = 5,504 个(按配置推算);不论共享前缀多长,这个代价都是固定的。
实现细节
- 待压缩的尾部存在每个压缩器的 FP32 缓冲区
kv_state和score_state里(§4.3),大小与上下文长度无关:CSA 主压缩器是[·, 8, 1024],它的 128 维索引器压缩器是[·, 8, 256],HCA 压缩器是[·, 128, 512](inference/model.py第 303–304 行)。 - 我们核对了“8 倍”这个数,假设为每个 token 都写入窗口条目:每个 token,V4-Pro 的窗口占 61 × 576 = 35,136 字节,压缩主条目占 30 × 144 + 31 × 4.5 ≈ 4,460 字节,比例约 7.9(按配置推算;把索引器 key 算进去约为 7.1)。
那么,模型实际能把百万 token 用得多好?模型卡的推理模式对比表(Max 是最高推理档位,见 §11.4)里有两项 1M token 测试:MRCR 1M 衡量上下文内检索;CorpusQA 1M 被论文称为“与真实场景相似”。
| 1M token 基准(模型卡) | V4-Flash Max | V4-Pro Max |
|---|---|---|
| MRCR 1M | 78.7 | 83.5 |
| CorpusQA 1M | 60.5 | 62.0 |
在模型卡与前沿模型的对比表里,Gemini-3.1-Pro High 在这两项上分别是 76.3 和 53.8,Opus-4.6 Max 是 92.9 和 71.7。这与论文对 MRCR 的总结一致:领先 Gemini-3.1-Pro,落后 Opus-4.6;CorpusQA 上论文只说 Pro 优于 Gemini-3.1-Pro。
10. 训练:数据、Muon、稳定性与 FP4 QAT
一个万亿参数、能读百万 token 的模型,怎样才能稳稳地训出来?报告的答案分四部分:更多、更长的数据;换一个优化器(Muon);两个防止 loss 尖峰的技巧;最后一个阶段,让模型学会和 4 bit 专家共处。
10.1 数据与预训练日程
预训练语料在 DeepSeek-V3 的数据基础上构建,总量“超过 32T token”:V4-Flash 训练了 32T,V4-Pro 训练了 33T。报告列出的变化有:
- 更干净的网页数据。过滤掉批量自动生成和模板化的页面,降低在机器生成文本上训练导致模型崩溃的风险。
- 中期训练加入智能体数据,用来增强代码能力;数学和代码仍是核心组成部分。
- 更大的多语种语料,目标是覆盖不同文化里的长尾知识。
- 长文档,优先收录科研论文、技术报告等材料。
- 同一套分词器。词表仍是 128K(config 中为 129,280 项),新增了少量用于构造上下文的特殊 token。token 切分和 Fill-in-Middle(FIM)策略沿用 V3。
- 打包 + 样本级注意力掩码。把来自不同来源的文档打包进同一条训练序列,减少截断;与 V3 不同的是,注意力按样本做掩码。
直白地说:如果一条 4K 的训练序列里先是 3,000 token 的论文,后面跟着 1,096 token 的代码文件,样本级掩码会阻止代码 token 去关注论文。我们的理解是,这对 V4 比对 V3 更重要,因为每个被打包的文档还要各自压缩;论文在上下文并行一节里提到,每条打包序列独立压缩,凑不满一个块的剩余 token 会被丢弃。
两个模型随后按同样的日程训练,只是数字不同:
| 预训练设置(论文 §4.2.2) | V4-Flash | V4-Pro |
|---|---|---|
| token 数 | 32T | 33T |
| batch 大小(token) | 逐步增大到 75.5M,之后保持 | 逐步增大,最大 94.4M |
| 学习率 | 2,000 步预热,2.7 × 10⁻⁴,临近结束时余弦衰减到 2.7 × 10⁻⁵ | 日程“基本相同”,2.0 × 10⁻⁴ 到 2.0 × 10⁻⁵ |
| 序列长度 | 4K → 16K → 64K → 1M | 4K → 16K → 64K → 1M |
| 稠密注意力预热 | 前 1T token | “更长的阶段”(未给具体数字) |
| 稀疏注意力 | 在 64K 时引入,之前先短暂预热闪电索引器 | 相同的两阶段方法 |
| MoE 负载均衡 | 偏置更新速度 0.001;序列级均衡损失权重 0.0001 | 相同 |
| MTP 损失权重 | 0.3,学习率开始衰减后改为 0.1 | 相同 |
先稠密、后稀疏的做法与 DeepSeek-V3.2 引入 DSA 的方式一致,GLM-5.3 那篇文章的 §5.4 有详细介绍。V4 报告只说在开启稀疏之前先短暂预热索引器,没有写索引器的训练损失,我们也不去猜。
10.2 Muon 与混合 Newton-Schulz
Muon 是专门针对权重矩阵的优化器。Adam 一类优化器对梯度里的每个数单独缩放;Muon 则把一个矩阵的更新当作整体,换成离它最近的正交矩阵,让更新的每个方向都走同样的步长。V4 的大部分权重都用 Muon,理由是收敛更快、训练更稳。(GLM-5.3 那篇文章的 §3.6 讨论过 GLM-5 中 Muon 与注意力设计的相互影响。)
谁用哪个优化器。AdamW 保留给四类参数:embedding、预测头、mHC 的静态偏置和门控因子,以及所有 RMSNorm 权重。其余参数,包括每个专家矩阵和每个注意力投影,全部用 Muon 更新。
论文的算法 1 对每个“逻辑上独立”的权重 $W \in \mathbb{R}^{n \times m}$(每个专家各算一组矩阵)执行:
- 取梯度 $G_t$,更新动量缓冲:$M_t = \mu M_{t-1} + G_t$,$\mu$ = 0.95。
- 对 Nesterov 式的组合做正交化:$O’_t = \text{HybridNewtonSchulz}(\mu M_t + G_t)$。
- 重新缩放:$O_t = O’_t \cdot \sqrt{\max(n,m)} \cdot \gamma$,使更新的 RMS 为 0.18。
- 权重衰减并更新:$W_t = W_{t-1}(1 - \eta\lambda) - \eta O_t$,$\lambda$ = 0.1。
为什么乘 $\sqrt{\max(n,m)}$?正交化后的 $n \times m$ 矩阵所有奇异值都是 1,换算成每个元素的 RMS 是 $1/\sqrt{\max(n,m)}$。乘以 $\sqrt{\max(n,m)}$ 后变成 1,再乘 $\gamma$ 就是 0.18(这是我们对论文所述目标的推导)。以 V4-Pro 的 query 降维投影为例,它是 7,168 × 1,536 的矩阵,系数为 $\sqrt{7{,}168} \approx 84.7$。RMS 对齐之后,Muon 就能直接沿用 AdamW 的学习率。
精确正交化需要做奇异值分解(SVD),每一步对每个矩阵都做太慢。Newton-Schulz 迭代只用矩阵乘法来近似。先归一化 $M_0 = M / \lVert M \rVert_F$,保证奇异值都不超过 1,然后重复
\[M_k = a\,M_{k-1} + b\,(M_{k-1}M_{k-1}^{\top})\,M_{k-1} + c\,(M_{k-1}M_{k-1}^{\top})^{2}\,M_{k-1}.\]每一步相当于对每个奇异值 $\sigma$ 套用多项式 $f(\sigma) = a\sigma + b\sigma^3 + c\sigma^5$,奇异向量不变。V4 的“混合”版本分两阶段跑 10 步:
| 步数 | $(a, b, c)$ | 作用 |
|---|---|---|
| 1–8 | (3.4445, −4.7750, 2.0315) | 把小奇异值快速推向 1 |
| 9–10 | (2, −1.5, 0.5) | 把它们精确地稳定在 1 |
举个小例子(我们对标量多项式的模拟):从奇异值 0.01 出发,前 8 步依次变成 0.034、0.118、0.40、1.09,之后在约 0.70 到 1.12 之间来回跳,最后停在 1.086。最后两步得到 1.006,然后是 1.000。第二个多项式满足 $f(1) = 1$,斜率 $f’(1) = 2 - 4.5 + 2.5 = 0$,所以能把值钉在 1 上;第一个多项式从远处出发收敛很快,却始终停不稳。
不用 QK-Clip。§3.2 提过,V4 用 Muon 时没有配 QK-Clip。它的注意力直接对 query 和 KV 条目做 RMSNorm,论文说这本身就能防止注意力 logit 爆炸。
超参数与基础设施
- 取值(论文 §4.2.2):AdamW $\beta_1$ = 0.9,$\beta_2$ = 0.95,$\varepsilon$ = 10⁻²⁰,权重衰减 0.1。Muon 动量 0.95,权重衰减 0.1,更新 RMS 缩放到 0.18。Flash 和 Pro 相同。(报告 §4.2.2 列出的 AdamW 模块里没有 mHC;报告 §2.4 则包含了 mHC 的静态偏置和门控因子。)
- 渊源:对 Muon 参数做权重衰减、Nesterov 技巧和 RMS 重缩放都沿用 Liu et al.(2025,Moonlight);两阶段 Newton-Schulz 是 V4 的改动。
- Muon 遇上 ZeRO(报告 §3.4.1)。Muon 需要完整的矩阵,而 ZeRO 会把优化器状态切分。对稠密权重,V4 限制 ZeRO 组的大小,用背包算法把整块矩阵分配到各 rank(在他们的设置中,每个 rank 管理不超过五个矩阵,把各 bucket 填充到相同大小通常只多花不到 10% 的显存);数据并行规模超过这个上限时,多出来的数据并行组冗余地计算 Muon 更新。专家矩阵各自独立优化:把所有层所有专家的 down 矩阵、再把 up 和 gate 矩阵依次展平,并填充到不切开任何一个矩阵。
- 形状相同的参数会合并,让 Newton-Schulz 批量执行;Newton-Schulz 在 BF16 矩阵乘法下是稳定的。
- 数据并行同步时,MoE 梯度用随机舍入量化到 BF16,通信量减半;reduce-scatter 换成 all-to-all 加本地 FP32 求和。
10.3 稳定性:预判式路由与 SwiGLU 截断
V4 的训练过程中出现过 loss 尖峰,回滚到早先的检查点只能把下一次尖峰往后推。团队发现尖峰总是和 MoE 层里的异常值有关,而路由机制本身似乎会放大这些异常值。于是他们从两头下手:切断经过路由器的反馈回路,并直接压住异常值。论文坦言,这两招为什么有效,“全面的理论理解”仍是一个开放问题。
预判式路由(Anticipatory Routing)。在第 $t$ 步,网络用当前参数 $\theta_t$ 计算特征,但路由索引(每个 token 去哪些专家)来自更早的参数 $\theta_{t-\Delta t}$。具体做法:
- 在第 $t - \Delta t$ 步,训练器提前取出第 $t$ 步的数据,多跑一次前向,算出并缓存它的路由索引。
- 到第 $t$ 步,MoE 层直接用缓存的索引,不再用当前的路由器路由。
- 这次额外的前向和专家并行通信重叠执行,开启时墙钟时间开销控制在约 20%。
- 这个模式不常开。自动检测器发现 loss 尖峰时先短暂回滚,开启预判式路由运行一段时间,再切回正常训练。
我们的理解:如果路由器和专家在同一步里一起更新,一个小异常值可能改变路由,让这个专家收到更多产生异常值的 token,异常值进一步变大。用略微滞后的路由决策,就切断了这个循环。由于只在尖峰前后开启,论文称“整体额外训练开销可以忽略”。
SwiGLU 截断。每个专家计算 $\text{SiLU}(\text{gate}) \odot \text{up}$。两个模型的整个训练过程中,线性部分(“up”)都被截断在 $[-10, 10]$,gate 的上限设为 10,也就是 config 里的 swiglu_limit 10.0。参考代码在每个专家里都这样做,路由专家和共享专家都不例外:
up = torch.clamp(up, min=-self.swiglu_limit, max=self.swiglu_limit)
gate = torch.clamp(gate, max=self.swiglu_limit)
x = F.silu(gate) * up
两道截断之后,乘积的每个元素都落在大约 ±100 以内,推算过程见 §8.4。论文称截断“有效消除了异常值”,而且不损失效果。
10.4 FP4 量化感知训练
发布的模型把路由专家存成 4 bit 浮点(§8.5)。用更高精度训练的模型,权重被这么粗地舍入后会损失一些精度。所以 V4 加了 QAT:后训练阶段,前向计算就直接用舍入后的权重,让模型学会适应。QAT 只在后训练阶段进行;论文没有描述预训练中的 FP4 QAT。
这里的 FP4 指 MXFP4,一种分块格式:数值用 E2M1 表示(§8.5),每连续 1 × 32 个值共享一个缩放因子。V4 把它用在两处:
- MoE 专家权重,这是 GPU 显存占用的主要来源之一。
- CSA 闪电索引器的 query-key 路径,它的激活全程以 FP4 缓存、加载和相乘。同一个 QAT 阶段里,索引分数也从 FP32 改存为 BF16;论文说这让 top-k 选择器提速 2 倍,被选中 KV 条目的召回率保持在 99.7%。
专家权重的做法完全复用现有的 FP8 训练框架:
- 优化器保存 FP32 主权重。
- 前向时先量化到 FP4,再反量化到 FP8(E4M3),用 FP8 计算。
- 反向时对同样的 FP8 权重求梯度,直接传回 FP32 主权重,相当于直通估计器(STE)。不需要重新量化转置后的权重。
- 强化学习的 rollout 和推理都不做模拟,直接跑原生 FP4 权重,保证采样行为和线上部署完全一致。索引器的 QK 路径也同样处理。
第 2 步听上去有损,论文却说它是精确的。FP8 E4M3 比 FP4 E2M1 多 2 位指数,只要同一个 128 × 128 FP8 块内各个 1 × 32 FP4 子块的缩放因子差距不超过某个比例,FP8 的指数就能吸收这些更细的缩放,每个 FP4 值都能被精确表示。团队通过实验确认现有权重满足这个条件。直白地说(我们的示例):如果同一 FP8 块里两段 32 个值的缩放因子分别是 1 和 1/8,第二段里的 1.5 就变成 0.1875,E4M3 能精确存下;只有同一块内缩放因子相差极大时,才会超出 FP8 的范围。
§8.5 说过,收益在显存而不在算力:在当前硬件上,FP4 × FP8 的峰值 FLOPs 与 FP8 × FP8 相同。
实现细节
- 参考推理代码:路由专家是
float4_e2m1fn_x2张量,每字节两个 FP4 值(inference/model.py第 623 行);共享专家不是 FP4。索引器一侧,压缩后的索引器 key 和索引器 query 都先做 Hadamard 旋转,再用块大小 32 的fp4_act_quant(第 368–370 行和第 414–416 行)。 - 开源训练实现 Miles(§13)有 FP8 激活 QAT(
fp8_simulate_qat,反向直通),但我们没有在其中找到 FP4 专家权重 QAT;它的索引器压缩器模拟的是块大小 128 的 FP8,而参考代码用的是块大小 32 的 FP4。 - 论文的后训练也对教师模型和参考模型做 QAT,让蒸馏流水线里的每个模型都适应同样的舍入。
10.5 系统一览
报告用了很长一章讲基础设施。大部分超出了本文的范围,但有五项能说明上面的架构为什么训得起来。(融合 MoE kernel MegaMoE 放在 §8 和 MoE 层一起讲。)
| 组件(论文章节) | 问题 | V4 的做法 |
|---|---|---|
| TileLang kernel(§3.2) | 数百个细碎的 PyTorch 算子,每个都有 CPU 启动开销 | 用 TileLang 语言写融合 kernel;主机端代码生成把每次调用的 CPU 端校验从几十到几百微秒降到 1 μs 以内;SMT 求解器(Z3)帮编译器分析整数索引运算,编译只多花几秒;默认关闭 fast-math,保证逐位可复现 |
| 批不变、确定性 kernel(§3.3) | 结果随 batch 大小或线程时序变化,训练和推理就会对不上 | 解码注意力不做 split-KV,改用累加顺序相同的单 SM 和多 SM 两个 kernel;端到端用 DeepGEMM 替换 cuBLAS,大多数场景放弃 split-k;稀疏注意力和 MoE 的反向改用确定性实现、不用原子加;mHC 的小矩阵乘法用确定性的 split-k 归约 |
| mHC 实现(§3.4.2) | 四条残差流增加了激活显存和流水线阶段间的通信 | 融合 kernel;选择性重算(重算大部分层间隐状态和全部归一化输入,不重算计算密集的操作);调整 DualPipe 1F1B 重叠方案,把 mHC 的墙钟开销压到重叠后 1F1B 流水线阶段的 6.7% |
| 压缩注意力的上下文并行(§3.4.3) | 一个压缩块可能跨两张 GPU,打包序列压缩后长度不一 | 两阶段:每个 rank 把最后 $m$ 个未压缩 KV 条目发给下一个 rank,后者压缩成固定的 $s/m + 1$ 个条目(含填充);再用 all-gather 加融合的选择-填充算子拼出全部压缩条目 |
| 张量级激活检查点(§3.4.4) | 模块级检查点粒度太粗,手写一层的反向又丢掉了自动微分 | 开发者标注单个张量;TorchFX 追踪计算图,为每个张量找出在梯度需要它之前重算所需的最小子图,与手写重算相比没有额外开销 |
我们的理解:V4 的各种设计(top-k 选择、带回看的压缩、四条残差流)都会制造微小数值差异或不规则形状,随时可能破坏可复现性,所以基础设施格外依赖确定性、能感知形状的 kernel。
11. 后训练与推理模式
预训练好的 V4 基座模型,怎样变成带三档思考强度的对话模型?DeepSeek 先按领域和推理预算训练一批独立的专家模型,再把它们全部蒸馏进同一个学生模型,学生在自己生成的样本上学习。第二步取代了 V3.2 用过的混合强化学习阶段。
11.1 先练专家,再合成一个学生
技术报告说,后训练流程“大体沿用”DeepSeek-V3.2,只换了一个环节。顺序如下:
- 专家模型。 每个领域专家先做监督微调(SFT),再用该领域的提示词和奖励信号做强化学习(RL)。RL 算法是 GRPO(Group Relative Policy Optimization),超参数与 DeepSeek 此前的工作“高度一致”。
- 按推理强度分专家。 推理预算也是一个专家维度。DeepSeek 用不同的 RL 配置训练不同的专家,每个配置有自己的长度惩罚和上下文窗口,于是它们学会以不同的长度思考(§11.4)。
- 合成一个学生。 多教师在线策略蒸馏(On-Policy Distillation,OPD)把“十个以上”的教师合进最终模型。报告说,混合 RL 阶段被 OPD“完全取代”。
裁判就是演员本身。 容易验证的任务(数学答案、单元测试)用规则验证器打分。难以验证的任务,V4 不再用常见的标量奖励模型:DeepSeek 编写带评分细则(rubric)的 RL 数据,用生成式奖励模型(Generative Reward Model,GRM)给轨迹打分,GRM 会把判断过程写出来。报告进一步对 GRM 本身做 RL:“actor 网络天然就是 GRM”,评判能力和生成能力一起优化。报告称,这样做“只需要少量多样的人工标注”。
11.2 在线策略蒸馏,用完整词表
OPD 里,轨迹由学生自己写,与任务相关的教师给其中每个 token 打分。设有 $N$ 个专家教师 $\pi_{E_1}, \dots, \pi_{E_N}$,报告的目标函数(式 29)是
\[\mathcal{L}_{\text{OPD}}(\theta) = \sum_{i=1}^{N} w_i \, D_{\text{KL}}\!\left(\pi_\theta \,\Vert\, \pi_{E_i}\right)\]其中 $\pi_\theta$ 是学生,$w_i$ 是每个教师的权重(“通常由该专家的相对重要性决定”),KL 的方向是从学生到教师,即反向 KL。反向 KL 是在学生自己的分布上求平均,所以训练文本必须由学生生成,这就是“在线策略”的含义。直白地说:学生自己解一道数学题,数学教师逐个 token 告诉它,下一个 token 的整个分布本该长什么样。
报告的第二个选择是 KL 怎么算。以往的 OPD 工作通常只保留实际采样到的那个 token,把 $\log \pi_{E_i}(y_t) - \log \pi_\theta(y_t)$ 当作逐 token 的优势值塞进 RL 损失。DeepSeek 认为这种估计“方差很大”,“经常导致训练不稳定”,因此 V4 在每个位置上对完整词表计算 KL。
用一个玩具例子看区别。词表只有 4 个 token,学生分布 $p = (0.5, 0.3, 0.1, 0.1)$,教师分布 $q = (0.7, 0.1, 0.1, 0.1)$:
| 计算方式 | 数值(nats) |
|---|---|
| 完整词表的反向 KL,$\sum_v p_v \ln (p_v / q_v)$ | $0.5 \ln\frac{5}{7} + 0.3 \ln 3 \approx 0.161$ |
| 单样本估计:学生采样到 token 1 | $\ln\frac{0.5}{0.7} \approx -0.336$ |
| 单样本估计:学生采样到 token 2 | $\ln\frac{0.3}{0.1} \approx +1.099$ |
按学生采样各 token 的概率加权,单样本估计的平均值同样是 0.161(token 3、4 贡献为 0)。但单次估计可能是负数,也可能大出约 7 倍。完整词表的损失在每个位置都给出精确值,代价是内存:真实词表有 129,280 个条目,每个 token、每个相关教师都要算一遍。
DeepSeek 怎样让完整词表 OPD 跑得起
报告 §5.2 列出了支撑十个以上教师 OPD 的基础设施,每个教师“可能有上万亿参数”:
- 教师放在 GPU 之外。 所有教师权重存放在集中式分布存储中,前向时按需加载,采用类似 ZeRO 的分片。
- 缓存隐藏状态,而不是 logits。 词表超过 10 万,为每个教师落盘 logits 也“代价过高”。DeepSeek 只缓存每个教师最后一层的隐藏状态,训练时再经该教师的预测头(prediction head)重算 logits。按 V4-Pro 配置推算,隐藏状态有 7,168 个数,logits 有 129,280 个,每个 token 要存的数据少约 18 倍。
- 一次只放一个教师头。 训练样本按教师编号排序,每个教师头在一个 mini-batch 里只加载一次,设备上最多同时有一个。加载和卸载都在后台异步进行。
- 用专门 kernel 算精确 KL。 教师与学生之间的 KL 由一个专用的 TileLang kernel 计算。
玩具例子:上面 4 个 token 的数字是我们为说明方差问题而选的,不是报告中的数据。
11.3 不怕抢占的 rollout
RL 和 OPD 都需要学生生成很长的 rollout。DeepSeek 的集群里,任何任务都可能随时被抢占,硬件也会出故障。报告中的 rollout 服务为每个请求维护一份逐 token 的预写日志(write-ahead log,WAL):每生成一个新 token,立刻追加到日志里。
- 被抢占时,引擎暂停,保存未完成请求的 KV cache;恢复后,凭 WAL 和保存的 cache 接着解码。
- 遇到致命硬件故障时,用日志里的 token 重新预填充,重建 KV cache,再继续生成。
为什么不干脆从头重新生成未完成的请求?报告说这样做“在数学上是错的”,因为会引入长度偏差。短回答更可能在中断前写完,重启被打断的请求,相当于用新样本替换掉长回答,最终完成的样本就偏向短回答。直白地说:一个 2,000 token 的回答和一个 40,000 token 的回答同时开始,第 10,000 个 token 时发生抢占,被丢掉的只有长的那个。
如果推理栈是批次不变(batch-invariant)且确定性的,也可以改用相同的采样种子重新生成被打断的请求,但那要把整个解码重跑一遍;WAL 省掉了这笔开销。
针对百万 token 级的 RL,报告还把 rollout 数据拆成两部分:轻量的元数据整体加载,用于全局打乱和打包;沉重的逐 token 字段走共享内存加载器,按 mini-batch 用完即释放。
11.4 三种推理模式
V4-Pro 和 V4-Flash 都提供三种模式,来自 §11.1 中按推理强度训练的专家。报告表 2 和模型卡这样描述:
| 模式 | 特点 | 回复格式 |
|---|---|---|
| Non-think | “快速、直觉式”回答,适合日常任务 | </think> 摘要 |
| Think High | “有意识的逻辑分析,较慢但更准确” | <think> 思考 </think> 摘要 |
| Think Max | “把推理推到极限” | 特殊系统提示词 + <think> 思考 </think> 摘要 |
推理时,Think Max 与 Think High 的区别,是系统提示词开头多了一段指令(报告表 3),第一句是“Reasoning Effort: Absolute maximum with no shortcuts permitted.”(推理强度:绝对最大,不许走捷径。)其余部分要求模型拆解问题、对照边界情况反复检验逻辑,并写出每一个被否定的假设。预览版模型卡建议本地部署使用 temperature = 1.0, top_p = 1.0,Think Max 的上下文窗口至少 384K token。
后来的 -0731 和 -0813 模型卡(§12.2)换了参数名:reasoning_effort 取 low、high 或 max。它们建议智能体任务用 top_p = 0.95(其他任务用 1.0),high 和 max 的最大输出长度设为 384K token。模型卡没有给出新旧名称的对应关系;把 low 看作 Non-think 的继任者,是我们的理解。
三种模式各带来多少收益?下面摘录预览版模型卡的模式对比表(越高越好):
| 基准 | Flash Non-think | Flash High | Flash Max | Pro Non-think | Pro High | Pro Max |
|---|---|---|---|---|---|---|
| HLE | 8.1 | 29.4 | 34.8 | 7.7 | 34.5 | 37.7 |
| GPQA Diamond | 71.2 | 87.4 | 88.1 | 72.9 | 89.1 | 90.1 |
| LiveCodeBench | 55.2 | 88.4 | 91.6 | 56.8 | 89.8 | 93.5 |
| Codeforces(rating) | – | 2816 | 3052 | – | 2919 | 3206 |
| HMMT 2026 Feb | 40.8 | 91.9 | 94.8 | 31.7 | 94.0 | 95.2 |
| MRCR 1M | 37.5 | 76.9 | 78.7 | 44.7 | 83.3 | 83.5 |
| SimpleQA-Verified | 23.1 | 28.9 | 34.1 | 45.0 | 46.2 | 57.9 |
| BrowseComp | – | 53.5 | 73.2 | – | 80.4 | 83.4 |
有两个规律。第一,推理类任务的分数主要来自思考:Pro 的 HLE 从 7.7 升到 34.5,再到 37.7。第二,正如模型卡所说,Flash 的 Max 档在推理上大致追平 Pro 的 High 档(HLE 34.8 对 34.5,LiveCodeBench 91.6 对 89.8,Codeforces 3052 对 2919),知识类任务却不行:Flash-Max 的 SimpleQA-Verified(34.1)甚至低于 Pro 的 Non-think(45.0)。报告把知识类差距归因于参数量(“参数越多,预训练中能记住的知识越多”);推理能力则跟思考预算走。
11.5 工具调用、保留推理与快捷指令
后训练模型还带来三项接口变化。它们不涉及架构,但都会改变应用发给模型什么、拿回什么。
DSML 工具调用。 V4 引入专用的 DSML 特殊 token(即下面代码块中的标签前缀)和 XML 风格的工具调用块(报告表 4)。字符串参数原样传入,标 string="true";数字、布尔值、数组和对象用 JSON 传入,标 string="false":
<|DSML|tool_calls>
<|DSML|invoke name="get_weather">
<|DSML|parameter name="city" string="true">Hangzhou</|DSML|parameter>
<|DSML|parameter name="days" string="false">3</|DSML|parameter>
</|DSML|invoke>
</|DSML|tool_calls>
工具名和参数是我们举的例子,标签取自报告。DeepSeek 称 XML 格式“有效缓解转义失败,减少工具调用错误”。直白地说:作为字符串传入的一段代码,不必再经受 JSON 对每个引号和换行的转义。
跨用户轮次保留推理。 V3.2 在多轮工具结果之间保留推理内容,但新的用户消息一到就丢弃。V4 在工具调用场景中整段对话都保留推理,跨越用户轮次也不丢;普通聊天场景仍然丢弃。报告提醒,用用户消息模拟工具交互的框架(报告点名 Terminus)可能触发不了工具调用路径,这类框架仍建议用 non-think 模式。
快捷指令(Quick Instruction)token。 聊天机器人回答前要先跑几个小任务:要不要联网搜索?搜索词是什么?问题属于哪个领域?以往这些任务交给一个单独的小模型,它得把提示词重新预填充一遍。V4 直接在现有序列后追加专用特殊 token,复用已经算好的 KV cache。其中一些任务可以并行执行,报告称这能“显著降低”首 token 延迟(TTFT)。七个 token 及其位置如下(报告表 5):
<|action|>          联网搜索,还是直接回答?        ...<|User|>{prompt}<|Assistant|><think><|action|>
<|title|>           生成对话标题                    ...<|Assistant|>{response}<|end_of_sentence|><|title|>
<|query|>           为提示词生成搜索词              ...<|User|>{prompt}<|query|>
<|authority|>       对来源权威性的要求              ...<|User|>{prompt}<|authority|>
<|domain|>          提示词所属领域                  ...<|User|>{prompt}<|domain|>
<|extracted_url|>   抓取阅读每个 URL?(成对)      ...<|User|>{prompt}<|extracted_url|>{url}<|read_url|>
<|read_url|>        (闭合这一对)
实现细节
- 模型卡不附 Jinja 对话模板,而是提供
encoding文件夹,内含encode_messages(messages, thinking_mode="thinking")和parse_message_from_completion_text。消息格式兼容 OpenAI,推理内容放在reasoning_content字段。-0731 和 -0813 模型卡在同一调用里加了reasoning_effort="max"。 - 工具调用的系统提示词还要求:思考模式下,完整推理必须先写在
<think>…</think>里,然后才能调用工具。
11.6 V4-Pro-Max 的位置
预览版模型卡把 Think Max 档的 V4-Pro 与闭源和开源前沿模型做了对比。摘录如下,加粗为完整表格中每行的最高分:
| 基准 | Opus-4.6 Max | GPT-5.4 xHigh | Gemini-3.1-Pro High | DS-V4-Pro Max |
|---|---|---|---|---|
| LiveCodeBench | 88.8 | – | 91.7 | 93.5 |
| Codeforces(rating) | – | 3168 | 3052 | 3206 |
| Apex Shortlist | 85.9 | 78.1 | 89.1 | 90.2 |
| GPQA Diamond | 91.3 | 93.0 | 94.3 | 90.1 |
| HLE | 40.0 | 39.8 | 44.4 | 37.7 |
| SimpleQA-Verified | 46.2 | 45.3 | 75.6 | 57.9 |
| MRCR 1M | 92.9 | – | 76.3 | 83.5 |
| Terminal Bench 2.0 | 65.4 | 75.1 | 68.5 | 67.9 |
| SWE Verified | 80.8 | – | 80.6 | 80.6 |
完整表格还包括 Kimi K2.6 和 GLM-5.1;在整张表里,V4-Pro-Max 只在 LiveCodeBench、Codeforces 和 Apex Shortlist 上拿到最高分。
以上都是预览版的数字。后续版本的智能体分数变化很大,而且换了更新的基准版本,这正是 §12 的内容。
12. 预览版之后
最初发布的 V4 权重标注为预览版。之后的仓库先加上投机解码模块,再发布智能体能力大幅提升的 Flash 和 Pro 正式版,然后是第一个视觉模型。它们都保留 V4 的骨干网络。最新的 DeepSeek-V4.1-Flash 则是另一个模型,把 KV 压缩又往前推了一步。
12.1 DSpark:同一个 checkpoint,外挂一个草稿模块
逐个 token 解码时,大模型主要受限于显存带宽。投机解码(speculative decoding)让一个小而便宜的模块先往后猜几个 token,大模型用一次前向检查整段猜测。猜对的部分保留下来,于是大模型的一步可以产出好几个 token。
DeepSeek-V4-Pro-DSpark 的模型卡说得很明确:它“不是新模型,而是同一个 checkpoint 外挂了一个投机解码模块”。方法细节指向 DeepSeek 的 DeepSpec 仓库。配置只多了四个键和两个压缩比为 0 的条目,其他不变:
| 配置键 | V4-Pro(DSpark、-0813) | V4-Flash(-0731、Vision-Exp) |
|---|---|---|
dspark_block_size |
5 | 5 |
dspark_target_layer_ids |
[58, 59, 60] | [40, 41, 42] |
dspark_markov_rank |
512 | 256 |
dspark_noise_token_id |
128799 | 128799 |
compress_ratios 末尾的纯窗口(压缩比 0)条目 |
3 个(61 层共 64 项) | 3 个(43 层共 46 项) |
目标层是各模型主干的最后三层。预览版配置末尾只有一个压缩比为 0 的条目,对应 MTP 块;DSpark 配置有三个。我们的理解是:草稿模块由三个纯窗口块组成,读取最后三层的隐藏状态。
V4 报告没有介绍 DSpark。V4.1-Flash 报告描述了它自己的 DSpark 草稿模块;我们假设 V4 的 DSpark 结构相同(我们的理解):三个 Transformer 块,窗口 128 个 token;一次前向并行算出 5 个草稿位置的基础 logits;一个轻量的“Markov 头”建模草稿 token 之间的依赖;一个置信度头预测每个前缀被接受的概率。
调度器把这些估计与实测的引擎吞吐曲线结合,为每个请求决定验证多少个 token。报告还说,DSpark 在骨干预训练之后单独训练,训练时冻结骨干;它不仅加速推理服务,也加速 RL 和 OPD 的 rollout。
模型卡中的部署参数
- vLLM(Pro-DSpark、Flash-0731、Pro-0813):
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'。模型卡给出的示例运行在“单个 4×GB300 节点”上,参数为--kv-cache-dtype fp8 --block-size 256 --data-parallel-size 4 --enable-expert-parallel --moe-backend deep_gemm_mega_moe --attention-config '{"use_fp4_indexer_cache": true}'。 - vLLM(Vision-Exp):
"num_speculative_tokens":3、"draft_sample_method":"probabilistic"、"enable_adaptive_verification":true。 - SGLang:
--speculative-algorithm DSPARK,不需要单独的草稿模型路径,因为“目标模型和草稿模型的权重来自同一个 checkpoint”。 - 未解之处:配置里 block size 是 5,vLLM 示例却投机 7 个或 3 个 token。来源没有解释两者的关系。
- Pro-DSpark、-0731、-0813 配置中的
num_nextn_predict_layers仍是 1,Vision-Exp 中是 3。来源没有解释这一差别。
12.2 Flash-0731 与 Pro-0813:正式版
DeepSeek-V4-Flash-0731 是“DeepSeek-V4-Flash 的正式版,取代预览版”,与“DeepSeek-V4-Flash-DSpark 的模型结构相同”。DeepSeek-V4-Pro-0813 对 Pro 做了同样的事:“基于 DeepSeek-V4-Pro(预览版)的模型结构,外挂 DSpark 投机解码模块”。按 DeepSeek 以往的命名习惯,后缀暗示 7 月 31 日和 8 月 13 日,但模型卡从未写明日期。两张卡仍引用 V4 报告,都没有介绍新的训练方法。
变化在于智能体能力。-0813 模型卡把四个模型放进同一张表(摘录):
| 基准 | Pro-0813 | Flash-0731 | Pro(预览版) | Flash(预览版) | Opus-4.8 |
|---|---|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 61.8 | 85.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 7.3 | 58.0 |
| NL2Repo | 61.5 | 54.2 | 38.5 | 39.4 | 69.7 |
| Cybergym | 83.3 | 76.7 | 52.7 | 38.7 | 78.3 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 49.7 | 76.2 |
| HLE(带工具) | 60.0 | 51.5 | 48.2 | 45.1 | 57.9 |
| AutomationBench (Public) | 31.8 | 25.1 | 12.8 | 10.8 | 27.2 |
直白地说:架构不变,DeepSWE 上 Flash 从 7.3 涨到 54.4,Pro 从 12.8 涨到 62.7。Flash-0731 的模型卡称,尽管激活参数少得多,它在所列基准上“超过 DeepSeek-V4-Pro(预览版)”。在这张表里,Pro-0813 在 Terminal Bench 2.1、DeepSWE、Cybergym、带工具的 HLE 和 AutomationBench 上超过 Opus-4.8,在 NL2Repo 和 Toolathlon-Verified 上落后(完整表中,不带工具的 HLE 和两个内部 DSBench 也落后)。
这些数字的注意事项
- 基准版本不同。 预览版模型卡(§11.6)用的是 Terminal Bench 2.0 和 Toolathlon,这里用的是 Terminal Bench 2.1 和 Toolathlon-Verified。两张表的数字不能互相比较。对比模型也换了(Opus-4.6 换成 Opus-4.8,GLM-5.1 换成 GLM-5.2)。
- 评测框架。 代码智能体任务使用“DeepSeek Harness 的 minimal 模式”(-0731 模型卡注明“即将发布”),
max推理强度,temperature = 1.0, top_p = 0.95。DSBench-FullStack 和 DSBench-Hard(模型卡中有,这里未摘录)是内部测试集。 - 一处矛盾。 Opus-4.8 的 Cybergym 分数在 -0731 模型卡中是 83.1,在 -0813 和 Vision-Exp 模型卡中是 78.3;在 -0813 卡里,83.1 是 Fable-5 的分数。既然两张卡都写 78.3,-0731 的数值多半是例外(我们的理解);仅凭现有来源无法定论。
- -0813 表格还列出了 GLM-5.2、Kimi K3 和 Fable-5(带 fallback);Kimi K3 在 Terminal Bench 2.1(88.3)、DeepSWE(67.5)和 Toolathlon-Verified(76.5)上领先 Pro-0813。
12.3 Vision-Exp:第一个多模态 V4
用模型卡的话说,DeepSeek-V4-Flash-Vision-Exp 是“DeepSeek-V4 家族第一个实验性多模态模型”。它在 V4-Flash 架构上加入视觉模块,并做了继续训练。文本骨干的配置在形状上与 V4-Flash 相同(43 层,隐藏维度 4,096,256 个路由专家),DSpark 相关键与 Flash-0731 一致。
模型卡把它与 Flash-0731 和 Opus-4.8 对比(摘录):
| 基准 | Vision-Exp | Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1(文本) | 83.9 | 82.7 | 85.0 |
| DeepSWE(文本) | 59.3 | 54.4 | 58.0 |
| Cybergym(文本) | 75.3 | 76.7 | 78.3 |
| ApexBench,Pass@1(多模态) | 36.5 | 26.2† | 39.4 |
| Chartography(多模态) | 64.3 | – | 65.0 |
| ZeroBench,Pass@5(多模态) | 35.0 | – | 34.0 |
† Flash-0731 忽略输入中的图像。文本智能体分数与 Flash-0731 接近,与模型卡的说法一致(“在纯文本智能体任务上保持相当的性能”)。仓库的推理代码提到 “DFlash attention”,我们的来源都没有定义这个术语。
12.4 V4.1-Flash:把 KV 压缩推得更远
DeepSeek-V4.1-Flash 是一个新的原生多模态模型,有自己的技术报告,标题是 “Pushing the Limits of KV Cache Compression”(把 KV cache 压缩推向极限)。它比 V4-Flash 更大,但报告称,在相同序列长度下,它的 KV cache 只有 V4-Flash 的四分之一左右。它值得单独写一篇;这里先给一屏的概览。
配置显示了它与 V4-Flash 的区别:
| 配置 | V4-Flash | V4.1-Flash |
|---|---|---|
| 层数 / 隐藏维度 | 43 / 4,096 | 40 / 5,120 |
| 路由专家(中间维度) | 256(2,048) | 384(2,304),仍为 top-6 + 1 个共享专家 |
q_lora_rank / 索引器头数 |
1,024 / 64 | 1,280 / 32 |
| 注意力核心 | 512 维 K = V,128 token 窗口 | 不变 |
compress_ratios(主干层) |
0, 0,然后 4 与 128 交替 | 0, 0,然后 2(第 2–19 层)、1(第 20–39 层) |
| 新增键 | — | kv_source_layer_ids [2, 8, 14, 20],index_source_layer_ids [2, 8, 14, 20, 24, 28, 32, 36] |
| 哈希路由 / MTP | 3 个哈希层 / 1 个 MTP 层 | 无哈希键 / 3(DSpark) |
按报告的说法,变化有这几处:
- CSA2 取代 CSA 和 HCA。 不再有 HCA。各层在深度方向上共享压缩 KV,每层属于三种静态模式之一。Full 层计算新的压缩 KV,从中投影出索引器的 key,并自己选出 top-k 条目,相当于 V4 的 CSA 层。Reindex 层复用最近的 KV 和索引器 key,但用自己的索引器 query 重新打分。Reuse 层同时复用 KV 和最近一次的 top-k 选择。每层仍然计算自己的 query 和自己的滑动窗口 KV。压缩器也去掉了 V4 的重叠窗口和可学习的绝对位置嵌入。
- 因果编码器-解码器(CED)。 40 层分成 20 层编码器和 20 层解码器。解码器的全局 KV 由编码器最后的隐藏状态投影得到(报告说灵感来自 YoCo),所以预填充只需跑下面 20 层就能建好它:激活参数是 8B 而不是 16B。解码器仍需要局部窗口 KV,它只重放提示词最后 128 个 token 来重建(“SWA Bounded Replay”,有界重放)。这样,存到 SSD 或主机内存里的持久 KV 降到 V4-Flash 的约 1/8。
- FP4 主 KV。 512 通道的 KV 条目以 FP4 存储(E2M1,每 16 个通道一个 E4M3 缩放因子),在 RoPE 之后量化,在后训练阶段用 QAT 训练。窗口 KV 仍是 FP8。
- Single-Pass mHC。 输入混合改用上一个块的系数,$X_{l+1} = B_l X_l + C_l\,F_l(A_{l-1} X_l)$,于是一个融合 kernel 就能完成整步。报告说激活访存因此减半,从 $(4n+4)d$ 降到 $(2n+2)d$;按 $n = 4$ 条流推算,每个 token 每个块从 $20d$ 降到 $10d$。报告称“性能损失可以忽略”。
- Engram 记忆。 两个哈希 n-gram 查表模块(阶数 2–4,8 个哈希头,每张表约 1,600 万行)位于第 1 层和第 14 层,承载 196B 的 Engram 参数。查表只取决于 token id,因此嵌入可以提前从主机内存预取。
890 字节从哪来?报告只给了总数,但我们可以按配置推算出来。只有 Full 层存 KV:编码器里 3 层,压缩比 2;解码器里 1 层,压缩比 1。假设每个条目包含一个 512 通道的 FP4 KV 向量(256 B 数值加 32 个单字节缩放因子,共 288 B)和一个 128 维的 FP4 索引器 key(64 B 加 4 B 缩放因子,共 68 B),即每条 356 B:
\[3 \times \frac{356\ \text{B}}{2} + 1 \times \frac{356\ \text{B}}{1} = 534 + 356 = 890\ \text{B per token}\]直白地说:解码器的 Full 层每个 token 存一条,编码器的三层每两个 token 存一条,其余 36 层不存任何全局 KV。按 §9 的 KV 模型推算,V4-Flash 在长上下文下每 token 约 3,450 B($21 \times 640/4 + 20 \times 576/128$),约是它的 3.9 倍,与报告的“约 1/4”吻合。
层分布及其他细节
- 各层模式(我们对配置的理解,与报告图 3 一致)。 第 0–1 层:只有窗口。编码器第 2–19 层(压缩比 2):第 2、8、14 层为 Full(
kv_source_layer_ids),其余为 Reuse。解码器第 20–39 层(压缩比 1,即不压缩):第 20 层为 Full,第 24、28、32、36 层为 Reindex(index_source_layer_ids中多出来的几层),其余为 Reuse。 - 890 B 的拆解是我们做的。 它假设索引器 key 像 V4 一样以 MXFP4 缓存(每 32 个值一个缩放因子),并且缩放因子字节计入总数。结果与报告的总数完全吻合,但报告本身没有给出拆解。V4-Flash 一侧沿用 §9 的做法,不计缩放因子字节;计入的话,比值变化不到 1%。
- 分层稀疏索引器(Hierarchical Sparse Indexer)。 在解码器中,第一个 Full 层(第 20 层)对所有可见位置打分,同时挑出候选块(
candidate_topk_blocks2,048 ×candidate_block_size8 = 16,384 个位置)。之后的 Reindex 层只给这些候选打分,开销不再随上下文增长。它是在后训练阶段加入的。 - Engram 规模(按配置推算)。 2 个模块 × 3 种 n-gram 阶数 × 8 个头 × 约 1,600 万行 × 256 维 ≈ 196.6B,与“196B”吻合。配置中两个模块的嵌入行数分别是 384,006,168 和 384,016,682。
- 训练。 45T 多模态 token;稀疏注意力在 64K 序列长度下从头训练,没有稠密预热(V4 一开始有稠密注意力预热);DSpark 在骨干之后训练。报告说后训练“没有算法创新”:与 V4 一样是 SFT、RL、OPD(§11),变化只在数据管线。
- 视觉。 从头训练的 DeepSeek-ViT(32 层,宽度 1,024,patch 14)经过 3×3 pixel-unshuffle 把视觉 token 减少 9 倍,再送入语言模型;每张图最多 1,024 个图像 token。
13. 开源实现(Miles)中的训练笔记
DeepSeek 的 V4 仓库只提供推理代码。开源 RL 框架 Miles(我们在之前的深度解析中介绍过)可以在 RL 循环里训练 V4-Flash 和 V4-Pro。它的代码是一个很有用的公开窗口:V4 的注意力对训练器提出了哪些要求,让训练和推理算出同样的结果又有多难。本节描述的都是 Miles,不是 DeepSeek 的内部训练栈。
13.1 两套实现,一份 checkpoint
Miles 有两种方式构建 V4,用 --dsv4-impl 选择:
megatron(默认) |
miles(插件) |
|
|---|---|---|
| 注意力变体 | Megatron 原生 dsv4_hybrid |
插件里的 DeepSeekV4Attention |
| kernel | cuDNN 或非融合实现 | TileLang |
| 张量并行 | 只支持 TP = 1 | 支持(也是唯一支持的一套) |
| 上下文并行 | 参数说明中未提及 | “稀疏上下文并行” |
两者读取同一份 Hugging Face checkpoint,但各自的 Megatron torch_dist checkpoint 不能混用。插件只替换注意力模块。mHC 残差流、带哈希路由的 MoE 和 MTP 都来自开启了超连接的 Megatron-core block spec,插件文件里没有它们的实现。
文档给出的配方是一次标准的 Miles RL 训练,而不是 DeepSeek 的配方:在数学数据集(dapo-math-17k)上跑 GRPO,Adam 优化器、恒定学习率 $10^{-6}$(不是 Muon),在转换后的 checkpoint 上以 BF16 训练,SGLang 以 FP8 做 rollout。路由门控和专家偏置校正都被冻结(“RL 期间禁止更新偏置”),并开启 rollout 路由重放(R3:训练时复用 SGLang 选出的专家,见我们 Miles 文章的 §4.1)。
实现细节
- 验证过的并行布局(Miles 文档,只计训练节点):V4-Flash 用 8 节点 × 8 张 H200,TP 8、PP 8、EP 8;或 8 节点 × 4 张 GB300(TP 8 / PP 4 / EP 8,或 TP 2 / PP 8 / CP 2 / EP 4)。V4-Pro 用 32 节点 × 8 张 H200,TP 8、PP 8、EP 32,Adam 状态卸载到 CPU,单个 SGLang 引擎至少横跨 32 张 GPU。
- Flash-0731。 Miles 注明正式版的路由专家是 MXFP4;启动脚本先把它们无损转换为分块 FP8,之后的流程与预览版 checkpoint 相同。
- 拒绝旧 checkpoint。 如果
torch_distcheckpoint 里还有self_attention.wq_a.,说明它“写于 DeepSeek-V4 权重改用 Megatron 命名之前”。 - 参数说明与代码略有出入。 该参数的说明把插件路径写成 BSHD 布局(batch、sequence、head、dim,不打包)、使用“miles 自己的超连接”;而代码支持 THD 打包(§13.4),注释也说两条路径的超连接都来自 Megatron。模型文档对层计划的描述也不够精确(例如 YaRN 用于“主注意力”、Pro 的计划有“60 项”);配置和 DeepSeek 参考代码(§9)只在压缩层使用 YaRN,Pro 的计划有 62 项。以配置为准。
13.2 用断言钉住架构
插件把 V4 的形状写死在代码里,大多是断言,正好构成一份前文架构的简明清单:
- 输出 LoRA 秩 1,024;头维度 512 = 448 维非 RoPE + 64 维 RoPE;滑动窗口 128;
- 压缩比属于 {4, 128},压缩器头维度属于 {128(索引器), 512(注意力)},压缩层 RoPE 基数 160,000;
- 只有压缩比 4 的层有索引器;压缩比 128 的层关注所有在因果上已完整的压缩条目;
- 最终的索引列表是窗口索引与压缩条目索引拼接而成,送进同一个稀疏注意力 kernel,每个头带一个 sink;
- 在分组输出投影之前,对注意力输出做逆 RoPE。
每一条都与参考推理代码一致,这是很好的交叉验证:两套代码都认定窗口与压缩条目共用一个 softmax(§3.4)、HCA 没有索引器(§6)、只有压缩比 4 才有重叠(§4.2)。
13.3 对齐 rollout 引擎
RL 中,推理引擎(这里是 SGLang)负责采样 token 并记录其对数概率,训练器再重算同样的对数概率来构造损失。两边的任何数值差异都会变成离策略(off-policy)噪声。我们的 Miles 文章详细讨论过这个问题;V4 插件展示了一种新注意力设计要为此付出什么:
- 压缩器投影按 SGLang 的精度算。 DeepSeek 参考代码在压缩器的两个投影之前把输入升到 FP32。Miles 改用
linear_bf16_fp32(BF16 输入和权重,FP32 输出),理由是它“与 SGLang 默认的 DeepSeek-V4 压缩器路径一致”,能“让 Megatron 的压缩器对数概率计算与 SGLang rollout 对齐”。压缩器的 RMSNorm 也用纯 PyTorch 实现、权重保持 FP32,同样是为了对齐 SGLang。 - 模拟 FP8 QAT。 开启 FP8 时,KV 的 448 个非 RoPE 维度和压缩器输出都要经过一次量化再反量化(FP8 E4M3,缩放因子为 2 的幂),梯度直通,使用 DeepSeek 的 TileKernels。
- 与参考代码的一处差异。 索引器的压缩器在 Hadamard 旋转之后,DeepSeek 参考代码量化到 FP4(block 32),Miles 模拟的是 FP8(block 128)。这里只是激活上的 QAT。我们在 Miles 中没有找到 FP4 专家权重 QAT,这一点不同于 DeepSeek 的后训练(§10.4)。
- 索引器重放。 除了 MoE 路由重放,还有一个可选参数
--use-rollout-indexer-replay:rollout 时记录索引器的 top-k 选择,训练前向时原样重放,让两边关注同一批压缩条目。默认关闭。
13.4 打包序列与上下文并行
压缩器按 4 个或 128 个 token 分组,由此带来两个只在训练时出现的问题。
打包序列。 Miles 把多个样本拼进一行长序列(THD 布局)。一个样本最后几个 token 可能凑不满一组。Miles 不给这些 token 生成压缩条目,它们只能通过滑动窗口被看到。代码注释说,这“与推理一致:解码时停在未满缓冲区里的 token 同样没有压缩条目”,也避免了填充(padding)带来的不一致。直白地说,看一个 10 token 的样本,压缩比 4:
| query 位置 | 可见的完整组 | 可用的压缩条目 |
|---|---|---|
| 2 | 无(token 0–3 尚未凑满) | 无,只有窗口 |
| 6 | token 0–3 | 条目 0 |
| 9 | token 0–3 和 4–7 | 条目 0 和 1;token 8–9 永远没有条目 |
代码中的规则是:位置 $t$ 的 query 只能使用满足 $g < \lfloor (t+1)/4 \rfloor$ 的条目 $g$。
上下文并行(CP)。 CP 把一条长序列切到多张 GPU 上,一个压缩组可能横跨两个 rank。Miles 在压缩前从上一个 rank 取回边界处的行。最近的一次提交还平衡了 CSA 索引器的因果计算量:每条序列切成 $2 \times$ CP 块,每个 rank 负责一个靠前的块和一个靠后的块,没有哪个 rank 只分到计算量最大的尾部。
V4 报告为压缩注意力设计了自己的两阶段 CP 方案(§10.5);Miles 用自己的办法解决同一个边界问题。
13.5 工作集中在哪里
V4 插件最近的提交记录,读起来就像训练这套架构的待办清单:
- 在连续的 CP rank 之间平衡 CSA 索引器(#3689);
- V4-Flash 的 THD 打包序列训练,支持 CP(#2038);
- 把 Megatron 原生实现作为可选项(#2706);
- 让 TP = 1 的稀疏注意力 kernel 装进 AMD MI35x 的共享内存(#1656),此前已在 MI355X 上跑通 FP8 RL 训练(#1607);
- 修复稀疏注意力反向 kernel 中的 NaN 梯度(#1642)。
Miles 的文档还描述了一套单独的 V4.1-Flash 配方(跨层 KV 共享、Engram);我们读到的代码中没有它的实现,所以本节不讨论 V4.1-Flash 的训练(模型本身见 §12.4)。
14. 悬而未决的问题
单凭技术报告、参考推理代码、配置和 Miles 代码,V4 还有哪些地方我们定不下来?本节把这些缺口集中列出,方便你分辨文中哪些说法有资料支撑,哪些只是我们的理解。
资料给出了设计,却没解释原因
- Pro 和 Flash 的开头为什么不同。 报告规定 Pro 的前两层用 HCA,Flash 的前两层用纯滑动窗口注意力,配置也一致(Pro 的
compress_ratios以128, 128开头,Flash 以0, 0开头)。我们没找到任何解释。除了层数,这两层是两个模型层类型排布的唯一差别(§2.2)。 - 为什么是压缩比 4 和 128。 报告给两个模型都设定 CSA 压缩比为 4、HCA 为 128;Miles 的压缩器甚至直接断言压缩比只能是 {4, 128} 之一。在我们手上的报告文本里,没有找到其他压缩比的消融实验。后来的 V4.1-Flash 改用了压缩比 2 和 1(§12.4)。我们的理解是,DeepSeek 并不把 4 和 128 当成定数,不过 V4.1 连压缩器本身也改了。
-
哈希路由表是怎么生成的。 报告说,前三个 MoE 层按“一个关于输入 token ID 的预定义哈希函数”选专家,并引用了哈希层(Roller et al., 2021)。
参考代码里根本不计算这个函数:
tid2eid是从 checkpoint 加载的冻结int32表,每个哈希层一张,形状 129,280 × 6(词表每项一行,每行 6 个专家编号)。路由权重仍然来自可学习的门控(§8.3)。表是用哪个哈希生成的、能否让各专家负载均衡,我们的资料里都没有。
举个例子:第 0 层遇到 token id 42,模型读取该层 tid2eid 的第 42 行,得到 6 个专家,再用门控对这 6 个专家的 sqrt-softplus 分数加权,这些分数归一化后再乘以 2.5(Pro)或 1.5(Flash)。查表过程完全确定;第 42 行从哪来,没有交代。
报告略去的训练细节
- CSA 索引器用什么损失训练。 报告只说,引入稀疏时“先设置一个短阶段来预热 CSA 中的闪电索引器(lightning indexer)”。DeepSeek-V3.2(arXiv:2512.02556)用 KL 损失让索引器逼近稠密注意力分布:先在稠密预热阶段,再在保留下来的 key 上训练(详见 GLM-5.3 那篇文章的 §5.4)。V4 是否在压缩块上沿用同样做法,资料没说,我们也不做假设。
- Pro 的稠密预热有多长。 Flash 在前 1T token 用稠密注意力训练,到 64K 序列长度时才引入稀疏注意力。对 Pro,报告只说它“以更长的稠密注意力阶段开始”,没有给数字。(后来的 V4.1-Flash 干脆取消了预热,在 64K 下从头训练稀疏注意力。)
-
Miles 里索引器的 FP8/FP4 差异会不会影响 RL。 DeepSeek 参考代码在索引器的压缩 key 上模拟 FP4(Hadamard 旋转后做
fp4_act_quant,块大小 32);启用 FP8 训练时,Miles 在同一位置模拟的是 FP8(块大小 128),见 §13。我们的理解:如果 rollout 像参考代码那样把索引器 key 量化到 FP4,而训练用 FP8 或 BF16,两边打分可能略有出入。Miles 提供可选的索引器回放(
--use-rollout-indexer-replay,默认关闭),在训练时固定使用 rollout 的 top-k 选择,让选中的块保持一致;剩下的对数概率差距有多大,我们没找到测量结果。
计数口径与日期
-
1.6T 和 284B 的总数包含什么。 按配置中的权重形状复算(§2.3),不计 MTP 块时 Pro 约 1,573B、Flash 约 284B。加上一个 MTP 块(按我们的计数,Pro 约 25.7B,Flash 约 6.6B)后,分别约为 1,599B 和 290.6B。
也就是说,Pro 的“1.6T”计入 MTP 更吻合(不过 1,573B 四舍五入也是 1.6T),Flash 的“284B”不计 MTP 更吻合。要么两个数字口径不同,要么我们的权重模型漏了什么;safetensors 索引文件能解决这个问题,但我们手上没有。以上加总都是推算值,不是官方数字。
-
发布时间。 arXiv 编号是 2606.19348,这个前缀通常意味着 2026 年 6 月提交,但 arXiv 摘要页写的是“Submitted on 26 Apr 2026”。我们读到的模型卡都没有写发布日期。按 DeepSeek 以往的命名习惯,
-0731和-0813后缀看起来对应 7 月 31 日和 8 月 13 日,但没有任何模型卡明说,所以本文不把任何发布日期当作事实。
长上下文质量
- 超过 128K 后检索能力下降多少。 报告说 MRCR 检索“在 128K 上下文窗口内保持高度稳定”,“超过 128K 后性能下降变得可见”,而在 1M 时与其他模型相比依然很强。各长度的分数在图 9 里,但我们对这张图的文本提取是乱码,所以只引用表格中的 1M 数值:MRCR 1M 上 V4-Pro-Max 为 83.5,V4-Flash-Max 为 78.7。从 128K 到 1M 下降得有多陡,仍是未知数。
其他零碎问题
- “DFlash attention”。 V4-Flash-Vision-Exp 的模型卡说,它的参考推理代码“涵盖视觉编码器与对齐器、DFlash attention、MoE、Hyper-Connections 以及 DSpark 前向路径”。我们的资料都没有定义 DFlash attention,视觉部分的代码也不在我们的资料范围内。
- 一个 Cybergym 数字在不同模型卡里对不上。 Opus-4.8 的 Cybergym 分数在 Flash-0731 卡里是 83.1,在 Pro-0813 和 Vision-Exp 卡里是 78.3(0813 卡里的 83.1 属于 Fable-5)。我们的理解是 0731 卡的这一项更可能是例外,但模型卡本身没有确认(§12.2)。
- 不同模型卡的基准版本变了。 预览版卡用的是 Terminal Bench 2.0 和 Toolathlon;0731 和 0813 卡用的是 Terminal Bench 2.1 和 Toolathlon-Verified。不同版本的分数不可比,本文也不做这种比较。
- V4.1-Flash 为什么能跳过稠密预热。 它的报告说,稀疏注意力“在 64K 序列长度下从头训练,没有任何稠密注意力预热阶段”,而 V4 需要预热。这一变化来自 CSA2、来自数据还是别的原因,报告没有解释。
参考资料
本文的每个数字都能追溯到下列资料;凡是我们自己的计算、理解或外部假设,正文都有标注。
一手资料:DeepSeek
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence(arXiv:2606.19348):V4 技术报告,涵盖架构(CSA、HCA、mHC、MoE)、基础设施、预训练、后训练与评测。
- DeepSeek-V4.1-Flash 技术报告(模型仓库中的 PDF):CSA2、编码器-解码器式 KV 布局、FP4 KV cache、Single-Pass mHC 与 Engram(§12.4)。
- Hugging Face 仓库附带的参考推理代码(
inference/model.py、inference/kernel.py):V4-Pro 与 V4-Flash 共用同一份模型代码。本文的精确形状、压缩器、索引器、哈希路由与 YaRN 处理都读自这里。 - deepseek-ai/DeepSpec:DSpark 模型卡为投机解码模块给出的链接。
- DeepGEMM pull request #304:报告开源的 MegaMoE 融合大 kernel(mega-kernel)。
- deepseek-ai/FlashMLA:FP8 MLA cache 布局,我们对 V3.2 每 token 字节数的假设以此为依据(§9)。
模型卡与配置
- deepseek-ai/DeepSeek-V4-Pro 与 deepseek-ai/DeepSeek-V4-Flash:预览版,含配置、基座模型与各推理模式的评测表。
- deepseek-ai/DeepSeek-V4-Pro-DSpark:同一个 checkpoint,外挂一个投机解码模块。
- deepseek-ai/DeepSeek-V4-Flash-0731 与 deepseek-ai/DeepSeek-V4-Pro-0813:取代预览版的正式版。
- deepseek-ai/DeepSeek-V4-Flash-Vision-Exp:V4 家族第一个实验性多模态模型。
- deepseek-ai/DeepSeek-V4.1-Flash:后来的 V4.1-Flash,含配置与推理代码。
- DeepSeek-V4 合集,技术报告中给出的链接。
背景论文
- DeepSeek-V3 技术报告(arXiv:2412.19437):DeepSeekMoE、无辅助损失的负载均衡与 MTP,V4 都继承了下来。
- DeepSeek-V3.2(arXiv:2512.02556):DeepSeek 稀疏注意力与闪电索引器,也是 V4 对比的基线。
- DeepSeek-V2(arXiv:2405.04434):多头潜在注意力(MLA),V4 用共享 KV 的 MQA 核心取代了它。
- mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880) 与 Hyper-Connections(Zhu et al., ICLR 2025):§7 残差流设计的来源。
- Hash Layers for Large Sparse Models(Roller et al., NeurIPS 2021):V4 前三个 MoE 层所用哈希路由的出处。
- Muon: An optimizer for hidden layers in neural networks(Jordan et al., 2024) 与 Muon is Scalable for LLM Training(Liu et al., 2025;arXiv:2502.16982):V4 所用的优化器,以及它沿用的 Moonlight 做法。
- YaRN: Efficient Context Window Extension of Large Language Models(Peng et al., 2023;arXiv:2309.00071):配置和代码中出现的 RoPE 缩放方法。V4 技术报告正文没有讨论 YaRN。
- You Only Cache Once: Decoder-Decoder Architectures for Language Models(Sun et al., NeurIPS 2024;arXiv:2405.05254):V4.1-Flash 编码器-解码器式 KV 布局所引用的灵感来源。
- Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models(Cheng et al., 2026;arXiv:2601.07372):Engram,V4.1-Flash 用到了它。
开源训练实现
- radixark/miles:DeepSeek-V4 支持位于
miles_plugins/models/deepseek_v4/(§13)。
本站相关文章
- 逐层拆解 GLM-5.3 与 GLM-5.3-Flash:从零讲解 MLA、DSA、闪电索引器与 mHC。
- Miles v0.1 深度解析:§13 背后的 RL 训练框架。