Meta 相隔九周发布了两个开放权重模型。2026 年 8 月 10 日,它以 Apache 2.0 许可证发布了 Muse Glimmer 30B。这是一个稠密模型,“从 Muse Spark 蒸馏而来,专为在消费级硬件上执行自主智能体任务而打造”。按其技术报告的说法,它首要的设计约束是“在严格的 32 GB 显存上限内稳定运行”。10 月 15 日,Meta 又以 Muse Model License 发布了 Muse Spark Open:参数“总计 816B / 激活 42B”,上下文 1M token,还有一个 BF16(bfloat16)checkpoint,Meta 的文档把它“部署在八张 GPU 上,例如 8 × B300”。量化到约 4 bit 之后,前者一张消费级显卡就装得下;后者则需要一台多 GPU 服务器,按 Meta 文档的说法,也可以用两台各配 512 GB 统一内存的 M5 Ultra Mac Studio。
读一读代码就会发现,两者其实是同一套架构按两种规模搭出来的。Spark Open 在 Hugging Face(HF)Transformers 中的实现,是在 Glimmer 实现之上打的一个补丁。在它的 modular 文件里,30 个类中有 18 个(按我们的统计)继承自 Muse Glimmer 的类,例如 class MuseSparkTextAttention(MuseGlimmerTextAttention)。两个模型用的是同一种分组查询注意力(GQA),输出端带一个可学习的 sigmoid 门控,并对 query 和 key 做无权重的归一化(QK-norm);层的节奏也一样,每三个局部层(滑动窗口层)配一个全局层(全注意力);两者还共用三明治归一化(sandwich norm,每个子层前后各一个归一化)、经软截断(softcap)的输出层(用 tanh 把每个 logit 压在 ±20 以内)、同一个 202,048 token 的词表和同一种视觉编码器架构。在这副骨架之上,Spark 改了四处:注意力里逐头的输出归一化、保范数的残差门、用潜空间混合专家(latent MoE)层取代稠密前馈网络(FFN),以及一个音频编码器。
这一对模型还对同一个设计问题给出了两种答案:前馈参数应该做成稠密的,还是拆成专家?Glimmer 的报告替小模型作了回答。在 32 GB 的上限下,稠密模型阶梯(ladder,用同一套配方训练的一组规模递增的模型)的计算效率是内存占用相同的 MoE 模型阶梯的“2×-2.5×”,因此团队“选择了 30B 参数的稠密设计”。Spark Open 给出的答案正好相反:每层 256 个专家,存储 816.68B 个解码器块(decoder block)参数,每个 token 只用其中 42.78B(推算,§2.3)。本文从配置和代码中读出 Spark 的设计;凡是两个模型共用的部件,就借助 Glimmer 的报告来讲。
下面四个数字概括了后文的内容。四个数字都是根据公开的配置和代码推算的,括号里的章节给出了计算过程。
本文完全依据公开资料,并为每条结论注明出处:
- 模型卡与配置: Spark Open 的模型卡(即 NVFP4 版本的模型卡,NVFP4 是 NVIDIA 的 4 位浮点格式)、Muse Glimmer 30B 模型卡和配置,以及 Hugging Face 仓库元数据中的参数量和各数据类型(dtype)的计数。下载 Spark Open 的官方权重需要先接受 Muse Model License。Spark 的配置数值取自 Transformers v5.20.0 代码中的默认值,以及 mlx-community 公开的 MLX 转换版本中的
config.json;该版本按 Muse Model License 再分发模型,只多了量化相关的键。在代码定义了的每个结构字段上,两者都一致(代码里没有num_shared_experts)。 - 代码: Transformers 中 Muse Glimmer(v5.15.0 加入)和 Muse Spark(v5.20.0 加入,我们读的就是这个 tag 的代码)的实现;llama.cpp 的计算图和转换脚本;mlx-lm;TorchTitan 的 Muse Spark 实现与训练配方;以及 Miles 的 Muse Spark Open 训练配方。
- 论文: Glimmer 报告《Muse Glimmer 30B: An On-Device Agentic Model》(arXiv 2610.24628,2026 年 10 月 17 日提交);以及《Muse Spark Safety & Preparedness Report》(arXiv 2606.12429,2026 年 5 月 14 日提交),它讨论的是闭源的 Muse Spark,而不是 Spark Open。
- 博客与文档: Meta 在 research.meta.ai 上的发布文章、它的开发者文档、PyTorch 博客,以及 Hugging Face、vLLM 和 SGLang 的首日(day-0)支持文章。
凡是我们为共用的设计选择给出理由,理由都来自 Glimmer 报告,并会注明;对于 Spark 独有的部件,证据是代码和配置。除非另有说明,数字都来自配置、代码和模型卡。我们自己算出的数字(如参数拆分、缓存大小)标注“推算”;从图上读出的数值标注“近似值”;我们对证据的解读标注“我们的理解”。
阅读本文需要知道什么是大语言模型(LLM)、注意力和 Transformer 层。有几个构件在之前的文章里讲过,本文对每个只用一两句话回顾。GLM-5.3 深度解读讲过多头潜在注意力(MLA,见该文 §3)、带偏置负载均衡的 MoE 路由器(见该文 §4.3)和流形约束超连接(mHC,见该文 §8.6);DeepSeek-V4 深度解读讲过带注意力汇点(attention sink)的滑动窗口注意力(见该文 §3.4)和它的 MoE 层(见该文 §8)。Muse 既不用 MLA,也不用 mHC,但两者都是有用的参照。
各节层层递进:
- §1: 家族全景:从闭源的 Muse Spark 到两个开放模型,一张并排对比表,以及两者共用什么、Spark 改了什么。
- §2: 逐层导览:一个 token 的路径、“三个局部层配一个全局层”的排布,以及参数都在哪里(3D 模型:两个层堆叠并排)。
- §3: 注意力:分组查询的形状、无权重 QK-norm 及其固定温度、sigmoid 输出门控与 Spark 的输出归一化、只用在局部层上的旋转位置编码(RoPE),以及 Glimmer 试过又放弃的 MLA 变体(3D 模型:一个带门控的注意力层)。
- §4: Spark 的潜空间 MoE:路由器、降维到 4,096、块内的归一化、它缺了什么,以及 Glimmer 为什么是稠密模型(3D 模型:专家与潜空间)。
- §5: 残差流:Glimmer 的三明治归一化、Spark 的保范数残差门、RMSNorm(均方根归一化)的几种变体,以及归一化后的嵌入和经软截断的输出层(3D 模型:单位圆上的残差流)。
- §6: 感知:共用的 Perception Encoder(感知编码器)、patch(图块)如何变成 token,以及 Spark 的卷积音频编码器。
- §7: 长上下文:不做 RoPE 缩放也能支撑 1M 个位置、KV cache、每 token 计算量,以及如何把权重装进显存(3D 模型:内存与计算量随上下文长度的变化)。
- §8: 投机解码:用独立的 DFlash 草稿模型(drafter),而不是内置的多 token 预测(MTP)头。
- §9: 训练:Glimmer 从 Muse Spark 协同蒸馏、Spark Open 的安全后训练与推理强度控制,以及 TorchTitan 和 Miles 的训练配方。
配套幻灯片
一份 31 页的幻灯片按章节顺序以演讲形式讲了同样的内容,用的是本文的图和 3D 模型。
1. 家族全景
两个开放的 Muse 模型从哪里来,彼此又相差多远?本节先把它们放到 Meta 的公开时间线上,再并排对比,最后把各部件分成“共用”和“改动”两类。一句话概括:Muse Glimmer 30B 由 Muse Spark 蒸馏而来;用 Meta 的话说,Muse Spark Open 是“Muse Spark 的开放权重版本”,并额外做了安全后训练;而在代码里,大模型写成了小模型之上的一个补丁。
1.1 从 Muse Spark 到两个开放模型
这个家族起步于一个闭源模型。2026 年 4 月 8 日,Meta 发布了 Muse Spark,称它是“Meta 超级智能实验室(Meta Superintelligence Labs)开发的 Muse 系列模型中的第一个”。随后是三个小版本:7 月 9 日的 Muse Spark 1.1,同时推出“新 Meta Model API 的公开预览”;8 月 5 日的 Muse Spark 1.2,即“面向编程的 Muse Spark 1.1 更新”,与终端编程智能体 Muse Code(beta)一同发布;以及 9 月 2 日的 Muse Spark 1.3,“支持最高推理强度(max reasoning)”。
开放权重分两步放出。8 月 10 日,Meta 以 Apache 2.0 许可证发布了 Muse Glimmer。它的模型卡称其为“一个 300 亿参数的因果语言模型,配有专用的感知编码器,从 Muse Spark 蒸馏而来,专为在消费级硬件上执行自主智能体任务而打造”。10 月 15 日,Meta 以 Muse Model License 发布了 Muse Spark Open,参数“总计 816B / 激活 42B”,上下文 1M token(模型卡)。10 月 17 日,Glimmer 技术报告《Muse Glimmer 30B: An On-Device Agentic Model》(2610.24628)出现在 arXiv 上。这份报告解释了 Glimmer 背后的设计选择,其中许多也为 Spark 所共用;至于 Spark 独有的部件,本文读的是代码和配置。
关于 Spark Open 与闭源模型的关系,Meta 的模型页面写道:“Muse Spark Open 源自我们 8 月发布的 Muse Spark 模型,并额外做了安全后训练,使它作为没有系统护栏的独立模型时更能抵御滥用。”
Glimmer 的报告则更详细地交代了它自己的来历:基座模型“通过对 Muse Spark 做 logit 蒸馏”训练而成,做法是“在 Muse Spark 预训练期间记录它的前 256 个 logit”;后训练则依次用到 Muse Spark 轨迹上的监督微调、以 Muse Spark 为教师的 on-policy 蒸馏,以及强化学习(§9.1)。报告还写明了另一项继承:Glimmer“采用 Llama 4 的字节对编码(BPE)分词器,词表共 202,048 个 token”(见“Tokenizer”小节);而根据 Spark Open 的 Transformers 文档,它“与 Muse Glimmer 共用分词器和词表”。除了分词器,资料提到 Llama 4 时,要么把它当作前代,要么拿它作对照:Muse Spark 的发布文章说,重建后的预训练栈用“少一个数量级以上的算力”,达到了与“我们的上一代模型 Llama 4 Maverick”相同的能力;Glimmer 报告则拿自己的蒸馏损失与 Llama 4 那种混合软目标和硬目标的做法作对比。本文不在 Llama 4 和 Muse 之间画架构上的传承关系。
下面的动画梳理了整个家族。先看四个闭源版本依次填满上方的泳道,然后 Glimmer 和 Spark Open 出现在下方泳道,各自用一支箭头连到闭源产品线上,箭头上标着各自出处的原话。最后一支橙色箭头连接两个开放模型,请留意它指向哪一边。

训练的箭头从闭源的 Muse Spark 指向 Glimmer:Muse Spark 是教师,Glimmer 是学生。代码的箭头则从 Glimmer 指向 Spark Open。Glimmer 先进入 Hugging Face Transformers(v5.15.0,8 月 10 日);Spark Open 的实现 10 月 15 日随 v5.20.0 合入,是以 Glimmer 为基础写成的一个“modular”文件。modular 文件只声明与已有类不同的部分,再由转换脚本展开成实际运行的完整建模文件。在 modular_muse_spark.py 中,30 个类有 18 个继承自 Muse Glimmer 的类(按我们的统计),例如 class MuseSparkTextDecoderLayer(MuseGlimmerTextDecoderLayer)。正因如此,本文可以先把共用的骨架讲一遍(主要借助 Glimmer,因为它的报告解释了各项选择),再逐一讲 Spark 改了什么。
实现细节:代码的谱系
modular_muse_spark.py导入了 17 个 Muse Glimmer 类和两个辅助函数(apply_rotary_pos_emb、eager_attention_forward)。它还从其他模型家族引入了DeepseekV3Experts(MuseSparkExperts的父类)、MiniMaxM2TopKRouter(MuseSparkTopkRouter的父类)、CLIPMLP(用作音频编码器的多层感知机,MLP),以及 Voxtral-Realtime 的两个类:一个因果一维卷积及其填充缓存。- 视觉塔就是一行
class MuseSparkVisionModel(MuseGlimmerVisionModel): pass。视觉部分唯一的改动在MuseSparkVisionPatchEmbedder里:它按 (t, w, h) 而不是 (t, h, w) 的顺序把 patch 网格交给位置表查找,只有非正方形图像的结果会因此改变(§6.1)。其余 12 个类没有 Glimmer 父类:上面的路由器和专家、MuseSparkMoE、MuseSparkResidualGate,以及音频配置和音频塔。 - Glimmer 也是用同样的方式由更早的模型拼装而成:配置、解码器层、中心化 RMSNorm、MLP 和旋转位置嵌入来自 Gemma 2;门控注意力来自 AFMoE(
AfmoeAttention);权重可选的 RMSNorm 来自 Gemma 4;视觉编码器层和多模态封装来自 Kimi-K2.5;patch 嵌入器来自 PaddleOCR-VL。 models/muse_glimmer首次出现在 tag v5.15.0(发布说明,2026-08-10),models/muse_spark首次出现在 v5.20.0(发布说明,2026-10-15,经由 PR #49644 合入)。
1.2 Spark Open 与 Glimmer 并排对比
纸面上两个模型差别有多大?它们的词表、注意力窗口、旋转基数和 logit 软截断值都相同,不同的是深度、宽度、头的布局、前馈块和残差路径。
表中反复出现四个术语,后文各有专节。局部层是滑动窗口注意力层:每个 token 关注自身和之前的 2,047 个 token,query 和 key 都带 RoPE。全局层关注之前的所有 token,不用任何位置编码(NoPE);§2.2 解释为什么 Spark 的全局层是索引为 1、5、…、61 的层(从 0 起编号),而 Glimmer 的是 3、7、…、51,§3.4 解释它们为什么不用 RoPE。潜空间 MoE 是 Spark 的混合专家层:在进入专家之前,它把每个 token 从 8,192 个数压缩到 4,096 个数,之后再扩回原宽度(§4)。残差门把普通的残差相加换成按通道学习的加权混合,混合的是残差流和子层输出(§5.2)。
第一张表列出两个模型的全部结构设置,以及每项取自哪个配置键。“同左”表示两份 config.json 中的值相同;字节数按 BF16 计,每个值 2 字节;标注“推算”的行是我们的计算结果。
| Muse Spark Open | Muse Glimmer 30B | 配置键 | |
|---|---|---|---|
| 解码器块 | 62 | 52 | num_hidden_layers |
| 隐藏维度 | 8,192 | 6,656 | hidden_size |
| query 头 / KV 头 | 128 / 16(每个 KV 头对应 8 个) | 32 / 2(每个 KV 头对应 16 个) | num_attention_heads、num_key_value_heads |
| 头维度 | 64 | 128 | head_dim |
| 注意力宽度,头数 × 头维度(推算) | 8,192 | 4,096 | – |
| 每 token 每层 KV cache,BF16(推算) | 4 KiB | 1 KiB | – |
| 局部层 : 全局层 | 46 : 16(2.875 : 1) | 39 : 13(3 : 1) | layer_types |
| 全局层编号,从 0 起(无 RoPE) | 1、5、9、…、61 | 3、7、11、…、51 | layer_types、layer_rope_theta |
| 滑动窗口 | 2,048 token | 同左 | sliding_window |
| RoPE | θ = 500,000,仅用于局部层 | 同左 | rope_parameters、layer_rope_theta |
| 最大位置数 | 1,048,576 | 131,072 | max_position_embeddings |
| 词表 | 202,048 | 同左 | vocab_size |
| 前馈块 | 每个块都是潜空间 MoE:256 个路由 SwiGLU(Swish 门控线性单元)专家,top-8,每个专家在宽度 4,096 下运行,中间维度为 4,096 | 稠密 SwiGLU,6,656 → 19,968 → 6,656 | num_local_experts、num_experts_per_tok、moe_hidden_size、moe_intermediate_size / intermediate_size |
| 共享专家 | 0 | – | num_shared_experts |
| QK-norm | 对每个 query 头和 key 头做无权重 RMSNorm,然后 Q × 5.4730064863875 | 同左,然后 Q × 3.87 | qk_scale_factor |
| 注意力输出 | 逐头的无权重输出归一化(o_norm),再接 sigmoid 输出门控 |
sigmoid 输出门控 | (代码) |
| 子层周围的归一化 | 两个子层之前:增益为 $1 + w$ 的 RMSNorm(“中心化”);注意力之后:无权重 RMSNorm;MoE 之后:先缩放后归一化的 RMSNorm(“input-scaled”) | 三明治归一化:每个子层前后各一个中心化 RMSNorm | rms_norm_eps 1e-5、post_norm_eps 1e-8 |
| 残差连接 | 可学习的残差门,温度 0.3 | 普通相加 | residual_gate_temperature |
| logit 乘子(输出层;Spark 的路由器也复用它) | 0.17678 = 1/√32 | 0.19612 = 1/√26 | output_multiplier |
| 最终 logit 软截断 | 20 | 同左 | final_logit_softcapping |
| 嵌入与输出层共享权重 | 否 | 否 | tie_word_embeddings |
| 输入 | 文本、图像、视频、音频 | 文本、图像(视频按帧输入,“未针对视频做专门优化”) | 模型卡;报告 |
| Perception Encoder | 视觉 Transformer(ViT),50 层,宽度 1,536,patch 14,参数“1.8B” | 架构相同;在 Glimmer 训练期间保持冻结 | vision_config |
| 音频编码器 | 4 级卷积堆叠,117,840,384 个参数(推算),每 1,920 个采样点一个 token(24 kHz 下即 80 ms) | 无 | audio_config |
第二张表列出规模和发布信息;GGUF 是 llama.cpp 的文件格式。解码器块的参数量由我们根据上表的形状算出。
| Muse Spark Open | Muse Glimmer 30B | |
|---|---|---|
| 官方规模 | “总计 816B / 激活 42B” | 总计“~29.6B”;名称中为“30B” |
| 解码器块参数(推算) | 总计 816,680,173,568;激活 42,780,753,920(5.24%) | 25,165,111,296,全部激活(报告:“~25.16B”) |
| 完整 checkpoint(Hugging Face 统计) | 822,036,529,664 | 29,776,626,688 |
| 官方 checkpoint | BF16,1.644 TB(推算;文档:“约 1.65 TB”);NVFP4,533.0 GB(推算) | BF16,59.55 GB(推算;文档:“约 60 GB”);GGUF Q4_K_M 约 17 GB,Q4_K_XL 约 20 GB;ExecuTorch 导出版本;一个用于投机解码的 DFlash 草稿模型(§8) |
| 访问与许可证 | 接受许可证后下载;Muse Model License | 直接下载;Apache 2.0 |
| 发布日期 | 2026 年 10 月 15 日 | 2026 年 8 月 10 日 |
| 进入 Transformers 的版本 | v5.20.0 | v5.15.0 |
数字从哪来
- 配置。 Glimmer 的数值取自其官方
config.json。Spark Open 的数值取自 Transformers v5.20.0 中MuseSparkTextConfig的默认值,以及 mlx-community 公开的 MLX 转换版本中的config.json;该版本按 Muse Model License 再分发模型,只多了quantization键。除num_shared_experts外(代码既没有定义也不读取这个键;§4.5),两者在表中每个结构数值上都一致。两份模型卡都重述了表中的主要几行;Spark 的模型卡写的是“注意力块带输出门控和输出归一化;启用 QK-norm”。 - 全局层与窗口。 两份配置的 docstring 都把 NoPE 层放在“从最后一层往回数,每 4 层一个”的位置;在两份已发布的配置里,全注意力层恰好就是 NoPE 层。共 $L$ 层时,若 $L - 1 - i$ 是 4 的倍数,第 $i$ 层就是全局层;$61 \bmod 4 = 1$ 让 Spark 的第一个全局层落在索引 1,$51 \bmod 4 = 3$ 让 Glimmer 的落在索引 3(§2.2)。在 Transformers 的掩码中,局部层能看到当前 token 和之前的 2,047 个 token。
- 推算的形状。 每 token 每层的 KV cache = 2(K 和 V)× KV 头数 × 头维度 × 2 字节:Spark 为 2 × 16 × 64 × 2 = 4,096 B,Glimmer 为 2 × 2 × 128 × 2 = 1,024 B。logit 乘子遵循两份配置 docstring 中“针对已发布 checkpoint”给出的规则:1/√(
hidden_size/256)。 - 参数量。 §2.3 推算解码器块的参数量(总计 62 × 13,172,260,864,激活 62 × 690,012,160),并把两个模型在 Hub 上的总数逐个参数核对清楚。简言之:官方的“816B / 42B”只对应 62 个解码器块,而且是截断取整(816.68B 和 42.78B 四舍五入会得到 817B 和 43B)。这种计数口径是我们的理解;Glimmer 报告的“~25.16B”用的就是这一口径(“不含嵌入层和输出层”)。Hub 上的总数还要加上不共享的嵌入和输出层、最终归一化、各编码器,对 Spark 还要加上路由器那个含 15,872 个条目的 FP32(32 位浮点)偏置缓冲区。Glimmer 模型卡中的“~29.6B”等于报告中各部分取整后之和(25.16 + 1.34 + 1.34 + 1.8 = 29.64),而“30B”是 checkpoint 的 29.78B 取整的结果。
- 字节数。 Spark 的 BF16 大小是 Hub 上 65 个分片大小之和,即 1,644,333,393,864 B;NVFP4 的大小由 Hub 上按数据类型的计数,以及量化张量与 BF16 张量的划分推出(§4.5、§7.4);Glimmer 的权重索引给出 59,553,253,376 B。文档中的数字见 Spark Open 文档和 Glimmer 文档的“获取模型”页面。
1.3 一副骨架,两种答案
两个模型共用什么,Spark 又改了什么?抛开规模不看,两者的架构几乎完全相同:
- 注意力块。 分组查询注意力、对 query 乘一个固定系数的无权重 QK-norm,以及由归一化后的层输入算出的 sigmoid 输出门控(§3)。两个系数让两种头维度得到相同的注意力温度,也就是每个注意力 logit 上的固定缩放:3.87 × √128 = 5.473 × √64 = 43.78(推算;§3.2)。
- 层排布。 每三个局部层(窗口 2,048,RoPE θ = 500,000)配一个不带位置编码的全局层,从最后一层往回数(§2.2、§3.4)。
- 归一化骨架。 token 嵌入上的无权重归一化、每个子层之前的中心化 RMSNorm、每个子层输出上的归一化,以及乘以 1/√(d/256) 并在 20 处软截断的输出层(§5)。
- 词表与视觉。 202,048 个 token 的词表、不共享的嵌入,以及架构相同的 Perception Encoder、pixel shuffle(像素重排)和适配器(§6.1–6.2)。
Spark 改了四处:
- 注意力中的输出归一化。 一个逐头的无权重 RMSNorm(
o_norm)在门控之前对注意力输出做归一化(§3.3)。 - 残差门与改造后的后置归一化。 每次残差相加都变成一个可学习的门 $\alpha \odot x + \beta \odot f$,混合残差流 $x$ 与分支输出 $f$;$\alpha$ 和 $\beta$ 相互绑定,使每个通道上 $\alpha^2 + \beta^2 = 1$,只有一处钳位(clamp)会带来微小偏差。注意力之后的归一化去掉了权重,FFN 之后的归一化则先缩放再归一化(§5.2–5.3)。
- 用潜空间 MoE 取代稠密 FFN。 路由器读入完整的 8,192 维残差流,从 256 个专家中挑出 8 个;该块把 token 降维(pool)到 4,096,在那里运行专家,再升维(unpool)回 8,192(§4)。
- 音频编码器。 一个 117.84M 参数(推算)的卷积堆叠把 24 kHz 的原始音频转换成每 80 ms 一个 token(§6.3)。
其余部分都是共用设计按比例缩放的结果:62 个块而不是 52 个,宽度 8,192 而不是 6,656,128 个宽 64 的 query 头而不是 32 个宽 128 的,1,048,576 个位置而不是 131,072 个。
为什么同一副骨架,在一个模型里是稠密的,在另一个模型里却每层有 256 个专家?对于小模型,Glimmer 报告给出的就是引言里引用的那个答案。它在“保持推理时的总内存占用不变”的条件下,把一组稠密模型阶梯与两组 MoE 阶梯(激活专家比例为 1:8 和 1:16)作比较;尽管同样的 GPU 小时数让 MoE 模型的每参数训练 token 数达到稠密模型的好几倍,MoE 阶梯还是输了;§4.6 会详细介绍这个实验及其图表。我们的理解(§4.6 会展开)是:当内存限定了总参数量时,每个闲置的专家都占着内存,却不为 token 多做一点计算,所以在 32 GB 下,稠密模型能从每个字节中榨出更多价值。
Spark Open 的部署没有这个上限。Meta 的文档把 BF16 checkpoint 部署在八张 GPU 上,NVFP4 版本则“部署在单个 4-GPU 的 NVIDIA Blackwell 节点上”。按我们的理解,在这样的节点上,随每个请求增长的成本是每 token 的计算量,而不是存储的字节数。Spark 正是据此分配参数的:全部 62 层的路由专家占了 816.68B 解码器块参数中的 798.86B(97.8%),而一个 token 只激活 42.78B,即 5.24%(均为推算)。与 Glimmer 相比,Spark 存储的解码器块参数是它的 32.5×,每个 token 激活的参数却只有它的 1.70×(推算)。降维到 4,096 维的潜空间后,与在完整的 8,192 宽度下运行的专家相比,每个专家的参数量和浮点运算量(FLOPs)又减了一半(§4.3)。
所以,这两个模型是同一副骨架,对同一个问题给出了两种答案:在真正起约束作用的条件下,前馈参数该怎么花?受内存上限所限时,就让每个 token 用上全部参数;内存宽裕时,就存储大量专家,每次只动用其中几个。这种概括是我们的理解,Glimmer 报告支持其中的前一半。
2. 逐层导览
一个 token 穿过 Muse Spark Open 时会经历什么?它先变成一个由 8,192 个数组成的向量,再爬过 62 个形状完全相同的解码器块,最后化作 202,048 个词表分数离开。Muse Glimmer 30B 走的是同一条路,只是向量换成 6,656 个数,块数换成 52 个。在同一个模型内部,块与块只有一处不同:注意力是局部的(滑动窗口)还是全局的(全注意力)。两个模型之间的差别,则集中在块内的少数几个位置。本节先把这条路完整走一遍,再摆出层的排布,最后清点参数都在哪;§3–§5 再逐一拆开各个部件。
2.1 一个 token 的路径
下面以 Spark 为例走一遍,括号里是 Glimmer 的取值。张量形状来自两份配置:Glimmer 的配置,以及 mlx-community 的 MLX 转换版本中 Spark 的配置(§1.2)。运算顺序来自 Transformers v5.20.0 中的实现(Spark、Glimmer)。“隐藏状态”指在块与块之间承载这个 token 的向量,RMS 是它的均方根。
- 嵌入。 用 token 的 ID 从一张 202,048 × 8,192 的表(202,048 × 6,656)里取出一行。
- 嵌入归一化。 一个无权重 RMSNorm 把这一行除以它的 RMS。这里既没有可学习的增益,也没有 Gemma 2 代码里那种 $\sqrt{d}$ 乘子,所以每个 token 进入层堆叠时的 RMS 都是 1。
- 其他模态。 图像和视频(Spark 还有音频)各自经过自己的编码器,输出同样宽度的向量,像 token 行一样过一次无权重 RMSNorm,然后覆盖序列中的占位 token(§6)。从这里开始,层堆叠看到的只是一条向量序列。
- 前置归一化,然后是注意力。 先过一个中心化 RMSNorm(先归一化,再把每个通道乘以可学习的增益 $1 + w$),再进入带门控的分组查询注意力:128 个 query 头和 16 个 KV 头,头宽 64(32 个和 2 个,头宽 128)。query 和 key 先过无权重的 QK-norm,query 再乘以一个固定常数(§3.2);局部层用 RoPE 旋转 query 和 key,全局层不旋转。sigmoid 输出门控由同一份归一化后的输入算出,在输出投影之前逐通道缩放注意力结果。Spark 还多了一步 Glimmer 没有的操作:在门控之前先对每个头的输出做归一化(
o_norm,§3.3)。 - 后置归一化,然后是残差。 Spark 用无权重 RMSNorm 归一化注意力输出,所以这一支离开时的 RMS 是 1(Glimmer:带可学习增益的中心化 RMSNorm)。接着,Spark 的残差门把旧的隐藏状态 $x$ 和分支输出 $f$ 混合成 $\alpha \odot x + \beta \odot f$;系数逐通道取值,由一个可学习向量算出,除钳位带来的微小偏差外,满足 $\alpha^2 + \beta^2 = 1$(Glimmer:直接相加 $x + f$;§5.2)。
- 前置归一化,然后是前馈。 再过一个中心化 RMSNorm,然后进入 Spark 的潜空间 MoE。路由器读入完整的 8,192 维向量,从 256 个专家中选出 8 个;一个线性投影把向量降维到 4,096 个数,8 个专家全程在这个宽度上运行,第二个投影再把它们的加权和升维回 8,192(§4)。(Glimmer:一个稠密 SwiGLU,6,656 → 19,968 → 6,656。)
- 后置归一化,然后是残差。 Spark 的 FFN 后归一化是“先缩放后归一化”的:先乘增益,最后才归一化,所以这一支离开时的 RMS 同样是 1(Glimmer:中心化 RMSNorm)。随后是第二个残差门(Glimmer:直接相加)。
- 重复 第 4–7 步,共 62 个块(52 个)。
- 最终归一化与输出层。 先过一个带可学习绝对增益的 RMSNorm,再由不共享权重的
lm_head把 8,192 个数(6,656 个数)映射成 202,048 个分数。它不复用嵌入表。 - logit 缩放与截断。 分数先乘以输出乘子
output_multiplier$= 1/\sqrt{d/256}$,即 $1/\sqrt{32} \approx 0.1768$($1/\sqrt{26} \approx 0.1961$),再按 $20\tanh(z/20)$ 做软截断,所以最终的 logit 都落在区间 $(-20, 20)$ 之内(§5.4)。
每个块都给注意力和前馈这两个子层前后各包一层归一化,这就是 Glimmer 从 Gemma 2 继承来的三明治归一化。Spark 保留了三明治结构,但改了两个后置归一化:两者现在都以归一化收尾,之后不再乘权重,所以两条分支写出的永远是 RMS 为 1 的向量。按我们的理解,残差门的保范数运算正依赖这一点(§5.2)。
举个具体的例子:跟着一个 Spark token 走过第 1 层,这是一个全局层(§2.2)。前置归一化先把它的 8,192 个数缩放到 RMS 为 1,也就是长度 $\sqrt{8{,}192} \approx 90.5$,然后才乘上可学习的增益。几个投影把结果变成 8,192 个 query 数(128 个头 × 64)、1,024 个 key 数和 1,024 个 value 数(16 个头 × 64),以及 8,192 个门控值。其中 2,048 个 key 和 value 数按 BF16 计是 4 KiB,就是这个 token 留在本层缓存里的内容;由于第 1 层是全局层,它们会在整个序列中一直留在那里。假设某个通道上注意力之后的残差门恰好是 $\beta = 0.5$(门控参数为 0),由于 $\alpha = \sqrt{1 - 0.5^2}$,这个通道的新隐藏状态就是 $0.866\,x + 0.5\,f$。接下来,路由器给 256 个专家打分,留下 8 个。降维后的 4,096 维向量进入每个被选中的专家,在专家内部先加宽到 2 × 4,096(SwiGLU 的 gate 和 up 两半),再变回 4,096 个数。这个 token 碰到的专家权重是 8 × 50,331,648 ≈ 402.7M,只占本块 12.88B 专家权重的 3.1%(推算),和 Glimmer 整个稠密 FFN 的规模差不多(§4.1)。
近来的大型 MoE 模型里常见的三样东西,这张清单里都没有。一是没有 MTP 层:§2.3 的参数计数与两个 checkpoint 完全对上,没有任何剩余;投机解码改用基于 DFlash 或其近亲方法的独立草稿模型(§8)。二是 Spark 没有稠密层:62 个块全是稀疏的(§4.5)。三是 Spark 没有共享专家:256 个专家全部是路由专家(§4.5)。此外,两个模型都没有注意力偏置、注意力 logit 软截断,也没有可学习的注意力汇点,即有些模型给每个头额外加的一个 logit,让这个头可以把注意力权重放到“不看任何 token”上(§3.3–3.4)。
实现细节
- 调用链。
MuseSparkForConditionalGeneration.forward调用MuseSparkModel.forward;后者先把图像、视频和音频的占位 ID 置零(llm_input_ids[multimodal_mask] = 0),对序列做嵌入,再用inputs_embeds.masked_scatter(...)把编码器输出写到占位位置上。MuseSparkTextModel.forward运行 62 个块和最后的self.norm。回到顶层类之后,依次是self.lm_head(...)、logits * output_multiplier,然后除以final_logit_softcapping(20)、过torch.tanh,再乘以 20。 - 嵌入。
MuseSparkTextNormedEmbedding是一个nn.Embedding,它的 forward 返回self.embed_norm(super().forward(input_ids))。归一化之所以保留为独立模块,是为了让 DFlash 草稿模型可以绕过它直接做嵌入(§5.4)。Spark 的音频特征经过的也是这个embed_norm;视觉特征则经过perception_emb_norm,这是一个数学形式相同的独立模块。 - 块。 下面是
MuseSparkTextDecoderLayer.forward的主体,注意力调用的关键字参数做了省略:
residual = hidden_states
hidden_states = self.input_layernorm(hidden_states)
hidden_states, _ = self.self_attn(hidden_states=hidden_states, ...)
hidden_states = self.post_attention_layernorm(hidden_states)
hidden_states = self.post_attention_residual_gate(residual, hidden_states)
residual = hidden_states
hidden_states = self.pre_feedforward_layernorm(hidden_states)
hidden_states = self.mlp(hidden_states)
hidden_states = self.post_feedforward_layernorm(hidden_states)
hidden_states = self.post_feedforward_residual_gate(residual, hidden_states)
- 这些名字背后的类。 两个前置归一化都是
MuseSparkTextCenteredRMSNorm,注意力之后是MuseSparkRMSNorm(..., with_scale=False),FFN 之后是MuseSparkTextInputScaledRMSNorm,外加两个MuseSparkResidualGate,以及在config.mlp_layer_types[layer_idx] == "sparse"时构建的MuseSparkMoE。Glimmer 的MuseGlimmerTextDecoderLayer按同样的顺序执行,只是用residual + hidden_states代替残差门,四个位置用的都是中心化归一化。 - 以 diff 的方式写成。 Spark 的块和注意力继承自 Glimmer 的对应类,后者又分别继承自
Gemma2DecoderLayer和AfmoeAttention;路由器和专家则以MiniMaxM2TopKRouter和DeepseekV3Experts为起点。§1.1 的实现细节列出了modular_muse_spark.py中的全部父类。 - 精度。
_keep_in_fp32_modules_strict列出了post_attention_residual_gate、post_feedforward_residual_gate、mlp.gate.weight和e_score_correction_bias,所以路由和门控系数都以 FP32 计算;而在 BF16 运行中,隐藏状态本身仍是 BF16(§5.2)。 - llama.cpp。
muse-spark.cpp构建的是同样的计算图,转换脚本则把静态部分折叠进权重:每个 $1 + w$ 增益里的 $+1$、query 缩放(折进一个合成的 Q-norm 权重)、路由器的 logit 乘子,以及门控系数 $\alpha$ 和 $\beta$。
2.2 层的排布:三层局部,一层全局
哪些层是局部层,哪些是全局层?两份配置都带有一个显式列表 layer_types,两份代码的默认值也用同一条规则生成它:对 $L$ 层中的第 $i$ 层,若
则为全局层,否则为局部层。配置的 docstring 用文字描述了同一组层:NoPE 用在“从最后一层往回数、每 4 层一个”的层上。由于是从顶部开始数,第一个全局层的编号取决于 $L$。下表给出两个模型的结果。
| 解码器块 | 全局层(0 起编号) | 局部 : 全局 | |
|---|---|---|---|
| Muse Glimmer 30B | 52 = 4 × 13 | 3、7、11、…、51 | 39:13 = 3:1 |
| Muse Spark Open | 62 = 4 × 15 + 2 | 1、5、9、…、61 | 46:16 = 2.875:1 |
Glimmer 的 52 是 4 的倍数,所以从第 51 层往回数,落在 3、7、…、51 上,[局部, 局部, 局部, 全局] 的模式从第 0 层起整齐地重复。Glimmer 报告的架构表也是这么写的:“[局部, 局部, 局部, 全局] 循环重复”。Spark 的 62 除以 4 余 2。从第 61 层往回数,落在 57、53、…、5、1 上:第 0 层是局部层,第 1 层就已经是全局层,之后 [局部, 局部, 局部, 全局] 重复十五次,合计 16 个全局层、46 个局部层。如果改用正向规则 $(i + 1) \bmod 4 = 0$,Spark 会得到 15 个全局层,位于 3、…、59,整个层堆叠会以两个局部层收尾(推算)。
两个层堆叠都以全局层收尾,所以输出层之前的最后一层总能读到完整的上下文。我们的理解是,这正是从顶部开始数的原因。
两类层的区别在于读什么,以及怎样处理位置。局部层关注一个 2,048 个位置的滑动窗口,即 token 自身加上前面的 2,047 个,并用 RoPE 旋转 query 和 key(θ = 500,000,不做缩放)。全局层关注此前的所有 token,没有任何位置编码。§3.4 会讲窗口的确切含义,以及全局层为什么不用 RoPE;按我们的理解,正是这个选择让 Spark 无需 RoPE 缩放就能支持 1M 个位置(§7.1)。
层的排布也决定了内存开销(推算)。局部层的缓存长到窗口大小就不再增长,所以只有全局层在增长:每来一个新 token,Spark 的缓存增加 16 × 4 KiB = 64 KiB(如果 62 层全是全局层,则为 248 KiB),Glimmer 增加 13 × 1 KiB = 13 KiB(52 KiB)。§7.2 会把完整的表算一遍,一直算到一条 1M token 的 Spark 序列所需的 64.4 GiB。
这种节奏有几个近亲,下面三个都是从底部开始数的。Meta 的 Llama 4 使用“不带位置嵌入的交错注意力层”,它的 Transformers 配置按正向规则放置这些层,即在 $(i + 1) \bmod 4 = 0$ 处使用 NoPE。Cohere 的 RNoPE-SWA(arXiv 2501.18795)把带 RoPE 的滑动窗口层与不带位置编码的全注意力层交错排列;它发现“1:3 的比例达到了最佳平衡”,并把全注意力层放在“每个交错组的末尾”。§3.4 会把这两种设计与 Muse 做比较。GLM-5.3-Flash 也是三接一的节奏,每三个 Kimi Delta Attention(KDA)层接一个 DeepSeek 稀疏注意力(DSA)层;与 Muse 不同,它从底部开始数,所以它的层堆叠末尾是一个多出来的 KDA 层(GLM-5.3 那篇,§8.1)。
下面的动画把两份排布按最后一层对齐。请从右往左看:两个层堆叠的全局层列完全重合,只是 Spark 底部多出的两层把它的第一个全局层推到了编号 1。虚线条带展示未被采用的正向规则,它会让 Spark 以两个局部层收尾;最后两步在局部层上加上 RoPE 刻度,并画出每个新 token 增加的缓存。

实现细节
- 配置规则。
MuseSparkTextConfig.__post_init__(Glimmer 的配置类使用完全相同的规则)用"full_attention" if (self.num_hidden_layers - 1 - i) % 4 == 0 else "sliding_attention"构建layer_types,旁边的注释写着“参考配置中的 sliding_window_pattern [w, w, w, 0]”。layer_rope_theta用同一个判断在这些层上填 0(NoPE),其余层填 500,000。两份发布的 config.json 都把这两个列表完整写了出来,而且都与规则一致。 - 逐块。
MuseSparkTextModel.forward一次性构建两个掩码,create_causal_mask和create_sliding_window_causal_mask,然后给每个块传入causal_mask_mapping[self.config.layer_types[i]]和position_embeddings if self.config.layer_rope_theta[i] else None。layer_rope_theta只有真假值有意义:一张由全模型统一的rope_theta构建的旋转表服务所有局部层。“token 自身加上前面的 2,047 个”背后的掩码和滑动缓存代码,§3.4 会给出原文。 - llama.cpp。 Spark 的加载器要求显式的逐层模式(
ml.get_arr(LLM_KV_ATTENTION_SLIDING_WINDOW_PATTERN, hparams.is_swa_impl)),RoPE 只在use_rope = hparams.is_swa(il)的层上运行,转换脚本还断言sliding == [bool(t) for t in hparams["layer_rope_theta"]]。Glimmer 的加载器可以退回到周期为 4 的模式(load_swa_pattern(ml, 4),在il % 4 == 3处为全局层)。这个兜底对 52 层之所以正确,只是因为 52 恰好是 4 的倍数;换成 Spark,它会把全局层放在 3、…、59(推算)。
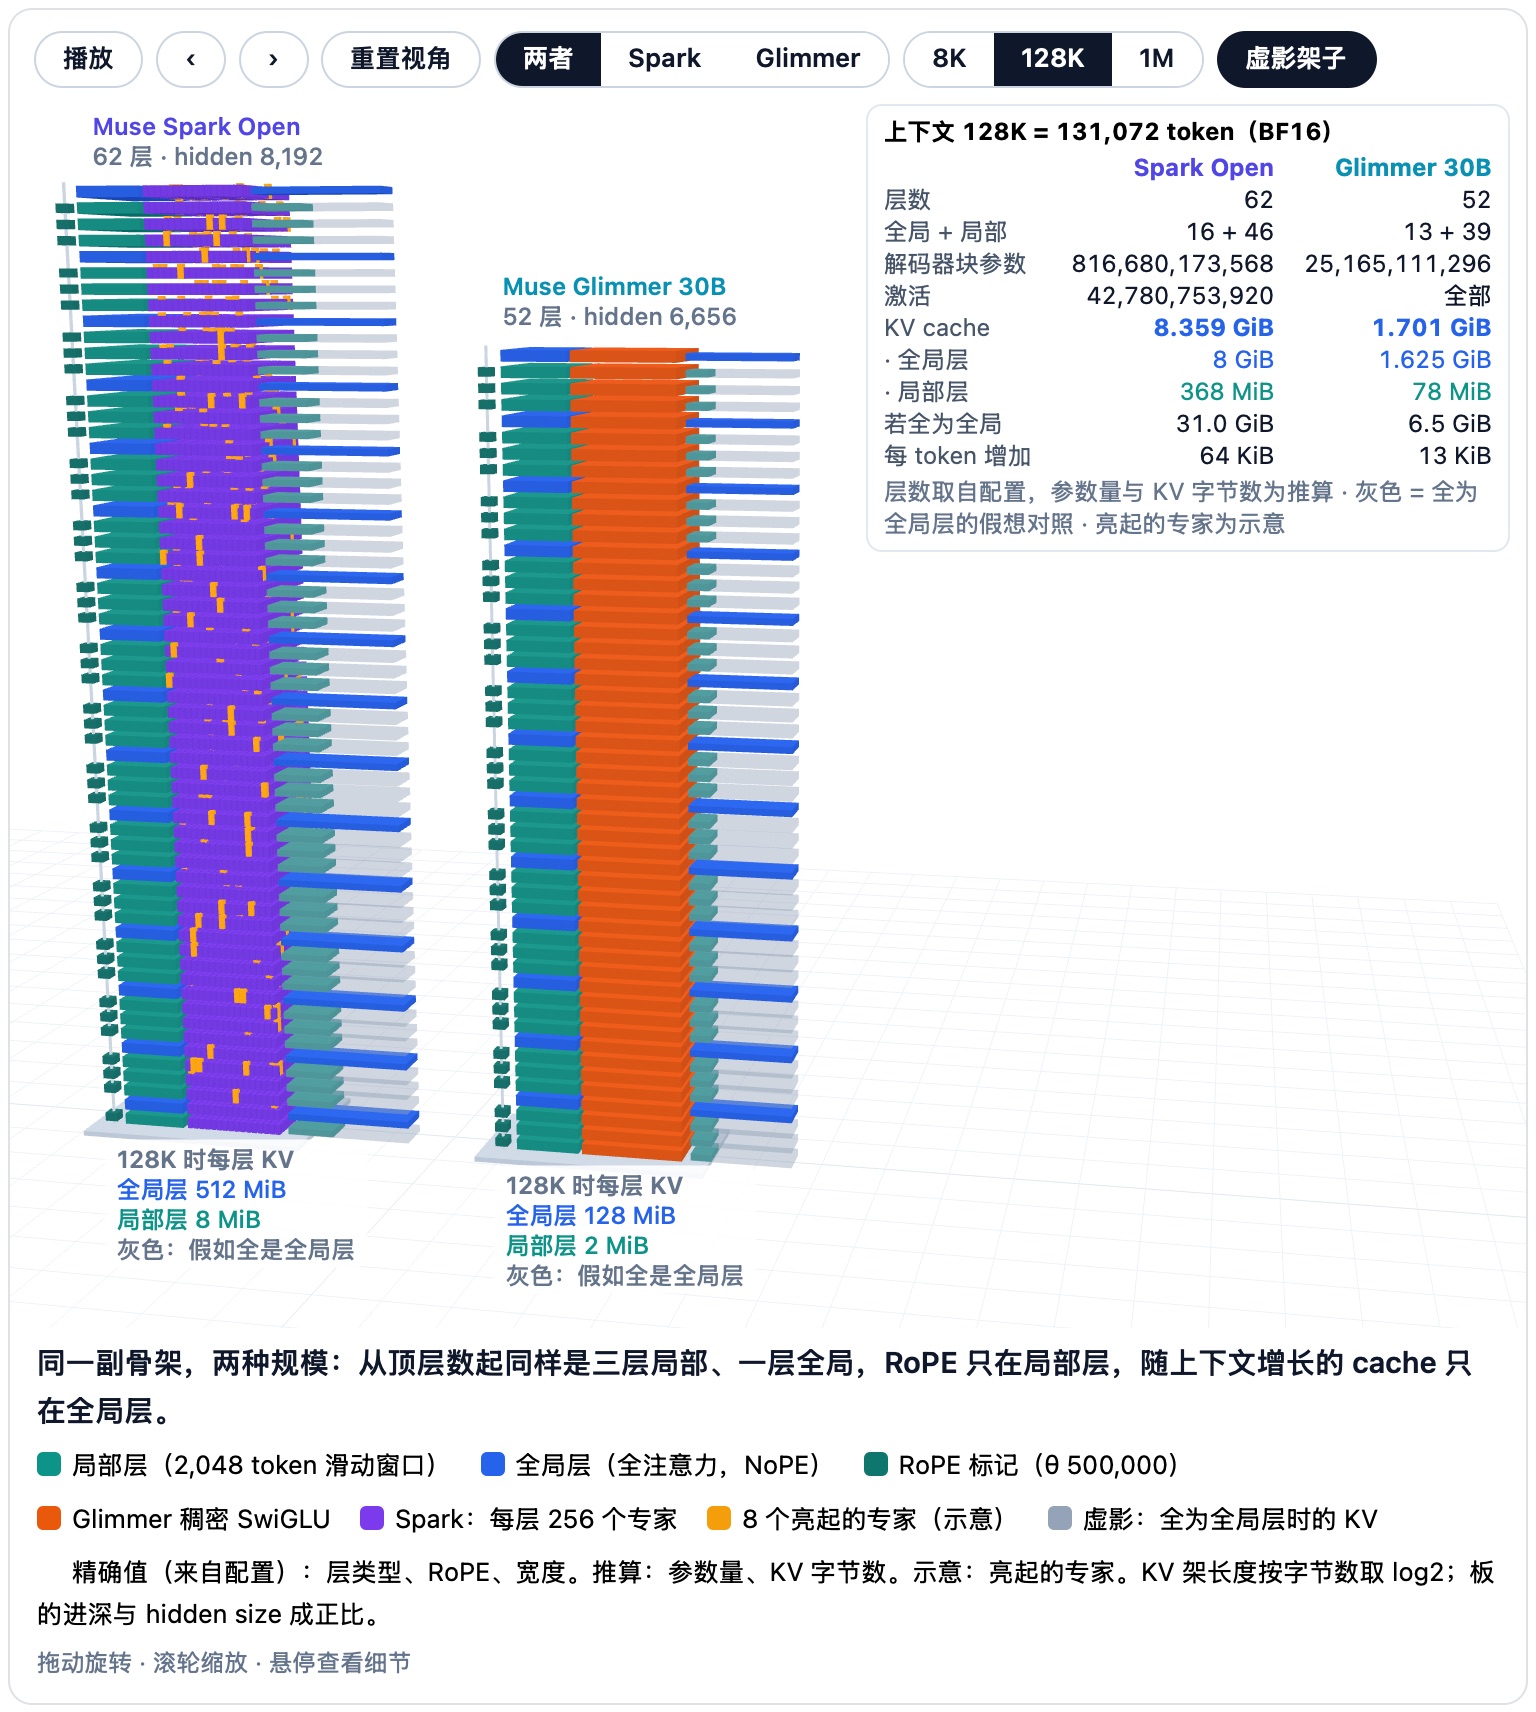
在下面的 3D 模型里,两个层堆叠并排而立,第 0 层在最下面:青绿色板是局部层,蓝色板是全局层,RoPE 标记只出现在局部层旁边。把上下文在 8K、128K 和 1M 之间切换,观察每块板旁边的 KV 架子(按对数刻度绘制)。局部层的架子长到 2,048 个 token 就停下(Spark 每层 8 MiB,Glimmer 每层 2 MiB),全局层的架子则一直变长;切到 1M 时 Glimmer 会变灰,因为它的配置最多只到 131,072 个位置。打开虚影架子,可以看到“全部为全局层”的假想情况(Spark 在 1M 时为 248 GiB);单步走到最后一步,可以比较前馈部分:Glimmer 每层一个稠密块,Spark 是一个 16 × 16 的专家网格,其中 8 个点亮(点亮哪几个是合成的选择)。
2.3 参数都在哪
Spark 几乎所有权重都在路由专家里,一个 token 用到的解码器块参数大约每 19 个才有 1 个。Glimmer 的大部分权重在稠密 FFN 里,而且全部都会用到。下面两张表是我们按配置中的形状数出来的,结果与两个公开 checkpoint 精确到个位完全一致。第一张表只看一个解码器块。
| 每个解码器块(推算) | Spark Open | Glimmer |
|---|---|---|
q_proj |
67,108,864 | 27,262,976 |
k_proj + v_proj |
16,777,216 | 3,407,872 |
o_proj |
67,108,864 | 27,262,976 |
gate_proj(输出门控) |
67,108,864 | 27,262,976 |
| 注意力 | 218,103,808 | 85,196,800 |
| 路由专家(256 × 50,331,648)/ 稠密 SwiGLU | 12,884,901,888 | 398,721,024 |
| 路由器(256 × 8,192) | 2,097,152 | — |
| 降维与升维投影(2 × 8,192 × 4,096) | 67,108,864 | — |
| 专家前与专家后归一化增益(2 × 4,096) | 8,192 | — |
| 前馈 | 12,954,116,096 | 398,721,024 |
| 块内归一化增益 | 24,576(3 × 8,192) | 26,624(4 × 6,656) |
| 残差门 | 16,384(2 × 8,192) | — |
| 块合计 | 13,172,260,864 | 483,944,448 |
| 每 token 激活 | 690,012,160(256 个专家中的 8 个) | 483,944,448(全部) |
第二张表把单个块放大到整个模型,并加上层堆叠之外的部分。
| 整个模型(推算) | Spark Open | Glimmer |
|---|---|---|
| 解码器块 | 62 × 13,172,260,864 = 816,680,173,568 | 52 × 483,944,448 = 25,165,111,296 |
| token 嵌入(202,048 × $d$) | 1,655,177,216 | 1,344,831,488 |
lm_head(不共享,形状相同) |
1,655,177,216 | 1,344,831,488 |
| 最终归一化 | 8,192 | 6,656 |
| Perception Encoder(视觉塔) | 1,852,639,744 | 1,852,639,744 |
| 视觉适配器 + 投影 | 75,497,472 | 69,206,016 |
| 音频编码器 | 117,840,384 | — |
| 参数 | 822,036,513,792 | 29,776,626,688 |
| 路由器偏置缓冲区(62 × 256,以 FP32 存储) | 15,872 | — |
| 存储的数值 | 822,036,529,664 | 29,776,626,688 |
| Hugging Face API 计数 | 822,036,529,664 | 29,776,626,688 |
| 每 token 激活(解码器块) | 42,780,753,920 | 25,165,111,296 |
官方的规模数字计入了什么?Spark 的模型卡写的是“总计 816B / 激活 42B”。我们对解码器块的计数是 816.68B 和 42.78B,四舍五入会得到 817B 和 43B;再加上嵌入和输出层,则是 819.99B。因此,官方数字对应的只是解码器块,而且是截断到整数个十亿(我们的推断)。Hub 为 Spark 仓库给出的 822,036,529,664 计入了所有存储的数值,包括 e_score_correction_bias 的 15,872 个元素,也就是路由器的选择偏置。这个张量是缓冲区(buffer)而不是参数:它不接收梯度(§4.2),所以我们的 816,680,173,568 没有计入它。
Glimmer 的数字把嵌入层和编码器也算了进去。报告的架构表列出总计“~29.6B”:Transformer 块约 25.16B,不共享的嵌入和输出投影各约 1.34B,Perception Encoder 约 1.8B;模型卡给出的是“29.6B(含视觉编码器)”。我们的块计数 25,165,111,296 与约 25.16B 吻合。列出的各部分加起来是 29.64B;checkpoint 的 29.78B 里还包含编码器的精确大小 1.853B,以及 69.2M 的视觉适配器和投影(推算)。“30B”则是把 checkpoint 向上取整。
几个占比勾勒出两个模型的形状:路由专家占 Spark 块参数的 97.8%;一个 token 只用到全部块参数的 5.24%(专家权重的 3.1%);Glimmer 的稠密 FFN 占其自身块参数的 82.4%(均为推算)。
看激活参数,注意力在 Spark 里占的份额要大得多:42.78B 激活块参数中占 13.52B(31.6%),而 Glimmer 是 25.17B 中的 4.43B(17.6%,推算)。矩阵-向量乘法每个权重要花两次运算,所以这些也是短上下文下注意力在每 token 矩阵乘计算量中的占比;对缓存 key 的打分计算另算,并随上下文增长(§7.3)。这个差距来自两处形状上的选择。一是 Spark 的注意力是“方”的:query、门控和输出投影都把 8,192 个数映射成 8,192 个,而 Glimmer 的这几个投影在 6,656 和更窄的 4,096 之间映射(§3.1)。二是 Spark 的 FFN 是稀疏的,所以每个 token 用到的部分很小:8 个激活专家每块只有 402.7M 权重,大约相当于 Glimmer 整个稠密 FFN(§4.1),外加降维和升维投影的 67.1M。按每个 token 计,Spark 的块所做的矩阵乘工作量是 Glimmer 的 1.70×(推算)。在注意力内部,输出门控和 q_proj 一样大,在两个模型里都占了将近三分之一的权重(§3.3)。
推导
- 每块的注意力。 设隐藏维度为 $d$,query 头数为 $n_q$,KV 头数为 $n_{kv}$,头宽为 $h$,四个投影共有 $d\,n_q h$ (q) $+\ 2\,d\,n_{kv} h$ (k, v) $+\ n_q h\,d$ (o) $+\ d\,n_q h$ (gate) 个参数。Spark:$3 \times 8{,}192 \times 8{,}192 + 2 \times 8{,}192 \times 1{,}024 = 218{,}103{,}808$。Glimmer:$3 \times 6{,}656 \times 4{,}096 + 2 \times 6{,}656 \times 256 = 85{,}196{,}800$。没有偏置(
attention_bias: false),QK-norm 和o_norm也没有权重。输出门控占 Spark 注意力权重的 30.8%,占 Glimmer 的 32.0%。 - Spark 的前馈。 一个专家是 $3 \times 4{,}096 \times 4{,}096 = 50{,}331{,}648$(
gate_up_proj[8,192, 4,096] 加down_proj[4,096, 4,096])。算上 256 个专家、路由器($256 \times 8{,}192$)、降维和升维投影($2 \times 8{,}192 \times 4{,}096$)以及两个 4,096 维的归一化增益,共 12,954,116,096。激活部分:把 256 个专家换成 8 个,得到 471,867,392。专家后归一化是一个 4,096 维的增益,由同一层的全部 256 个专家共用,所以只计一次。 - Glimmer 的 FFN。 $3 \times 6{,}656 \times 19{,}968 = 398{,}721{,}024$。
- 归一化与残差门。 Spark 有三个带权重的块内归一化(输入、FFN 前和 FFN 后;注意力之后的归一化没有权重),以及两个各 8,192 维的残差门:共 40,960。Glimmer 有四个带权重的归一化:26,624。
- 嵌入与输出层。 各为 $202{,}048 \times d$:Spark 是 1,655,177,216(模型卡写的是“≈ ~1.66B”),Glimmer 是 1,344,831,488(报告中的“~1.34B”)。最终归一化再加 $d$。
- Perception Encoder。 50 层 × 36,985,088,加上 patch 嵌入(1,806,336)、32 × 32 的位置表(1,572,864)和两个外层 LayerNorm(6,144):两个模型都是 1,852,639,744(§6.1)。适配器和投影:$6{,}144 \times 4{,}096 + 4{,}096 \times 4{,}096 + 4{,}096 \times d$,Spark 为 75,497,472,Glimmer 为 69,206,016。
- 音频编码器(Spark)。 四个卷积级,参数分别为 1,060,352、4,996,096、19,429,376 和 75,558,912,再加一个 16,795,648 的输出头:共 117,840,384(§6.3)。
- checkpoint 的数据类型。 Hub 为 Spark 列出的是
{'BF16': 821906490368, 'F32': 130039296}。F32 部分恰好是 $62 \times (256 \times 8{,}192 + 256)$,即路由器权重加上偏置缓冲区。Hub 把 Glimmer 的全部 29,776,626,688 个值都列为 BF16。 - 激活计数不包括嵌入查表(每个 token 只取一行)和
lm_head。算上输出层,Spark 的激活计数是 44,435,931,136。 - 占比。 注意力:$62 \times 218{,}103{,}808 = 13{,}522{,}436{,}096$,占 42,780,753,920 的 31.6%;$52 \times 85{,}196{,}800 = 4{,}430{,}233{,}600$,占 25,165,111,296 的 17.6%。路由专家:$62 \times 12{,}884{,}901{,}888 = 798{,}863{,}917{,}056$,占 816,680,173,568 的 97.8%。激活比例:$690{,}012{,}160 / 13{,}172{,}260{,}864 = 5.24\%$。Glimmer FFN:$52 \times 398{,}721{,}024 / 25{,}165{,}111{,}296 = 82.4\%$。
3. 注意力:带门控的 GQA,固定温度,全局层不用位置
Muse Spark Open 和 Muse Glimmer 30B 的一个注意力子层里发生了什么?它离教科书版本有多远?答案是不远。两个模型都以 GQA 为起点,再加上三处改动。第一,query 和 key 先经过逐头的、不带可学习权重的 RMSNorm,也就是 QK-norm,然后 query 再乘以一个固定常数,结果是两个模型里每个注意力 logit 都等于 43.784 乘以一个余弦。第二,在输出投影之前,一个 sigmoid 门控逐通道缩放每一个输出。第三,RoPE 只用在局部层,全局层完全看不到位置。Spark 还有第四处改动:在门控之前,对每个头的输出再做一次无权重 RMSNorm。
代码把这层继承关系写得明明白白。在 modular 文件里,MuseSparkTextAttention 继承自 MuseGlimmerTextAttention,只在 __init__ 里多加一个模块(self.o_norm),forward 则照搬 Glimmer 的,只多一次调用。本节其余内容对两个模型都成立;先给 Spark 的数字,括号里是 Glimmer 的。
3.1 GQA 的形状,以及一个 token 缓存多少
一个 token 在一层的缓存里要占多少?Spark 是 4 KiB,Glimmer 是 1 KiB,因为两个模型都让许多 query 头共用一个 key/value 头。在多头注意力(MHA)中,每个 query 头都有自己的 key 头和 value 头,所以每个 token 在每一层的 KV cache 里都要留下 2 × 头数 × head_dim 个数。多查询注意力(multi-query attention)则让所有 query 头共用一个 key/value 头。GQA(Ainslie et al., 2023)介于两者之间:它“使用中间数量(多于一个、少于 query 头数)的键值头”。query 头分成大小相等的若干组,每组读同一个共享的 key/value 头。
Spark 有 128 个 query 头和 16 个 KV 头,头宽 64,所以每个 KV 头服务 8 个 query 头。它的注意力宽度 128 × 64 = 8,192,正好等于隐藏维度。Glimmer 有 32 个 query 头和 2 个 KV 头,头宽 128,每组 16 个头;注意力宽度 32 × 128 = 4,096,比 6,656 维的隐藏状态窄。因此 Glimmer 的注意力不是“方”的:q_proj 和门控把 6,656 个数压到 4,096 个,o_proj 再把 4,096 个映射回 6,656 个。下表列出每一个权重,数据来自 Spark 配置(取自 mlx-community 公开的 MLX 转换版本)、Glimmer 配置和代码;§2.3 把这些数字放回整体参数预算里看。
| 每个解码器块 | Muse Spark Open | Muse Glimmer 30B |
|---|---|---|
| 隐藏维度 | 8,192 | 6,656 |
query 头数 × head_dim |
128 × 64 = 8,192 | 32 × 128 = 4,096 |
KV 头数 × head_dim |
16 × 64 = 1,024 | 2 × 128 = 256 |
| 每个 KV 头对应的 query 头数 | 8 | 16 |
q_proj 与 gate_proj [输出 × 输入] |
8,192 × 8,192 | 4,096 × 6,656 |
k_proj 与 v_proj [输出 × 输入] |
1,024 × 8,192 | 256 × 6,656 |
o_proj [输出 × 输入] |
8,192 × 8,192 | 6,656 × 4,096 |
| 五个矩阵合计参数量(推算) | 218,103,808 | 85,196,800 |
| 每 token 的 KV cache(推算) | 2,048 个数,BF16 下为 4,096 B | 512 个数,BF16 下为 1,024 B |
没有任何偏置:attention_bias 为 false,门控也以 bias=False 构建。
直白地说:一个 token 经过 Spark 的一层时,这一层往缓存里写 16 个 key 和 16 个 value,每个 64 个数,共 2,048 个数,BF16 下为 4 KiB。Glimmer 写 2 个 key 和 2 个 value,每个 128 个数,共 512 个数,即 1 KiB。如果每个 query 头都配一个 KV 头(MHA),同一个 token 在 Spark 里要占 16,384 个数,是现在的 8×;在 Glimmer 里要占 8,192 个,是现在的 16×(推算)。只有全局层会在整段对话中一直保留这些条目;在局部层里,一个 token 一旦落出 2,048 个 token 的窗口就会被丢弃(§3.4)。§2.2 按每个新 token 把这笔账乘了出来,§7.2 再把它换算成总量。
Glimmer 为什么共享得这么激进?在 32 GB 的内存预算里,Glimmer 报告(“面向端侧效率的设计”一节,英文原标题为“Design for on-device efficiency”)把缓存列为权重之后的下一个难题:“长时程智能体会话的内存占用,绝大部分来自 KV cache 的大小。”它给出的对策是滑动窗口,以及“每层只有 2 个 KV 头、头维度为 128 的分组查询注意力”。在 131,072 个 token 时,Glimmer 的 BF16 缓存为 1.70 GiB;如果用 8 个 KV 头而不是 2 个,就是 6.8 GiB(推算)。这份缓存还要和一个约 4 bit 的语言模型挤在一起,模型卡称后者“不到 20 GB”。
Spark 共享得没有这么激进:每个 KV 头配 8 个 query 头,头宽只有 Glimmer 的一半。
实现细节
MuseGlimmerTextAttention.__init__用bias=config.attention_bias构建q_proj、k_proj、v_proj和o_proj,用bias=False构建gate_proj,并设num_key_value_groups = num_attention_heads // num_key_value_heads(8 或 16)。eager 参考路径用repeat_kv把每个 KV 头复制给组内的各个头。flash 后端直接接收共享的头;SDPA 后端(PyTorch 的scaled_dot_product_attention)在 PyTorch 版本和掩码允许时传入enable_gqa=True,否则退回repeat_kv。- checkpoint 布局:Glimmer 公开的权重索引在每层下恰好列出
self_attn.{q,k,v,o,gate}_proj.weight,没有任何归一化或偏置张量。Spark 方面,社区的 MLX 3-bit 索引显示一个融合的self_attn.qkvg_proj加上o_proj(名字由转换工具决定),同样没有归一化张量。
3.2 无权重 QK-norm 与同一个温度
注意力 logit 能有多大?在 Muse 里,绝对值永远不超过 43.784。教科书式的注意力里,logit 是 $q \cdot k / \sqrt{d}$,公式中没有任何东西限制 $q$ 或 $k$ 的大小。训练中它们可能越长越大,logit 随之变大,softmax 就退化成近乎 one-hot 的选择。ViT-22B 恰好遇到了这个问题:“注意力 logit 出现极大的值,导致注意力权重(几乎)成为 one-hot,熵接近于零”(arXiv 2302.05442)。Gemma 2 用 tanh 把注意力 logit 截断在 50.0(arXiv 2408.00118);Gemma 3 则“用 QK-norm 取代了 Gemma 2 的软截断”(arXiv 2503.19786),在点积之前先对 query 和 key 做归一化。Muse 走的是第二条路。在 modular 文件里,Glimmer 的配置类甚至直接继承 Gemma2Config,再删掉其中的注意力软截断字段 attn_logit_softcapping。
MuseSparkTextAttention.forward 中的运算顺序如下,Glimmer 与之相同:
- 投影并拆分成 128 个 64 维的 query 头(32 × 128),以及 16 个 key 头和 16 个 value 头(2 个和 2 个)。
- 逐头归一化。 每个 query 头和 key 头都除以自身的均方根,$\hat{x} = x / \sqrt{\mathrm{mean}(x^2) + 10^{-5}}$,在 FP32 下计算。没有可学习权重;Q 和 K 共用同一个无权重模块。value 不做归一化。
- 只缩放 query,乘以
qk_scale_factor:Spark 为 5.4730064863875,Glimmer 为 3.87。配置的 docstring 称之为“在无权重 QK-norm 之后施加于 Q 的乘子,叠加在标准的1/sqrt(head_dim)注意力缩放之上”。 - 旋转(仅局部层)。 RoPE(§3.4)是旋转,不改变长度。
- 计算注意力,softmax 之前照常给 $q \cdot k$ 乘上 $1/\sqrt{d}$。
第 2 步之后,一个 RMS 为 1 的 $d$ 维向量长度为 $\sqrt{d}$,所以两个这样的向量点积为 $d \cos\theta$,其中 $\theta$ 是两者的夹角。记缩放因子为 $s$:
\[\text{logit} \;=\; \frac{(s\,\hat{q}) \cdot \hat{k}}{\sqrt{d}} \;=\; \frac{s\, d \cos\theta}{\sqrt{d}} \;=\; s\sqrt{d}\,\cos\theta .\]Spark:$5.4730064863875 \times \sqrt{64} = 43.7840518911$。Glimmer:$3.87 \times \sqrt{128} = 43.7840518911$(推算)。两份配置存的数字不同,表达的却是同一件事:两个模型中每个注意力 logit 都是 $43.784 \cos\theta$,因此始终落在 −43.784 到 +43.784 之间,不论隐藏状态有多大。如果把它看成作用在原始归一化点积上的缩放,就是 $43.784/d$:Spark 为 0.684,Glimmer 为 0.342(推算)。这个固定的乘子,就是本节标题里说的“温度”。严格地说,它是温度的倒数:它乘在 logit 上,而 softmax 的温度是拿来除 logit 的,所以这个值越大,注意力就可以越尖锐。
举个例子:在 Spark 的一个头里,让归一化后的 query 和 key 指向同一方向。两者长度都是 8,点积为 64,64 × 5.473 × 1/8 = 43.78。夹角为 60°(cos θ = 0.5)时,logit 为 21.89。在 Glimmer 的一个头里,方向一致时是 128 × 3.87 × 1/√128 = 43.78,还是同一个值:头宽了一倍,上限不变。
这个上限并不会让注意力变“软”。完全对齐的 key 比正交的 key 权重大 $e^{43.78} \approx 1.0 \times 10^{19}$ 倍;cos θ = 1 和 0.9 的两个 key,未归一化的权重也相差约 80 倍(推算)。上限只是防止 logit 无限增长。这里有一个已知的权衡:Cohere 的《Rope to Nope and Back Again》(arXiv 2501.18795)发现,QK-norm 让 logit“在分布上更平坦”,损害了大海捞针式的检索,作者因此去掉了它。我们的理解是:Muse 保留了 QK-norm,但把 logit 缩放定得很大(相当于很低的 softmax 温度),上限 43.784 接近 Gemma 2 的截断值 50,所以尖锐的注意力仍然可以实现。
两个模型共用 43.784 是巧合吗?公开的训练代码表明不是。TorchTitan 的 Muse Spark flavors 文件定义了 _SCALE_QUERY_NUMERATOR = 43.7840518911,注释写着“q-norm 之后,query 乘以这个调好的常数除以 sqrt(head_dim)”。816B 的 flavor 设 query_scale=_SCALE_QUERY_NUMERATOR / math.sqrt(64);文件里那个小型的 debugmodel flavor 用 head_dim=32,同一个分子改为除以 math.sqrt(32)。Glimmer 的配置只存了 3.87;说它就是同一个常数除以 √128,是我们自己算出来的:$3.87 \times \sqrt{2} = 5.4730064863839$,与 Spark 的值相差不到 $3.6 \times 10^{-12}$。
什么样的规则会得出这个常数?llama.cpp 的转换脚本把这个乘子称为“MetaP 缩放”(这是贡献者的注释);Meta 的 Llama 4 博客介绍 MetaP 时说,它用来设定“逐层的学习率和初始化尺度”,这些取值“在不同的批大小、模型宽度、深度和训练 token 数之间都能很好地迁移”。我们的理解是:head_dim 变化时保持 $s\sqrt{d}$ 不变,看起来正是这样一条迁移规则;由此得到的 $43.784/d$,就是最大更新参数化(µP,arXiv 2203.03466)中“用 1/d 而不是 1/√d 的注意力”,只是前面多了一个调好的常数。µP 把初始化尺度、学习率和各种乘子都设成模型宽度的函数,让在小模型上调好的超参数可以直接沿用到大模型上,这种注意力缩放就是它的规则之一。§5.4 对输出层也做了同样的解读。
一个更早的设计能让这个对比变得精确。QKNorm(arXiv 2010.04245)“沿头维度做 ℓ2 归一化”,并“乘以一个可学习参数,而不是除以嵌入维度的平方根”。RMS 归一化后的向量是 ℓ2 归一化向量的 √d 倍,所以 Muse 就是把这个参数冻结在 43.784 的 QKNorm(推算)。
实现细节
- 代码:
self.qk_norm = MuseSparkRMSNorm(eps=config.rms_norm_eps, with_scale=False),然后是query_states = self.qk_norm(query_states) * self.qk_scale_factor和key_states = self.qk_norm(key_states)。这个归一化在 FP32 下计算hidden_states * torch.pow(mean_squared, -0.5),再转回原精度(各种 RMSNorm 变体见 §5.3)。 - softmax 的缩放仍是
self.scaling = self.head_dim**-0.5(0.125 或 0.0884);eager kernel 计算torch.matmul(query, key_states.transpose(2, 3)) * scaling,softmax 用 FP32。Glimmer 的 modular 文件删掉了 Gemma 2 的query_pre_attn_scalar,以及父类 AFMoE 中带可学习权重的归一化(del self.q_norm、del self.k_norm)。 - 缓存更新发生在归一化和 RoPE 之后,所以缓存里的 key 每个头的 RMS 都是 1。
- 归一化前的向量很小时,eps 会让上限略微降低。如果 query 和 key 归一化前的均方都是 $m$,上界就变成 $43.784\, m/(m + 10^{-5})$:$m = 1$ 时为 43.7836,$m = 10^{-4}$ 时为 39.80(推算)。对随机方向而言,典型 logit 的分散幅度约为 $s$:Spark 为 5.47,Glimmer 为 3.87(推算,近似值)。上限相同,典型分散幅度不同。
- Transformers 的 Llama 4 代码只在 RoPE 层上对 query 和 key 做归一化(
if self.config.use_qk_norm and self.use_rope);Muse 在每一层都做。 - llama.cpp 的转换脚本把这个乘子折进合成出来的归一化权重:Q-norm 权重全部填成
qk_scale_factor,K-norm 权重全为 1,“这样计算图里保留的仍是朴素的 1 / sqrt(head_dim)”。
3.3 输出门控(以及 Spark 的输出归一化)
输出门控换来了什么?Spark 又为什么要在它前面加一个归一化?最接近的公开研究(Qiu et al.,见下文)发现,这样的门控能改善困惑度和训练稳定性,并缓解注意力汇点;我们的理解是,Spark 额外加的 o_norm 让门控独自决定每个头“说话的音量”。
softmax 加权求和之后,Muse 的每个注意力层都会把拼接起来的各头输出乘以一个 sigmoid 门控(门控由该层的输入算出),然后再做输出投影(Spark 多一步,放在本小节末尾介绍):
\[y \;=\; W_O\big(\,\mathrm{attn}(x) \odot \sigma(W_G\, x)\,\big).\]有三个细节值得注意。第一,门控读的输入与 $q$、$k$、$v$ 相同:来自块内 input_layernorm(§2.1)的前置归一化隐藏状态 $x$,而不是注意力输出。第二,它是逐元素的:拼接后的各头有多少个通道,gate_proj 就有多少个输出,即 8,192(4,096),所以每个头的每一维都有自己的门,而不是每个头共用一个标量。第三,它位于注意力和 o_proj 之间。
举个例子:Spark 的第 200 号通道是第 3 号头的第 8 维(从 0 开始数,3 × 64 + 8)。假设这个头在两个相邻 token 上都在这里输出 0.8。第一个 token 的门控 logit 是 −2,σ(−2) = 0.119,传给 o_proj 的是 0.095。第二个 token 的 logit 是 +2,σ(2) = 0.881,传下去的是 0.70。头的输出相同,门却不同:门控按 token、按通道决定有多少信号到达 o_proj,并由此进入残差流。
门控并不便宜:如下表所示,gate_proj 和 q_proj 一样大。
| 输出门控(由形状推算) | Spark | Glimmer |
|---|---|---|
| 每个解码器块的参数量 | 67,108,864 | 27,262,976 |
| 占注意力参数的比例 | 30.8% | 32.0% |
| 全部解码器块合计 | 4.16B(占 42.78B 激活参数的 9.7%) | 1.42B(占 25.17B 的 5.6%) |
| 每 token 每块的矩阵乘 FLOPs(每个权重 2 次) | 134.2M | 54.5M |
下面来看支撑开头那个答案的证据。Glimmer 报告写道“全程使用门控注意力”,Spark 的模型卡则列出“门控注意力:是(注意力块上有输出门控和输出归一化;启用 QK-norm)”。最接近的公开研究是 Qiu et al. 的《Gated Attention for Large Language Models》(2025):他们在 3.5 万亿 token 的数据集上训练 15B MoE 和 1.7B 稠密模型,对“30 种变体做了全面比较”。核心发现是:“在缩放点积注意力(SDPA)之后施加一个按头区分的 sigmoid 门控,能稳定地提升性能。这一改动还增强了训练稳定性,能容忍更大的学习率,并改善缩放特性。”他们的门控是 $Y’ = Y \odot \sigma(XW_\theta)$,有一条脚注与 Muse 对输入的选择一致(“我们采用前置归一化之后的隐藏状态作为 X”);按困惑度排名最好的变体“SDPA Elementwise G1”与 Muse 的形态相同:逐元素、按头区分、sigmoid。
论文给出两个解释。一是非线性:没有门控时,一个头的贡献是 $\sum_j S_{ij}\, x_j W_V W_O$,其中 $S_{ij}$ 是 query $i$ 在 token $j$ 上的 softmax 权重,$x_j$ 是 token $j$ 归一化后的输入,所以 $W_V W_O$ 相当于一个低秩线性映射(秩至多为 head_dim),而 GQA 让一组头共用 $W_V$ 时,限制还会更大;在两者之间加入非线性,可以提升表达能力。二是稀疏性:学到的门控值大多接近零(平均分数 0.116),所以一个头在没什么可补充时,可以几乎什么都不输出。论文把这一点和注意力汇点联系起来。softmax 权重之和必须为 1,所以即使一个头没有任何有用的东西可读,也得把权重放在某处;StreamingLLM 观察到,模型会把很强的注意力放在开头的几个 token 上,“即使它们在语义上并不重要,也把它们当作‘汇点’”。Qiu et al. 发现,“这种稀疏门控机制缓解了‘注意力汇点’,并提升了长上下文外推性能”。在他们用 400B token 训练的 15A2B MoE(总参数 15B,激活 2.54B)上,门控把平均困惑度从 6.026 降到 5.761,第一个 token 获得的注意力占比从 0.467 降到 0.048,最大隐藏状态激活值(按层平均)从 1,053 降到 94。这些是 Qiu et al. 的模型,不是 Muse。
在 Muse 中,汇点这一条比一般情况更重要(我们的理解)。和 DeepSeek-V4 不同(DeepSeek-V4 那篇,§3.4),Muse 没有可学习的汇点 logit。而在局部层里,一旦 query 位于序列第一个 token 之后 2,048 个位置,第一个 token 就落出了窗口,所以固定的汇点 token 并不总是可见。在 Spark 里,o_norm(见下文)把每个头的输出固定在 RMS 1,门控就成了一个头“什么都不说”的唯一途径。Glimmer 的头还可以学着去读接近零的 value,不过在 Glimmer 里,门控同样是唯一内置的“静音开关”。
Spark 的输出归一化。 Spark 在注意力和门控之间插入了输出归一化 o_norm:一个无权重 RMSNorm,分别作用在每个头的 64 维输出上。顺序变成注意力 → 逐头 o_norm → × σ(gate) → o_proj,因此每个头的输出在被门控缩放之前,RMS 都是 1(长度为 8)。
这为什么有帮助?我们的理解是:一个头的输出是 value 向量的加权平均,它的长度携带着一个偶然的信号。集中的注意力会保留 value 的长度,而分散在不相似 value 上的注意力会让长度缩小。拿两个正交的单位 value (1, 0) 和 (0, 1) 来说,集中时输出长度为 1,平均分配得到的 (0.5, 0.5) 长度只有 0.71。o_norm 丢掉长度、保留方向,于是一个头“说话的音量”完全由门控决定。Qiu et al. 在同一位置单独测试过逐头 RMSNorm(他们表 3 中的“SDPA GroupNorm”一行):平均困惑度 5.847,而基线为 6.026,门控为 5.761。RetNet(arXiv 2307.08621)的顺序与 Spark 相同,先逐头归一化再门控,只不过用的是 GroupNorm 和 swish,而 Spark 用的是无权重 RMSNorm 和 sigmoid。
实现细节
- 代码:
self.gate_proj = nn.Linear(config.hidden_size, config.num_attention_heads * self.head_dim, bias=False)。forward中依次是attn_output = self.o_norm(attn_output).reshape(*input_shape, -1).contiguous()、attn_output = attn_output * torch.sigmoid(self.gate_proj(hidden_states))和self.o_proj(attn_output)。Glimmer 的对应代码里没有self.o_norm。 - 为什么是逐头:注意力后端返回
[batch, seq, heads, head_dim],o_norm在 reshape 之前运行,作用在每个头的 64 个数上。llama.cpp 把这一点写得很明确(“对注意力输出做无权重归一化,逐头施加”):先 reshape 成[n_embd_head, n_head, n_tokens],再调用ggml_rms_norm。 - 来历:modular 文件里写的是
class MuseGlimmerTextAttention(AfmoeAttention),所以门控的代码继承自 Arcee 的 AFMoE 注意力(llama.cpp 的计算图注释写着“与 afmoe 相同”,并推迟wo,好让“门控位于 attn_out 与 o_proj 之间”)。 - 上界(推算):经过
o_norm和取值在 (0, 1) 之间的门控之后,o_proj看到的向量长度至多为 √8,192 ≈ 90.5。 - 在块的后半段,Spark 接一个无权重的注意力后置归一化和一个残差门,Glimmer 接一个带权重的后置归一化和普通的加法(§5)。
3.4 局部层用 RoPE,全局层用 NoPE
位置信息从哪里进入模型?只从局部层。§2.2 给出了层的排布:每三个局部层配一个全局层,全局层“从最后一层往回数,每 4 层一个”(Spark 的全局层是第 1、5、…、61 层;Glimmer 是第 3、7、…、51 层)。局部层和全局层的参数形状完全相同,区别只有两点:query 可以读哪些 key,以及 query 和 key 是否带位置。
局部层读一个滑动窗口,并使用 RoPE。在 Transformers 中,2,048 的窗口包含 query 自身:当 $i - 2048 < j \le i$ 时,key $j$ 对 query $i$ 可见,即 query 本身加上它之前的 2,047 个 token。RoPE(RoFormer)把 query 和 key 的每一对维度旋转一个与 token 位置成正比的角度,于是 query-key 分数只取决于两者的距离。两个模型都用基数 θ = 500,000,rope_type 为 “default”,Transformers 的 RoPE 工具把它描述为“原始的 RoPE 实现”:既不做线性缩放,也不用 YaRN(Peng et al. 提出的“高效扩展上下文窗口”的方法)。这两种都是常见做法,通过重新缩放 RoPE 的位置或频率,让模型能跑到训练长度之外。两个模型都旋转整个头:Spark 每个头 32 个频率对,Glimmer 每个头 64 个。
全局层读之前的所有 token,没有任何位置编码,即 NoPE。模型在每次前向传播中只算一次旋转表,并且只把它交给局部层;全局层收到的是 position_embeddings=None。
为什么这样分配位置信息?因为这样一来,长度扩展对旋转来说根本不成问题。RoPE 分数只取决于 query-key 距离,而在局部层里,不管文档多长,这个距离总在 0 到 2,047 之间。RoPE 层永远不会遇到训练时没见过的距离,全局层则根本没有需要外推的角度。我们的理解是,正因如此,Spark 的配置才能把 1,048,576 的 max_position_embeddings 和朴素、不加缩放的 RoPE 搭配在一起(§7.1)。Glimmer 报告的架构一节用一句话说明了它:RoPE“只用于局部注意力层;全局层依靠周围局部层累积下来的位置信号,这让模型可以扩展长度。”
没有位置的层怎么知道顺序?主要靠因果掩码。Haviv et al.(arXiv 2203.16634)发现,语言模型“即使不用任何显式位置编码,仍然有竞争力”,并推测“因果注意力让模型能推断出每个 token 可以关注的前驱 token 数量”。在推理和数学的长度泛化任务上,Kazemnejad et al.(arXiv 2305.19466)发现“NoPE 优于其他显式位置编码方法”。此外,Muse 的全局层读到的隐藏状态,已经被下面的 RoPE 层塑造过。(GLM-5.3 那篇的 §8.3 介绍的 GLM-5.3-Flash 走得更远,文本层里一层 RoPE 都没有。)
§2.2 提到了最接近的两个亲戚:Llama 4 的交错布局(Meta 称之为“iRoPE 架构”)和 Cohere 的 RNoPE-SWA。Muse 与它们有两处细节不同。Llama 4 加了“推理时对注意力做温度缩放”(Llama 4 博客),而且它的 Transformers 代码让 RoPE 层做 8,192 个 token 的分块注意力,而不是滑动窗口。Cohere 的 RNoPE-SWA(arXiv 2501.18795)和 Muse 一样,“把全注意力层放在每个交错组的末尾”,但窗口是 4,096 个 token,θ = 10,000。Muse 保留了这种分组形状,配上 2,048 个 token 的滑动窗口、θ = 500,000,并且不做温度缩放。用分块时,每块的第一个 token 看不到任何局部历史;用滑动窗口时,每个 token 都能看到至多 2,047 个前驱。
对 2,048 个 token 的窗口来说,θ = 500,000 很大。转得最快的一对维度每 6.3 个 token 转一圈,而 Spark 转得最慢的一对在整个窗口里只转 0.35°。Spark 的 32 对中只有 15 对(Glimmer 的 64 对中有 29 对)能在窗口内转满一圈,32 对中有 14 对(64 对中有 29 对)转动不到 90°(推算)。我们的理解是:转得最慢的那些维度对,在窗口内近似于不带位置的通道。每个头约四分之一的维度对,即 Spark 32 对中的 9 对(Glimmer 64 对中的 18 对),在整个窗口里转动不到 10°(推算)。Transformers 的 Llama 4 文本配置默认也用这个基数(default_theta = 500000.0)。
两个模型里同样没有的东西还有:可学习的汇点 logit、注意力 logit 软截断(唯一的软截断在最终的词表 logit 上,§5.4)、偏置、注意力 dropout(attention_dropout 为 0.0),以及任何随位置变化的温度。
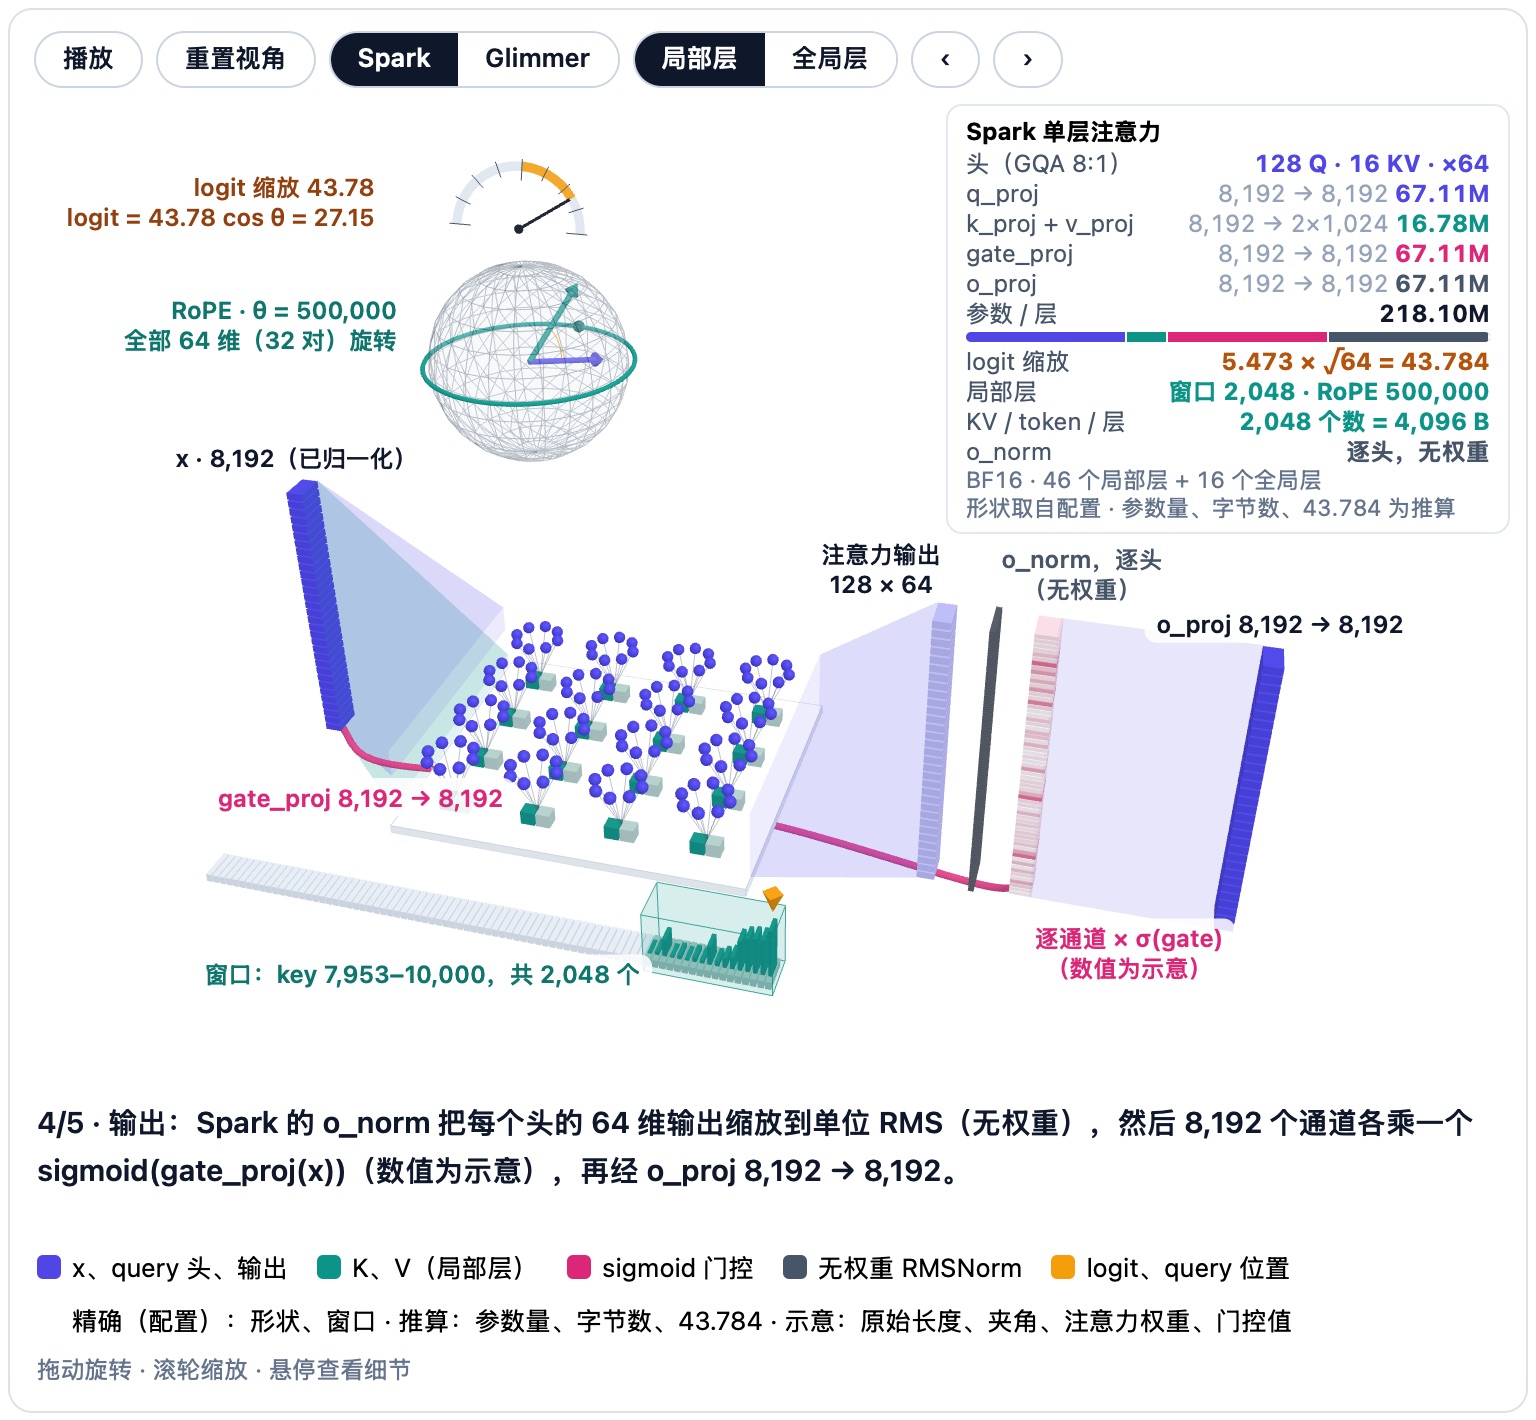
下面的动画把 §3.1–§3.4 串起来,演示一个 token 走完这一层,先列 Spark 的数值,括号里是 Glimmer 的。四步依次点亮:GQA 的扇出(每个 KV 头配 8 个 query 头;Glimmer 为 16 个);QK-norm 及其 query 乘子 5.473(3.87);只有局部层经过、全局层绕开的 RoPE 步骤;最后是完整路径,包括 Spark 的 o_norm 和 o_proj 之前的 sigmoid 门控。下方三张卡片重复了 logit 上界、每 token 缓存和参数量。

下面的 3D 模型分五步拆开同一层:GQA 的形状、QK-norm 及其共用的 logit 缩放、局部或全局的读取方式、门控(以及 Spark 的 o_norm),以及一个 token 在缓存里留下什么。在 Spark 和 Glimmer 之间切换,可以看到 query 头从每个 KV 头 8 个重组为 16 个。在“局部”和“全局”之间切换,RoPE 转盘和 2,048 个 token 的窗口带会换成 NoPE 标签和一整排之前所有 token 的 key。在 QK-norm 这一步里,归一化后的向量落在一个固定半径的球面上,上方是“logit 缩放 43.78”转盘:它就是 §3.2 中那个固定的 logit 乘子,也就是本节标题里说的“温度”(严格说是温度的倒数)。在门控这一步里,一条逐通道的数值带与注意力输出相乘。形状、参数量和字节数是精确的;注意力权重和门控值是合成数据。
实现细节
- 开关:
MuseSparkTextModel.forward中的position_embeddings=position_embeddings if self.config.layer_rope_theta[i] else None,以及注意力里apply_rotary_pos_emb之前的if position_embeddings is not None:。真正起作用的只是layer_rope_theta的真假:由rope_parameters["rope_theta"]构建的同一个rotary_emb服务所有 RoPE 层,所以在 v5.20.0 里,逐层的取值起的是开关的作用。已发布的配置中,每个非零项都是全局值 500,000,llama.cpp 的 Spark 转换脚本也对此做了断言:assert all(t in (0, theta) for t in hparams["layer_rope_theta"])。 - 掩码:模型一次性构建
create_causal_mask和create_sliding_window_causal_mask,再按layer_types为每层挑一个。滑动掩码是kv_idx > q_idx - sliding_window与kv_idx <= q_idx的组合(masking_utils.py);flash 后端拿到的是window_size = (sliding_window - 1, sliding_window - 1);滑动缓存在两步之间保留“最近self.sliding_window - 1个 token”。 - RoPE 的配对方式:Transformers 把第 $j$ 维与第 $j + d/2$ 维配对(
rotate_half);llama.cpp 把相邻两维配对,它的转换脚本会对 Q/K 权重的行做逆置换来对齐。它的计算图只在use_rope = hparams.is_swa(il)时旋转,基数固定为训练时的值,所以--rope-freq-base应该不会影响 Muse(我们的理解)。 - TorchTitan 的 Spark 注意力(model.py)支持在全局层上使用 Llama 4 式的温度
(log((positions + 1) / floor_scale) * query_scale + 1).clamp_min(1.0),但 816B 的 flavor 把这两个开关都设为None;该 flavor 的global_attention_layers=set(range(1, num_layers, 4))同样是 1、5、…、61。 - 按 Mistral 的论证,k 个窗口层可以把信息传递至多 k × W 个 token(arXiv 2310.06825),仅靠局部层,Spark 就能覆盖 46 × 2,047 = 94,162 个 token,Glimmer 为 39 × 2,047 = 79,833 个(推算)。直接的长程读取则来自全局层。
3.5 Glimmer 试过又放弃的方案:在全局层用 MLA
全局层持有唯一随上下文增长的缓存,因此是进一步压缩的天然位置,Glimmer 团队也确实试过。报告的“面向端侧效率的设计”一节接着写道:“我们在全局层评估了一种简化的 MLA 变体……做法是投影出单个联合的键值向量。我们测试了两种配置:与基线的头数相同(KV cache 减半),或与基线的 KV 总占用相同(头数加倍)。两者在 RULER……等长上下文基准上都不如标准的 GQA……因此我们保留了 GQA。”
MLA 出自 DeepSeek-V2,每个 token 每层只缓存一个压缩后的潜在向量(“低秩键值联合压缩”),再从中重建每个头的 key 和 value;GLM-5.3 那篇的 §3 详细讲解过它。标准 MLA 还带一个单独的 RoPE key,因为随位置变化的旋转会挡住解码时把 key 上投影并入 query 的技巧(那篇的 §3.3)。Muse 的全局层没有 RoPE,所以这部分没有必要;我们的猜测是,这正是“简化”的部分含义。Muse 的逐头 QK-norm 也会带来类似的合并问题,因为对每个重新展开的 key 做归一化不是线性运算。
报告点名的 RULER 是一套合成的长上下文测试,包含检索、多跳追踪和聚合任务。自己算一笔账,就能看出这件事的分量。Glimmer 的一个全局层每 token 缓存 512 个数,所以与头数对齐的变体大约缓存 256 个。在 131,072 个 token 时,13 个全局层共占 1.625 GiB,减半约能省下 0.81 GiB(推算):确实有收益,但在 32 GB 的预算里不算多。只有全局层能直接读到 2,047 个 token 之外,长程检索要靠它们;在这次消融里,压缩恰恰是在这里损害了质量。Spark 沿用了同样的 GQA 设计,用 16 个 KV 头。
注意力是两个模型几乎一模一样的部分;§4 转向两者差别最大的模块。
4. Spark Open 的 MoE:256 个专家,工作在 4,096 维的潜空间里
Glimmer 每层是一个稠密 FFN,Spark 则在全部 62 个解码器块里都放了 MoE 层。表面上的数字并不陌生:256 个路由专家,每个 token 用 8 个,和 DeepSeek-V3 是同一组搭配。新意在于专家“住”在哪里。路由器对 token 完整的 8,192 维向量打分,一个投影把这个向量压成 4,096 个数,被选中的 8 个专家完全在这个宽度上工作,再由第二个投影把结果拉宽回去。Transformers 代码说这个模块先“降维”(pool)、再“升维”(unpool);llama.cpp 和 NVIDIA 把这种结构称为潜空间 MoE。(这里的“潜空间”指专家工作的那个降维后的 4,096 维空间,与 §3.5 中 MLA 压缩后的 KV 潜在向量无关。)本节按顺序把这个模块拆开,最后回到 Glimmer 报告回答过的那个问题:小模型为什么干脆不用专家。
4.1 用数字看一层
一个 MoE 层有多大,一个 token 又用到其中多少?它有 12.95B 参数,一个 token 用到其中的 471.87M,占 3.6%(推算)。MoE 层把一个大的前馈网络换成许多小网络,也就是专家,再加一个路由器,把每个 token 送往其中少数几个;GLM-5.3 那篇文章(§4)讲解了这些基础知识。下表列出 Spark 的各项尺寸、它们在 config.json 中对应的键(取自 mlx-community 公开的 MLX 转换版本,与 Transformers 默认值一致),以及我们统计的参数量。
| 每个解码器块 | 数值 | 键或公式 |
|---|---|---|
| 路由专家 | 256 | num_local_experts |
| 每个 token 的专家数 | 8(top-8) | num_experts_per_tok |
| 共享专家 | 0 | num_shared_experts(Transformers 忽略该键;§4.5) |
| 含 MoE 的块 | 全部 62 个 | mlp_layer_types = 62 × "sparse" |
| 路由器输入宽度 | 8,192 | hidden_size |
| 潜空间宽度(每个专家的输入与输出) | 4,096 | moe_hidden_size |
| 专家(SwiGLU) | 4,096 → 2 × 4,096 → 4,096 | moe_intermediate_size = 4,096 |
| 单个专家参数量(推算) | 50,331,648 | $3 \times 4{,}096 \times 4{,}096$ |
| 全部 256 个专家(推算) | 12,884,901,888 | $256 \times 50{,}331{,}648$ |
| 路由器、两个投影、两个归一化(推算) | 69,214,208 | $256 \times 8{,}192 + 2 \times 8{,}192 \times 4{,}096 + 2 \times 4{,}096$ |
| MoE 合计(推算) | 12,954,116,096(12.95B) | |
| 每个 token 激活(推算) | 471,867,392(471.87M),3.64% | 8 个专家 + 路由器 + 投影 + 归一化 |
| 全部 62 个块(推算) | 总计 803.16B,激活 29.26B | 分别占解码器块参数总量 816.68B 与激活量 42.78B 的 98.3% 和 68.4% |
用一组对比就能看清这张表的分量(推算)。Glimmer 的稠密 SwiGLU(6,656 → 19,968 → 6,656)有 398.72M 参数,是 Spark 8 个激活专家 402.65M 参数的 0.99×。如果把路由器、两个投影和归一化也算上,Spark 的 MoE 每个 token 要用到 471.87M 参数,是 Glimmer FFN 的 1.18×。所以两个模型在每个 token 上花的 FFN 计算相近,但 Spark 每层存储的 FFN 权重是 Glimmer 的 32.5×(12.95B 对 398.72M)。§2.3 把这些数字放进了完整的参数拆分。
数字从哪来
moe_hidden_size的 docstring 写道:“MoE 模块在路由专家之前把hidden_size降维到这一宽度,之后再从这一宽度升维回去。专家完全在这一宽度上运行。”模型卡列出“专家数量:256”和“每个 token 激活的专家数:8(top-k 路由)”。- 这些统计不含每个路由器 256 项的
e_score_correction_bias,它是缓冲区而不是参数(§4.2)。§2.3 把 62 个块的总数 816,680,173,568 和 42,780,753,920 与官方的“总计 816B / 激活 42B”对上了账。
4.2 路由器:sigmoid 打分,偏置只管挑选
路由器把一个 token 的向量变成 8 个专家编号和 8 个权重。它读取的 $h$ 是本块 pre_feedforward_layernorm(一个中心化 RMSNorm,§5.3)的输出,宽度是完整的 8,192,而不是潜空间宽度。步骤依次是:
- 用 FP32 打分。 把 $h$ 和路由矩阵 $W_r$(256 × 8,192)都转成 float32,再相乘。
- 缩放。 把 256 个 logit 乘以输出乘子
output_multiplier= 0.17678 = $1/\sqrt{32} = 1/\sqrt{8{,}192/256}$。配置的 docstring 把这个字段描述为语言模型输出层的 logit 在软截断之前的缩放系数;路由器复用了它。§5.4 讨论 $1/\sqrt{d/256}$ 这条规则,以及为什么路由器也是适用这条规则的一种读出层(我们的理解)。 - 挤压。 对每个 logit 单独施加 sigmoid,得到 $s_i \in (0, 1)$。与 softmax 不同,一个专家的分数不会压低另一个专家的分数。
- 挑选。 给每个专家加上各自的偏置 $b_i$,保留 $s_i + b_i$ 最大的 8 个。全部 256 个专家在同一个池子里竞争,没有按组或按节点限制的路由。
- 加权。 去掉偏置,用 8 个胜出者的原始分数除以它们的和(再加 $10^{-15}$),然后乘以
routed_scaling_factor= 1.0。
直白地说(数字为合成):专家 17 的原始 logit 为 2.77,乘子把它变成 0.49,sigmoid 再把它变成 $s = 0.62$;它的偏置是 −0.30,所以参与竞争的值是 0.32。专家 90 的原始 logit 为 −2.29,于是 $s = 0.40$,偏置为 +0.03,参与竞争的值是 0.43;尽管原始分数更低,它还是抢在专家 17 前面拿到了最后一个名额。假如 8 个胜出者的原始分数是 0.72、0.64、0.56、0.52、0.48、0.40、0.36 和 0.32,它们之和为 4.00,权重依次为 0.18、0.16、0.14、0.13、0.12、0.10、0.09 和 0.08;专家 90 得到 0.10。偏置决定了选谁,原始分数决定给多少。
由于缩放系数是 1.0,权重之和总是 1(误差不超过 $10^{-15}$),所以各专家的贡献构成一个凸组合(GLM-5.3 和 DeepSeek-V4-Pro 则把权重乘以 2.5)。乘子还把 sigmoid 拉平了 5.66 倍(推算):原始 logit 要达到 5.66,分数才能到 0.73。
为什么要偏置?放任不管的路由器往往会塌缩到少数几个“偏爱”的专家上;经典的解决办法是加一项惩罚负载不均的辅助损失,但这会牺牲一部分主目标。DeepSeek-V3 沿用 Wang et al.(arXiv 2408.15664)的做法,改为主要靠偏置来调节(“偏置项只用于路由”):每一步之后,把过载专家的偏置调低 γ,把负载不足专家的偏置调高 γ;前 14.3T 个 token 取 γ = 0.001,最后 500B 个 token 取 0。除了偏置,它只另外保留一项非常小的序列级均衡损失,权重为 0.0001。GLM-5.3 那篇文章(§4.3)讲解了这一思路。
对 Spark 而言,Transformers 代码只是使用这个偏置。e_score_correction_bias 是一个初始化为全零的 nn.Buffer:它不接收梯度,不计入 816,680,173,568 个参数,以 FP32 保存。代码里既没有更新规则,也没有辅助损失;前向过程只计算语言模型损失。更新规则写在 TorchTitan 的 Muse Spark Open 实现(TorchTitan 是 PyTorch 的训练库)的 README 里:“专家偏置根据 token 计数更新,从而在不用辅助损失的情况下均衡专家的使用。每次更新都减去均值,系数为 1e-3。”它的通用 MoE 代码在每次优化器更新之前执行下面的更新,其中 $n_i$ 是专家 $i$ 收到的 token 数,$\bar n$ 是它们的均值:
在强化学习(RL)阶段,Miles 配方训练时会重放 rollout 期间选中的专家(rollout 路由重放,Rollout Routing Replay,§9.3)。
实现细节:代码中的路由器
- 在 modular 文件中,
class MuseSparkTopkRouter(MiniMaxM2TopKRouter)重写了前向过程,但保留了 MiniMax-M2 的 sigmoid、只用于挑选的偏置和重新归一化,并写明了自己的改动:“与 MiniMaxM2 不同:在线性投影之前转换为 float32,并乘以输出乘子。”以及“与 MiniMaxM2 不同:给 top-k 概率加上 eps,并乘以路由缩放系数。”它还把偏置移进了路由器,写作nn.Buffer(torch.zeros(self.num_experts))。 - 生成的建模文件在
routing_weights + self.e_score_correction_bias上用torch.topk(scores_for_choice, k=self.top_k, dim=-1, sorted=False)挑选,再用routing_weights.gather(1, topk_indices)取出权重。与 HF 的 DeepSeek-V3 路由器不同,这里没有topk_group掩码。 _keep_in_fp32_modules_strict列出了"mlp.gate.weight"和"e_score_correction_bias",所以模型其余部分以 BF16 加载时,路由器仍保持 FP32。Hub 为 BF16 仓库列出的 F32 数值有 130,039,296 个(HF API),恰好等于 $62 \times (256 \times 8{,}192 + 256)$(§2.3)。- llama.cpp 在转换时把乘子折进路由器权重(“把它折进权重,保持一次普通的矩阵乘”),重新归一化时把分母钳在 $\ge 6.1035 \times 10^{-5}$,而不是加上 $10^{-15}$。TorchTitan 单独保留一个
router_logit_multiplier,取值 $1/\sqrt{32}$;Transformers 则复用同一个字段。
4.3 降维、计算、升维
路由器决定选谁,模块的其余部分负责计算。对 $T$ 个 token,$h$ 的形状为 [T, 8,192],MuseSparkMoE.forward 依次执行:
- 降维。
pre_expert_proj是一个所有专家共用、不带偏置的 8,192 → 4,096 线性层,把每个 token 映射成 4,096 个数;每个 token 只做一次,而不是每个专家各做一次。 - 归一化。
pre_expert_norm对这 4,096 个数做中心化 RMSNorm(§4.4),得到潜向量 $z$。 - 分发。 每个 token 的 $z$ 被送往它的 8 个专家。
- 专家计算。 专家 $i$ 用三个 4,096 × 4,096 的矩阵计算 $E_i(z) = W_{\text{down}}^{(i)}\big(\mathrm{SiLU}(W_{\text{gate}}^{(i)} z) \odot W_{\text{up}}^{(i)} z\big)$。
- 逐个归一化输出。
post_expert_norm是一个先缩放后归一化的 RMSNorm,只有一个 4,096 维的权重,由全部 256 个专家共用;它把每个专家的输出都调整到单位 RMS(§4.4)。 - 合并。 乘以 $g_i$,把 8 个输出相加,得到 [T, 4,096]。
- 升维。
post_expert_proj,不带偏置,4,096 → 8,192。之后,块再依次施加post_feedforward_layernorm和残差门(§5.2)。
在这个模块内部,只有路由器和两个投影接触 8,192 的宽度。每个专家读写的都是 4,096 维向量,GPU 之间的专家并行交换传输的也是 4,096 维向量。
为什么要压缩?在标准 MoE 中,专家的输入和输出都处在模型宽度上,所以它的三个矩阵各有一条边长为 8,192。降维把这条边减半,带来三方面影响(数字由我们推算):
- 同样大小,专家更宽。 一个 50.3M 参数的专家,内部宽度可以是 4,096 而不是 2,048,于是 8 个专家为每个 token 提供 8 × 4,096 = 32,768 个 SwiGLU 隐藏单元,而不是 16,384 个。LatentMoE 论文把这称为“每个 token 的有效非线性预算”:激活专家数乘以专家的中间宽度(按论文记号为 $U_{\text{eff}} \propto K \cdot m$)。
- 通信量减半。 在专家并行(EP)下,专家分布在不同的 GPU 上,每个 token 的向量要通过 all-to-all 交换发往其专家所在的 GPU(分发,dispatch),再传回来(合并,combine)。Spark 传的是潜向量:按 HF 分发器的做法,每个(token,专家)对发送一份 BF16 副本,单程为 $8 \times 4{,}096 \times 2$ B = 64 KiB,因此每个 token 每层往返共 128 KiB,62 层合计 7.75 MiB,是 8,192 维的行所需流量的一半。如果系统发送 8 位浮点(FP8)数值或按节点去重,传输的字节会更少,但 2 倍的比例不变。
- 代价。 两个投影每层共有 $2 \times 8{,}192 \times 4{,}096 = 67{,}108{,}864$ 个参数,而且全部处于激活状态:占本模块激活 FFN 参数的 14.2%,每个 token 每层要多花 134 MFLOP。此外,专家只能通过一个学出来的 4,096 维投影看到 token。LatentMoE 报告称,只要专家数按同样的倍数增加,压缩比不超过 4 时模型质量都能保持;在一个总参数 16B、压缩比为 4 的消融实验中,如果专家数保持不变,则“会导致明显的质量下降”。Spark 的压缩比是 2,专家数仍是 256,论文没有测试过这种组合。
这样做换来了多少?下表把 Spark 与两个并不存在的设计做比较,数字都从同一份配置算出。记专家数 $E$ = 256,每个 token 的专家数 $k$ = 8,专家中间宽度 $m$ = 4,096。设计 A 保持 $E$、$k$ 和 $m$ 不变,但让专家在完整的 8,192 宽度上运行;设计 B 则保持单个专家的大小不变,改为把 $m$ 减半。
| 除注明外均为每层数字(推算;A 和 B 不是真实模型) | Spark Open(潜空间 4,096) | A:不降维,$E$、$k$、$m$ 相同 | B:不降维,专家大小相同 |
|---|---|---|---|
| 专家形状 | 4,096 → 2 × 4,096 → 4,096 | 8,192 → 2 × 4,096 → 8,192 | 8,192 → 2 × 2,048 → 8,192 |
| 单个专家参数量 | 50.3M | 100.7M | 50.3M |
| 全部 256 个专家 | 12.88B | 25.77B | 12.88B |
| 每个 token 激活的 MoE 参数 | 471.9M | 807.4M | 404.8M |
| 每个 token 的 MoE FLOPs(激活参数的 $2 \times$) | 943.7 MFLOP | 1,614.8 MFLOP | 809.5 MFLOP |
| 每个 token 的 all-to-all 流量(BF16,往返) | 128 KiB | 256 KiB | 256 KiB |
| 每个 token 的 SwiGLU 隐藏单元数($k \times m$) | 32,768 | 32,768 | 16,384 |
| 62 层专家:总量 / 激活 | 798.9B / 24.96B | 1,597.7B / 49.93B | 798.9B / 24.96B |
| 62 层解码器块:总量 / 激活 | 816.68B / 42.78B | 1,611.38B / 63.58B | 812.52B / 38.62B |
与 A 相比,降维让每个专家的各项开销都减半,把一个 1.61T 参数的设计变成了 816.68B 的模型,激活参数也从 63.58B 降到 42.78B。B 是总规模相同的常规 MoE;与它相比,Spark 的专家参数和专家 FLOPs 相同(由于多了两个投影,整个 MoE 的开销是 943.7 对 809.5 MFLOP),每个 token 的隐藏宽度是它的两倍,通信量是它的一半,代价是多出 4.16B 参数,而且全部处于激活状态。
这种模式有论文可查。NVIDIA 的 LatentMoE(2026 年 1 月)做了同样的三项选择:路由权重“由原始 token 计算”,专家“完全在潜空间内”运行,分发也在潜空间中进行,从而“把通信量降为原来的 1/α”,其中 $\alpha = d/\ell$ 是模型宽度与潜空间宽度之比,即压缩比。论文摘要说这一设计“已被旗舰模型 Nemotron-3 Super 和 Ultra 采用”(Nemotron 3,arXiv 2512.20856;Nemotron 3 Super,arXiv 2604.12374)。两者花这笔节省的方式不同。LatentMoE 把专家数乘以 α,在默认变体中把 top-k 也乘以 α,在保持每个 token 开销不变的同时增加专家组合;它选的是 α = 4。Spark 用 α = 2,并保留 DeepSeek-V3 的 $E = 256$、$k = 8$。我们的理解是,Spark 把节省下来的部分直接“存”了起来:相比 A 是更便宜的模块,相比 B 是更宽的专家。此外,LatentMoE 用 softmax 路由,共享专家保持全宽,公式里也没有归一化。
下面的动画沿用 §4.2 中的合成路由数字,跟随一个 token 走完这个模块。请留意宽度:路由器和两个投影处是 8,192,凡是涉及专家的地方都是 4,096;每个被选中专家的输出都要先经过同一个共用的归一化,然后才乘上权重。最后一步会加一个面板,列出潜空间设计和设计 A 的每层数字。

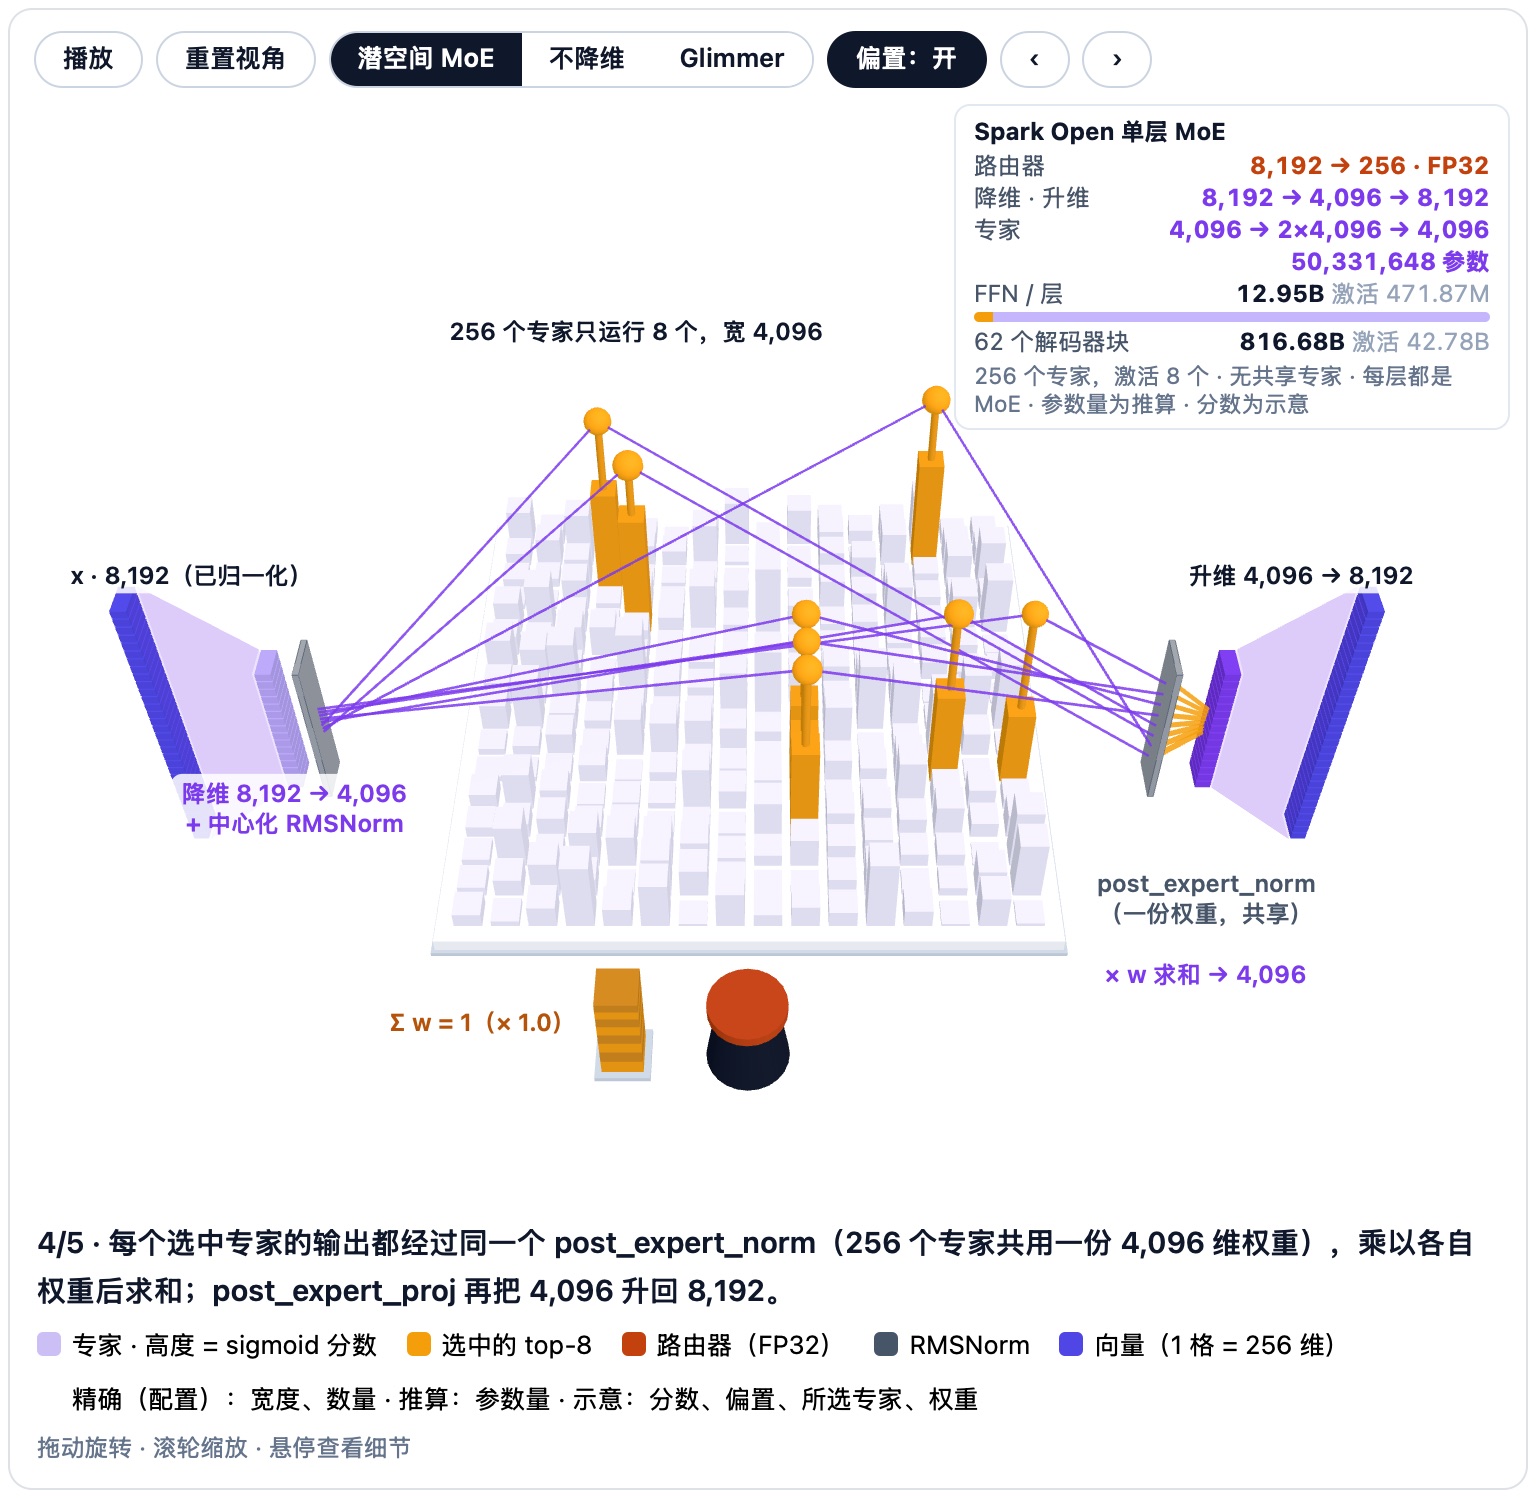
3D 模型展示的是同一个模块,256 个专家排成 16 × 16 的塔阵。先逐一走完五步,再把偏置关掉:胜出者会变,权重却依然来自不含偏置的分数。切换到“不降维”(设计 A),可以看到每个专家都翻倍,62 层的专家参数从 798.9B 涨到 1.6T;切换到 Glimmer,则只剩一个 6,656 → 19,968 → 6,656 的稠密模块。数量和形状是精确的;分数、偏置和选择结果是合成的。
实现细节:形状、存储与并行方案
MuseSparkMoE.forward先在 8,192 维的输入上调用路由器(_, topk_weights, topk_indices = self.gate(hidden_states)),再依次调用self.pre_expert_proj、self.pre_expert_norm、self.experts(hidden_states, topk_indices, topk_weights)和self.post_expert_proj。MuseSparkExperts(DeepseekV3Experts)设置self.hidden_dim = config.moe_hidden_size,并把专家存成两个三维张量:gate_up_proj[256, 8,192, 4,096](gate 的行在前)和down_proj[256, 4,096, 4,096],供integrations/moe.py中的 grouped-GEMM kernel 使用。与 DeepSeek-V3 的专家循环相比,只改了一行,标注为“与 DeepseekV3 不同,后者没有专家后归一化”。照字面读,modular 文件的__init__会先按 8,192 的宽度分配,然后再覆盖;生成的建模文件则直接按 4,096 分配,与 llama.cpp 一样。MuseSparkTextConfig中的并行方案:EP 下,两个专家张量都沿专家维切分("grouped_gemm"),用"ep_dispatch_experts"搬运 token,共用的归一化权重则复制到各卡("replicated_with_grad_allreduce");张量并行(TP)下,两个投影都标为"rowwise_split_input"(切片矩阵乘,再 all-reduce)。路由器没有对应条目,所以(我们的理解)每个 rank 都各自计算它。- 其他实现里的名称:llama.cpp 叫
ffn_latent_down/ffn_latent_up(GGUF 键为moe_latent_size,注释写道“路由器读取的是完整的流,而不是潜空间那一路。”);TorchTitan 叫pooler/unpooler;mlx-lm 的注释是“专家在两个投影之间、以压缩后的宽度运行。”Megatron-LM 有一个--moe-latent-size选项。HF 的专家并行路径在运行本地专家时“采用 top-1 路由和单位权重;合并之后再施加路由权重”,这保证了专家后归一化排在权重之前。
4.4 MoE 内部的归一化
Spark 在 MoE 内部加了两个归一化,DeepSeek-V3 和 LatentMoE 都没有。看得见的效果来自专家之后的那一个:每个被选中专家的输出到达时长度都相同,所以它在总和中的份额恰好就是它的路由权重,kernel 也必须在归一化之后才施加这个权重。两者宽度都是 4,096,都采用 $(1 + w)$ 的增益约定,$w$ 初始化为 0(§5.3 比较了几种 RMSNorm 变体)。
pre_expert_norm 是一个中心化 RMSNorm(eps 为 $10^{-5}$):先归一化,再乘以 $(1 + w)$。无论 pre_expert_proj 学到什么尺度,专家看到的都是单位 RMS 的输入乘以逐通道增益。
post_expert_norm 是一个先缩放后归一化的 RMSNorm(eps 为 $10^{-8}$),顺序反了过来:先乘增益,再归一化:
无论 $w$ 取何值,输出的 RMS 都是 1;增益只改变哪些通道主导输出的方向。每层只有一个这样的模块,即一个 4,096 项的权重,作用于每个专家的输出:EP 方案复制它,llama.cpp 的 ffn_post_exp_norm 形状为 {4,096},mlx-community 公开的权重索引里恰好有 62 个这样的张量,每层一个。
这样一来,账目就很干净(数字为推算,解读是我们的理解)。每个被选中专家的输出到达加权这一步时,长度都是 $\sqrt{4{,}096} = 64$,所以专家无法靠更大的激活值来扩大影响;它在总和中的份额恰好是 $g_i$。权重之和为 1,因此合并后的潜向量 RMS 至多为 1,只有当 8 个输出方向完全一致时才等于 1。经过 post_expert_proj 之后,post_feedforward_layernorm(又一个先缩放后归一化的 RMSNorm)在残差门之前把这条支路恢复到单位 RMS(§5.2)。
我们找到的最相近的设计是 Megatron-LM 的可选项 moe_use_norm_before_up_proj,它在合并之后只做一次归一化,而不是逐个专家做。
专家后归一化有系统层面的代价。归一化会抹掉在它之前施加的任何缩放,所以路由权重必须放在归一化之后;它不能像 DeepSeek-V4 参考代码那样,在 down 投影之前折进专家的激活值(DeepSeek-V4 那篇文章,§8.4)。它还需要每个专家完整的 4,096 维输出:mlx-lm 的张量并行把每个专家切到多个设备上,因此要先把各部分输出加起来(“在专家后归一化之前先对专家输出求和”)。SGLang 发布博客解释说,这个顺序“很重要,因为对合并后的输出做归一化会改变模型的计算”,并把“在按路由加权求和之前对每个专家做 RMS 归一化”列为其融合 MoE kernel 必须支持的功能之一。
4.5 缺了什么
MoE 模型里常见的两个部件在 Spark 中缺席,代码对两者都写得很明确。第三处缺席出现在量化版本中。
没有共享专家。 DeepSeek-V3、GLM-5.3 和 Llama 4 Maverick(据 Llama 4 博客,有“128 个路由专家和一个共享专家”)都在路由专家旁边运行一个始终参与的专家。Spark 的 config.json 写着 num_shared_experts: 0,但 Transformers 和 llama.cpp 的代码都不读这个键,MuseSparkMoE 也没有共享专家模块;mlx-lm 遇到任何非零值都会拒绝,TorchTitan 则会报错“Muse Spark MoE 不支持共享专家”。
没有稠密层。 DeepSeek-V3 和 GLM-5.3 开头有几层稠密前馈层,Llama 4 Maverick 则让稠密层与 MoE 层交替出现。Spark 的 mlp_layer_types 在全部 62 个块中都是 "sparse",llama.cpp 的转换脚本还对此做了断言。稠密路径依然存在:任何标为 "dense" 的层都会构建 MuseSparkTextMLP(8,192 → 16,384 → 8,192),配置中也有 intermediate_size: 16384,但两者都没有用上;mlx-community 的权重索引里没有语言模型的稠密 MLP 张量。一个有趣的巧合(推算):这样一层会有 $3 \times 8{,}192 \times 16{,}384 = 402{,}653{,}184$ 个参数,恰好等于 8 个激活专家的权重量。
专家之外没有 4 bit 权重。 Meta 的 NVFP4 checkpoint 只量化路由专家,而且不是全部。按 Hub 列出的 quantization_config(HF API),第 0 层和第 61 层的专家列在 modules_to_not_convert 中,与所有注意力投影、两个潜空间投影、输出层和各个编码器并列;SGLang 博客也证实“第 0 层和第 61 层使用 BF16 专家权重。”路由器保持 FP32。§7.4 用 checkpoint 的 dtype 计数核对了这一划分,并据此算出 checkpoint 的大小为 533 GB。
4.6 Glimmer 为什么是稠密模型
Glimmer 出自同一副骨架,Glimmer 报告说作者权衡过专家方案,最终放弃了。报告中“面向端侧效率的设计”一节从一条约束出发:“严格的 32 GB 显存上限,这是消费级硬件的实际天花板。”
实验训练了“逐级放大的架构阶梯”,比较“一个稠密基线与两种路由稀疏度不同(激活专家比例为 1:8 和 1:16)的混合专家(MoE)设计”。所谓阶梯,是用同一套配方训练的一系列规模递增的模型,这样就能拟合幂律,并外推到目标预算。比较遵循三条规则:
- 内存相同。 每个目标模型的参数量“都选得恰好能放进 32 GB 显存”。
- 算力相同。 每种设计的每参数 token 数(TPP)目标,由分配到的 GPU 小时数和该设计估计的模型 FLOP 利用率(MFU)决定:稠密模型为 550 TPP,1:8 MoE 为 2,800,1:16 MoE 为 6,000。
- 过训练。 “在我们的算力预算下,所有阶梯都处于过训练区间。”
结论是:“与对应的 MoE 相比,稠密配置的计算效率提高了 2×-2.5×。因此,我们为该架构选择了 30B 参数的稠密设计。”
直白地说:在固定的内存预算下,MoE 和稠密模型持有的参数量大致相同,但 MoE 每个 token 只运行其中一小部分,所以同样的 GPU 小时能让它训练 2,800 / 550 = 5.1× 或 6,000 / 550 = 10.9× 的 token(推算)。这两个倍数都达不到 8 和 16;我们猜测是 MoE 中的稠密部分和较低的 MFU 吃掉了一部分收益。即便多用了 5–11× 的数据,MoE 阶梯仍然不敌稠密阶梯。从报告的图上读数(近似值),在每个算力水平上,稠密阶梯在文本和代码两个面板中都处于最低位置;外推到预算点时,它在文本上约为 0.767 比特每字节(bits per byte,即原始文本每个字节上的损失,可以跨分词器比较,越低越好),两条 MoE 阶梯都约为 0.79。我们把“计算效率”理解为达到给定 loss 所需的 GPU 小时数。
我们的理解:总参数量封顶时,MoE 要用最稀缺的那份资源为闲置的专家买单,每个 token 实际激活的只是一个小模型;而在过训练区间,多出来的 token 已经弥补不了缺失的容量。
Spark 对同一个问题给出了相反的答案,因为它拿掉了这个上限(这同样是我们的理解)。它部署在多 GPU 节点上,权重从 533 GB(NVFP4)到 1.64 TB(BF16)不等(§7.4),所以真正要比的是每个 token 计算量相同的情形,而不是总参数量相同的情形。在这个维度上,闲置专家几乎不花 FLOPs:每个 token 由 42.78B 参数完成计算,存储的却是 816.68B,比例为 19.1×(推算)。批处理把存储的权重分摊到大量同时在途的 token 上,而 FLOPs 和 all-to-all 字节数会随每个 token 增长,潜空间设计削减的正是这两项开销。正如 §4.1 所示,两个模型每层每个 token 的 FFN 计算量相近(Spark 的 MoE 是 Glimmer 的 1.18×,推算),差别主要在于存了多少权重。
5. 残差流:三明治归一化与保范数残差门
每个子层都从残差流读取输入,再往里写回一些东西。一个深层堆叠表现如何,取决于两个问题:单次写入能有多大?Glimmer 经过 104 次写入、Spark 经过 124 次写入(每个块两个子层)之后,残差流又会变成多大?Glimmer 回答了第一个问题。它用一对 RMSNorm 把每个子层包起来,也就是 Gemma 2 的“三明治”,因此每次写入的大小都有界;但它仍然把各次写入直接相加,所以残差流会随深度增长。Spark 两个问题都回答了。它把每条分支的输出都归一化到单位 RMS,并把相加换成按通道学习的混合,混合系数满足 $\alpha^2 + \beta^2 = 1$。只要分支输出与残差流不相关,这就能让残差流从第一个解码器块到最后一个都保持单位尺度;即使两者相关,残差流也依然有界(§5.2)。两个模型还把残差流的两端也固定住了:嵌入以单位 RMS 进入,输出层则对 logit 重新缩放并做软截断。
5.1 Glimmer:三明治归一化
Glimmer 给每次写入都设了上限,却任由残差流增长。要看清其中的原因,先从两种经典布局说起。在前置归一化(pre-norm)的 Transformer 中,子层 $f$ 读取残差流归一化后的副本,再把自己的原始输出加回去:$x + f(\mathrm{Norm}(x))$。$f$ 的输入尺度受控,输出却不受约束:没有任何机制能阻止某个子层写入一个比残差流大一百倍的向量。最初的后置归一化(post-norm)布局 $\mathrm{Norm}(x + f(x))$ 转而约束残差流,代价是在跳跃路径(skip path)本身放了一个归一化。DeepNet(arXiv 2203.00555)把这看作两者之间的取舍:一边是“Post-LN 的良好性能”,一边是“Pre-LN 的稳定训练”。
三明治布局让跳跃路径保持为恒等映射,在分支的两端各做一次归一化。按代码的执行顺序,Glimmer 的解码器块是:
\[\begin{aligned} h &= x + \mathrm{PostNorm}_1\big(\mathrm{Attn}(\mathrm{PreNorm}_1(x))\big)\\ x' &= h + \mathrm{PostNorm}_2\big(\mathrm{FFN}(\mathrm{PreNorm}_2(h))\big) \end{aligned}\]也就是说,每个解码器块有四个 RMSNorm:input_layernorm、post_attention_layernorm、pre_feedforward_layernorm 和 post_feedforward_layernorm。Glimmer 的这种布局取自 Gemma 2,Gemma 2 的技术报告(§2,“用 RMSNorm 做后置归一化和前置归一化”)是这样描述的:“为了稳定训练,我们使用 RMSNorm……对每个 Transformer 子层(注意力层和前馈层)的输入和输出做归一化。”Glimmer 的 modular 文件直接继承了 Gemma 2 的类(MuseGlimmerTextDecoderLayer(Gemma2DecoderLayer)、MuseGlimmerTextCenteredRMSNorm(Gemma2RMSNorm))。这种放置方式比 Gemma 2 更早,也有别的名字:CogView(arXiv 2105.13290)称之为“三明治 LayerNorm”(Sandwich LayerNorm),另一个名字是 Peri-LN(arXiv 2502.02732)。
四个归一化都是中心化的:先归一化,再乘以 $(1 + w)$,所以权重 $w = 0$ 意味着增益恰好为 1:
\[\mathrm{RMSNorm}(x) = \frac{x}{\sqrt{\tfrac{1}{d}\sum_i x_i^2 + \varepsilon}} \odot (1 + w), \qquad d = 6{,}656 .\]前置归一化用 $\varepsilon = 10^{-5}$(rms_norm_eps),后置归一化用 $10^{-8}$(post_norm_eps,“用于注意力后和 FFN 后的归一化(它们位于子层输出与残差之间)”)。Gemma 2 的四个归一化共用一个 epsilon;§5.3 说明拆成两个之后有什么不同。
后置归一化换来的是每次写入的硬上限。不论原始注意力输出的 RMS 是 40 还是 0.03,后置归一化都会先把它缩放到 RMS 1,再乘以可学习的增益。这个增益 $(1 + w_{\text{post}})$ 就成了该子层逐通道的写入强度,相当于把 LayerScale(arXiv 2103.17239)用在一个归一化后的向量上。
没有被约束的是残差流本身,因为跳跃路径仍然在做加法。考虑理想情形:嵌入以 RMS 1 进入(实际正是如此,见 §5.4),每次写入的 RMS 都是 1(所有增益都等于 1),而且每次写入都与残差流中已有的内容正交。那么每经过一个子层,RMS 的平方就增加 1;每个解码器块有两个子层,经过 $\ell$ 个块之后,
\[\mathrm{RMS}(x_\ell) = \sqrt{1 + 2\ell}\,: \quad 1.73 \text{(1 个块后)},\; 5.20 \text{(13 个块后)},\; 10.25 \text{(全部 52 个块后,推算)。}\]前置归一化把这种增长对子层隐藏了起来,子层看到的永远是归一化后的输入。缩小的是每次新写入所占的分量:到了堆叠顶端,一次单位大小的写入只有残差流的十分之一左右。相关性会加快这一过程:如果每次写入与残差流之间的余弦为 0.3,经过 104 个子层后 RMS 会达到 36.2(推算)。u-µP 论文(单位缩放的最大更新参数化,arXiv 2407.17465,附录 F)描述了前置归一化网络中的同一现象:“初始化时跳跃流中的尺度增长,原因是残差连接反复相加,之后却没有归一化。”
实现细节
MuseGlimmerTextDecoderLayer.forward:residual = hidden_states→input_layernorm→self_attn→post_attention_layernorm→hidden_states = residual + hidden_states,然后用pre_feedforward_layernorm、mlp、post_feedforward_layernorm再走一遍。加法在激活值的 dtype 下进行。- 4 个带权重的归一化 × 52 个块 + 最终归一化 = 209 个向量,恰好就是 checkpoint 索引中语言模型的全部归一化张量(1,391,104 个参数,推算;视觉塔的 LayerNorm 另计)。
- modular 配置类删掉了 Gemma 2 的三个字段(
query_pre_attn_scalar、attn_logit_softcapping和use_bidirectional_attention,都设为AttributeError());无权重 QK-norm 取代了注意力软截断(§3.2)。 - llama.cpp 在转换时就把 1 加进四个块内归一化的权重(
conversion/muse_glimmer.py:“四个层归一化都用 1,最终归一化用 0。”),它的计算图(muse-glimmer.cpp)则把const float post_norm_eps = 1e-8f;写死在代码里。
5.2 Spark:保持范数的残差门
Spark 的 modular 文件在残差路径上改了三处。注意力后的归一化去掉了权重。FFN 后的归一化改成“先缩放后归一化”的形式:先乘以 $1 + w$,最后才归一化,从而保证输出的 RMS 为 1(§5.3)。两处加法都换成了 MuseSparkResidualGate。Hugging Face 发布博客用一句话概括:“每个块通过一个可学习的残差门,而不是简单求和,来组合自己的输入和输出。”下面是这个模块的全部代码,取自建模文件(略去了类型标注;# 0.3 注释是我们加的):
class MuseSparkResidualGate(nn.Module):
    def __init__(self, config, residual_gate_eps: float = 1e-3):
        super().__init__()
        self.gate = nn.Parameter(torch.empty(config.hidden_size))
        self.temperature = config.residual_gate_temperature   # 0.3
        self.eps = residual_gate_eps

    def forward(self, residual, hidden_states):
        w = self.gate / self.temperature
        beta = torch.sigmoid(w)
        alpha = torch.sqrt(torch.clamp(torch.sigmoid(-w) * (1.0 + beta), min=self.eps))
        return (alpha * residual + beta * hidden_states).to(residual.dtype)
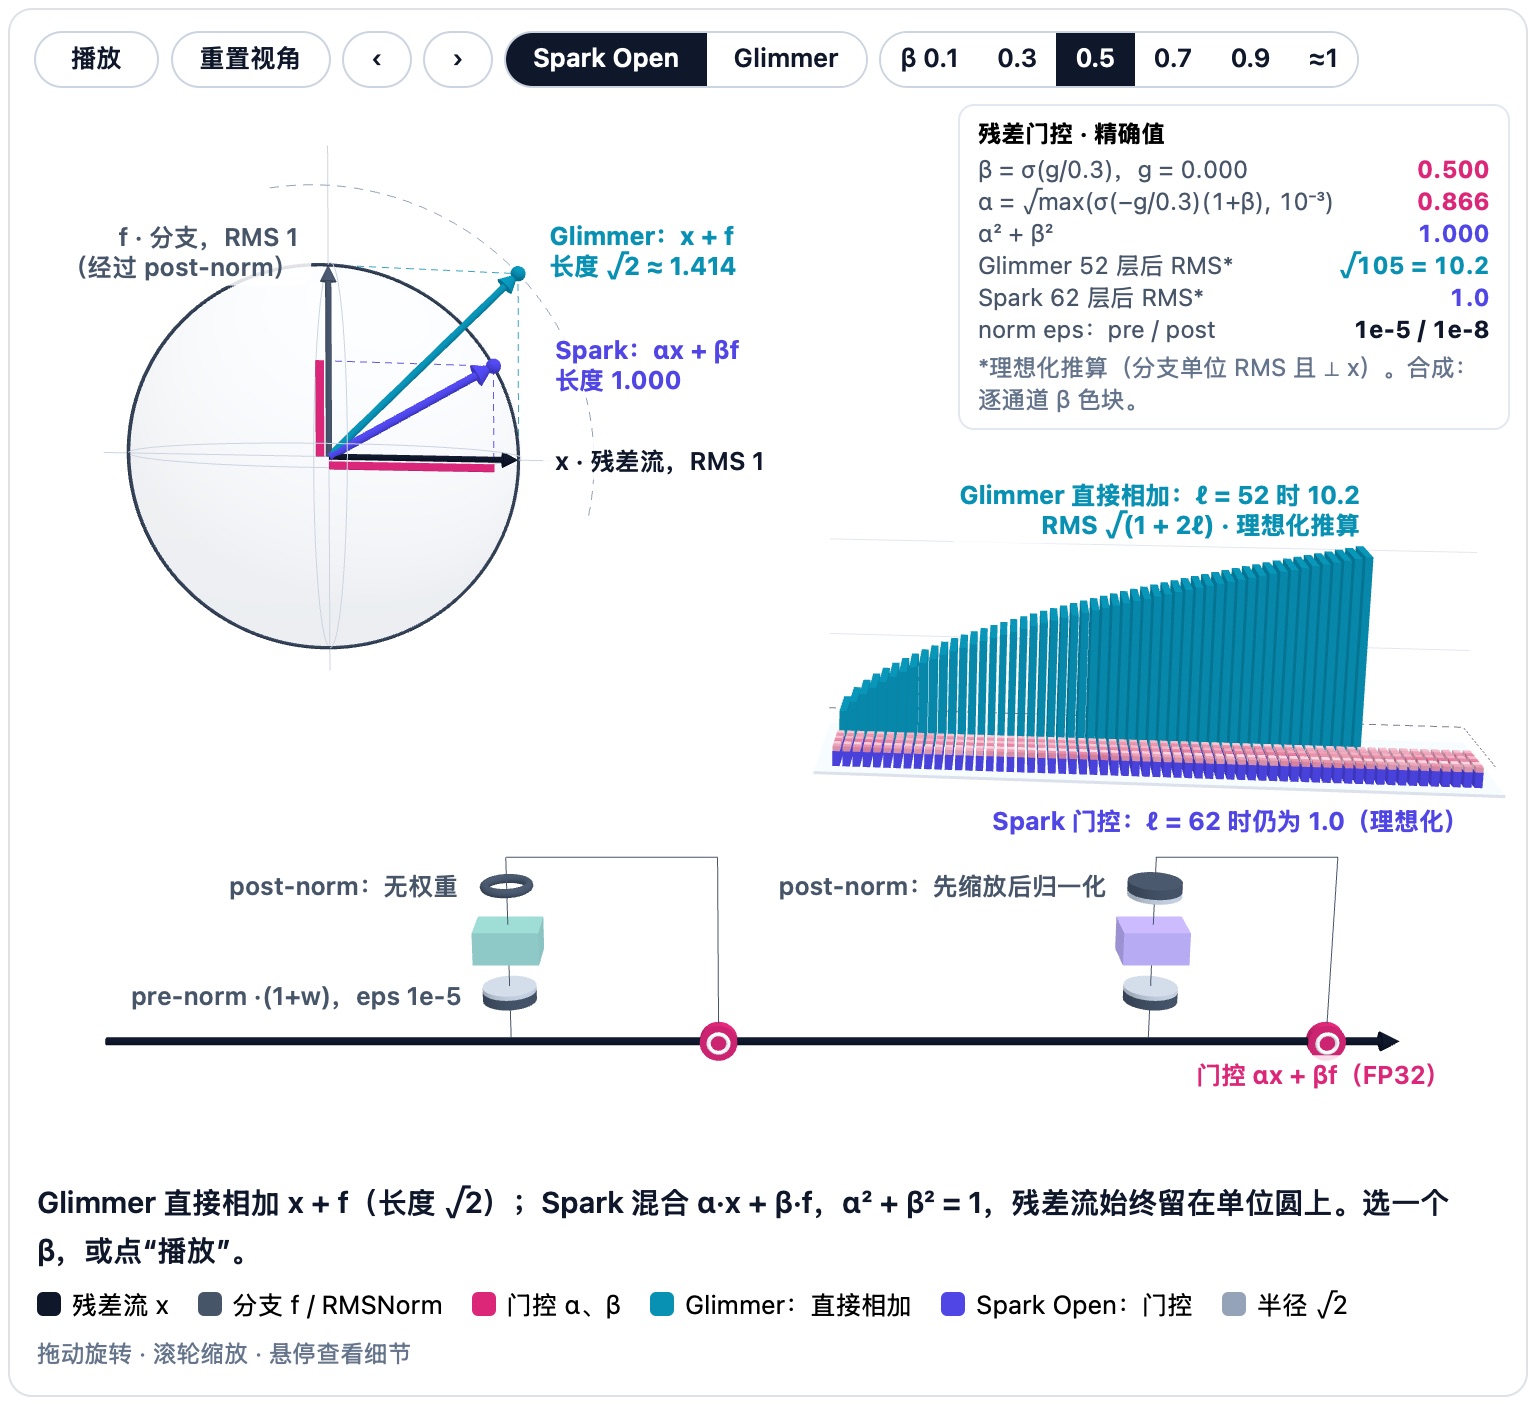
逐步来看:参数 $g$ 是一个宽 8,192 的向量,每个通道一个门。除以温度 $T = 0.3$,得到 $w = g/T$。分支系数是 $\beta = \sigma(w)$,残差流系数是 $\alpha = \sqrt{\max(\sigma(-w)(1+\beta),\, 10^{-3})}$,输出为 $\alpha \odot x + \beta \odot f$,其中 $x$ 是残差流,$f$ 是经过后置归一化的子层输出。每个解码器块两个门,共 124 个门、1,015,808 个参数(推算)。门从不看 token 本身:$\alpha$ 和 $\beta$ 只取决于 $g$。
为什么 $\alpha^2 + \beta^2 = 1$。 $\alpha$ 的公式其实就是改头换面的 $\sqrt{1 - \beta^2}$。因为 $\sigma(-w) = 1/(1 + e^{w}) = 1 - \sigma(w) = 1 - \beta$,只要钳位不起作用,就有
\[\alpha^2 = \sigma(-w)\,(1 + \beta) = (1 - \beta)(1 + \beta) = 1 - \beta^2 \quad\Longrightarrow\quad \alpha^2 + \beta^2 = 1 .\]所以 $(\alpha, \beta) = (\cos\theta, \sin\theta)$,其中 $\theta = \arcsin\beta$,介于 0° 到 90° 之间。(至于为什么写成乘积形式,我们的理解是:$\beta \to 1$ 时直接计算 $1 - \beta^2$ 会损失精度。)
为什么这能让残差流保持单位尺度。 取一个通道 $i$,假设残差流和分支的二阶矩都为 1,并且两者在各 token 上互不相关:
\[\mathbb{E}[\mathrm{out}_i^2] = \alpha_i^2\,\mathbb{E}[x_i^2] + \beta_i^2\,\mathbb{E}[f_i^2] + 2\alpha_i\beta_i\,\mathbb{E}[x_i f_i] = \alpha_i^2 + \beta_i^2 = 1 .\]单位 RMS 这两个前提是刻意设计出来的。分支的 RMS 为 1,是因为两个后置归一化都以一次归一化收尾,之后不再乘任何权重。残差流起步时 RMS 为 1,是因为嵌入、图像特征和音频特征都要经过一个无权重 RMSNorm(§5.4)。严格说来,归一化固定的是一个 token 在所有通道上的 RMS,而不是每个通道的二阶矩;但只要输入互不相关,$\alpha_i^2 + \beta_i^2 = 1$ 就会让每个通道输出的二阶矩成为两个输入二阶矩的加权平均(推算),所以混合永远不会让它变大。从几何上看,若 $x$ 与 $f$ 正交且长度相等,$\cos\theta\, x + \sin\theta\, f$ 就是把 $x$ 朝 $f$ 旋转 $\theta$:沿着圆周走一步,而不是往外走。
看一个四通道的例子:$x = [1, -1, 1, -1]$ 和 $f = [1, 1, -1, -1]$ 的 RMS 都是 1,点积为零。直接相加得到 $[2, 0, 0, -2]$,RMS 为 1.414。四个通道都取 $g = 0$ 的门($\beta = 0.5$,$\alpha = 0.866$)得到 $[1.366, -0.366, 0.366, -1.366]$,RMS 为 1.000。取 $g = 0.6$($\beta = 0.881$,$\alpha = 0.473$)时得到 $[1.354, 0.407, -0.407, -1.354]$,RMS 仍是 1.000。门改变的是残差流指向哪里,而不是它有多长。下表列出更多门值;$\theta$ 是输出与 $x$ 之间的夹角(均为推算)。
| $g$ | $\beta$(分支) | $\alpha$(残差流) | $\alpha^2+\beta^2$ | 旋转角 $\theta$ |
|---|---|---|---|---|
| −1.5 | 0.0067 | 1.0000 | 1.000 | 0.4° |
| −0.6 | 0.119 | 0.993 | 1.000 | 6.8° |
| 0 | 0.500 | 0.866 | 1.000 | 30.0° |
| +0.6 | 0.881 | 0.473 | 1.000 | 61.7° |
| +3.0(已钳位) | 0.99995 | 0.0316 | 1.0009 | 88.2° |
钳位。 当 $\beta \to 1$ 时,$1 - \beta^2$ 趋于零。代码给 $\alpha^2$ 设了 $10^{-3}$ 的下限,它在 $\beta > 0.9995$、也就是 $g > 2.28$ 时开始起作用(推算)。从那以后,$\alpha$ 停在 $\sqrt{0.001} \approx 0.032$,$\alpha^2 + \beta^2$ 缓慢上升,最多到 1.001,相当于每个门让 RMS 超出 0.05%(推算)。我们的理解:这个下限让每个通道至少保留旧残差流的 3.2%,同时让平方根远离零点,因为平方根在零点附近梯度会爆炸。
温度。 除以 0.3 让 sigmoid 变陡:在 $\beta = 0.5$ 处,$d\beta/dg = \beta(1-\beta)/T$ 为 0.83;$g \in [-1.5, 1.5]$ 就已经让 $\beta$ 覆盖 0.0067 到 0.9933(推算)。在 Adam 一类步长大致固定的更新下,一步让 sigmoid 的输入 $g/T$ 移动的距离是 $T = 1$ 时的 3.3×(我们的理解)。
分支与残差流相关时,RMS 会偏离 1,但依然有界。设两个单位 RMS 输入之间的余弦为 $\rho$,所有通道取同一个 $\theta$,那么一个门给出 $\mathrm{RMS}^2 = 1 + \rho\sin 2\theta \le 2$。经过 124 个 $\beta = 0.5$、$\rho = 0.3$ 的门,残差流稳定在 RMS 1.65;直接求和则会达到 42.5(推算)。普通残差把跳跃系数固定为 1,任由尺度增长;残差门则固定尺度,让跳跃系数缩小。
下图分四步把这两幅图景做成动画。左边,直接相加会走出单位圆,而门在 β = 0.1、0.5 和 0.9 时都让残差流沿着单位圆转动,90° 附近是钳位区。右边是理想情形下残差流 RMS 随深度的变化:直接相加为 $\sqrt{1 + 2\ell}$,经过 Glimmer 的 52 个块后达到 10.25;门则始终平稳地保持在 1。

精度。 HF 把两个门都列入 _keep_in_fp32_modules_strict,所以即使模型是 BF16,系数也用 FP32 计算;alpha * residual 会把残差流提升到 FP32 再做混合,.to(residual.dtype) 再把结果转回去。因此,用 BF16 运行 HF 实现时,124 个门每过一个,残差流都会被舍入回 BF16。TorchTitan 公开的 Muse Spark 实现让残差流保持 FP32(其 README 写道:“路由分数和贯穿各解码器块的残差流都使用 FP32”),mlx-lm 也是如此(h = h.astype(mx.float32))。
相关思路。 这个约束本身早有论文。Unit Scaling(arXiv 2303.11257)讨论过固定规则 $x_{l+1} = \sqrt{1-\tau}\, x_l + \sqrt{\tau}\, f(x_l)$,u-µP 也写明了“充分条件 $a_l^2 + b_l^2 = 1$”。两者固定的都是标量系数,Spark 则逐通道学习这些系数。u-µP 还证明,对前置归一化网络来说,这种标量加权等价于分支经过重新缩放的普通残差;所以我们的理解是,Spark 真正新增的是逐通道的自由度,以及一条保持在单位尺度附近的残差流。nGPT,即归一化 Transformer(arXiv 2410.01131),同样逐通道学习步长,但每次更新后都把残差流重新归一化;Spark 不这样做,而且由于输入的 RMS 都是 1,它也不需要这样做(我们的理解)。本博客介绍过的 mHC(GLM-5.3 §8.6、DeepSeek-V4 §7),从另一个方向处理同一个问题:用四路残差流加一个双随机混合矩阵,这个矩阵不会放大信号,并且保留了一条恒等路径。Spark 只保留一条残差流,放弃了恒等跳跃($\alpha < 1$),换来固定的尺度。
实现细节
MuseSparkTextDecoderLayer.forward:input_layernorm→self_attn→post_attention_layernorm(无权重,ε 1e-8)→post_attention_residual_gate(residual, hidden_states),然后是pre_feedforward_layernorm→mlp(§4)→post_feedforward_layernorm(先缩放后归一化,ε 1e-8)→post_feedforward_residual_gate。residual_gate_temperature: 0.3写在 mlx-community 公开的 MLX 转换版本的 config.json 中,代码默认值与之一致。1e-3 的下限是构造函数的默认参数,而不是配置字段。- llama.cpp 的转换脚本(
conversion/muse_spark.py)预先算好系数(“保范数残差门:alpha 缩放残差流,beta 缩放分支,满足 alpha^2 + beta^2 = 1”,RESIDUAL_GATE_EPS = 1e-3),所以它的计算图里只剩乘法和加法。mlx-lm 在residual_gate_coefficients里做了同样的事。 - TorchTitan 把这个模块叫作
MuseSparkNormPreservingResidualConnection;它从零训练时的初始化设 $\beta = 1/(2(\ell+1))$,从第 0 块的 0.5 递减到第 61 块的 0.0081。HF 的_init_weights按 $g \sim \mathcal{N}(0, 0.02^2)$ 采样,所以各处都是 $\beta \approx 0.5$。
5.3 形形色色的 RMSNorm
两个模型合起来用了四种 RMSNorm:无权重的、增益为 $(1+w)$ 的中心化 RMSNorm、Spark 的先缩放后归一化 RMSNorm,以及带绝对增益的最终归一化。下表按 token 经过的顺序列出每一个归一化;ε 一列对两个模型都适用。
| 归一化(模块) | 位置 | Glimmer | Spark | ε |
|---|---|---|---|---|
embed_tokens.embed_norm |
token 查表之后(Spark:音频特征也经过它) | 无权重 | 无权重 | 1e-5 |
perception_emb_norm |
视觉投影之后 | 无权重 | 无权重 | 1e-5 |
input_layernorm |
注意力之前 | 中心化 | 中心化 | 1e-5 |
self_attn.qk_norm |
query 和 key,逐头(Glimmer 宽 128,Spark 宽 64) | 无权重 | 无权重 | 1e-5 |
self_attn.o_norm |
注意力输出,逐头(宽 64) | 无 | 无权重 | 1e-5 |
post_attention_layernorm |
注意力之后 | 中心化 | 无权重 | 1e-8 |
pre_feedforward_layernorm |
FFN / MoE 之前 | 中心化 | 中心化 | 1e-5 |
mlp.pre_expert_norm |
降维 8,192 → 4,096 之后 | 无 | 中心化(4,096) | 1e-5 |
mlp.experts.post_expert_norm |
每个专家的输出;全部 256 个专家共用一个权重 | 无 | 先缩放后归一化(4,096) | 1e-8 |
post_feedforward_layernorm |
FFN / MoE 之后 | 中心化 | 先缩放后归一化 | 1e-8 |
norm(最终) |
lm_head 之前 |
绝对增益 | 绝对增益 | 1e-5 |
按我们的统计,Glimmer 有 209 个归一化权重向量,Spark 有 311 个(每个解码器块 5 个,外加最终归一化,共 2,039,808 个参数;推算)。§3.3 讲 o_norm,§4.4 讲专家归一化,§6 讲各编码器自己的归一化。
施加增益的三种方式。 无权重归一化只除以 RMS。中心化归一化先归一化,再乘以 $(1+w)$,所以权重决定了每个通道输出的大小。先缩放后归一化的 RMSNorm 把顺序倒过来:先乘以 $(1+w)$,再归一化。它的输出 RMS 永远是 1,权重只改变方向。取 $m = [3, 1]$、$w = [1, 0]$。中心化:$[1.342, 0.447] \odot [2, 1] = [2.683, 0.447]$,RMS 为 1.92。先缩放后归一化:$[6, 1] / 4.301 = [1.395, 0.233]$,RMS 为 1.00。我们的理解:凡是既需要单位 RMS 的向量、又想保留一个可学习的通道形状的地方,Spark 就用先缩放后归一化的形式:一处紧挨在 FFN 后的门之前,另一处在每个专家的输出上,紧挨在乘以路由权重之前(§4.4)。
两个 epsilon。 输入均方为 ms 时,RMSNorm 输出的 RMS 是 $\sqrt{\mathrm{ms}/(\mathrm{ms}+\varepsilon)}$。取 $\varepsilon = 10^{-5}$ 时,只要输入 RMS 不低于 0.022,输出 RMS 就仍能达到 0.99;取 $10^{-8}$ 时,这个下限降到 0.0007(推算)。因此,即使分支输出再小约 32×,后置归一化也能把它变成单位 RMS 的写入。对 Spark 来说,这保护了门的单位 RMS 前提(我们的理解);代价是接近零的分支输出也会被放大到完整尺度。
增益的舍入。 在 BF16 运行中,Spark 的移植会先把每个 $(1+w)$ 增益舍入到 BF16 再使用,TorchTitan 和 mlx-lm 也是这样;Glimmer 的移植则在 FP32 下构造增益。下面的实现细节追踪了这次类型转换。
最终归一化的权重是绝对增益,初始化为全 1。llama.cpp 转换脚本里写着:“块内归一化存的是相对 1 的偏移量;输出归一化存的是绝对增益。”
| 下面的 3D 模型在动画之外多了三样东西:β 按钮一直推到钳位区(β ≈ 1),旁边的能量条把 $\alpha^2 + \beta^2$ 与 $ | x + f | ^2 = 2$ 放在一起对比;Spark 深度柱上的方块显示 β 随通道和层而变;最后一步画出子层周围的每个归一化及其变体和 ε,并可在 Spark Open 与 Glimmer 之间切换。门的公式、归一化类型和 ε 都是精确的;深度曲线是理想化的,逐通道的 β 方块是合成数据。 |
实现细节
- Glimmer 的中心化归一化保留了 Gemma 2 的一条注释:“Llama 做的是 x.to(float16) * w,而 MuseGlimmerTextCentered 做的是 (x * w).to(float16)”。乘法在 FP32 下进行,结果只舍入一次。Spark 的副本写的是“用 (x * w).to(bfloat16),而不是 x.to(bfloat16) * w”,但有一次类型转换挪了位置:Glimmer 把增益写成
1.0 + self.weight.float(),Spark 写成(1.0 + self.weight).float()。因此在 BF16 运行中,Spark 的增益会先被舍入到 $[1, 2)$ 区间内 $2^{-7} = 0.0078$ 的整数倍(推算)。 - 先缩放后归一化的 RMSNorm 还要再舍入一次:它在归一化之前,先把缩放后的输入转回输入的 dtype,即“在归一化之前做 fp32->bf16->f32”。
- 我们的理解:Spark 的移植是有意照搬其他公开实现对 BF16 增益的舍入。TorchTitan 在参数的 dtype 下计算
weight + gain_center,再转换为输入的 dtype;mlx-lm 存的是(1.0 + weight.astype(mx.float32)).astype(mx.bfloat16)。
5.4 归一化的嵌入与 µP 风格的输出层
残差流的两端都被固定住了。每个输入向量,不论来自哪种模态,都以 RMS 1 进入第 0 块;输出层则把 logit 乘以一个随宽度变化的系数,并把它们截断在 ±20 以内。
嵌入。 MuseGlimmerTextNormedEmbedding 在 Spark 中原样沿用:它从 202,048 行的嵌入表中查出一行,再施加一个无权重 RMSNorm(ε 1e-5),所以每个 token 都以 RMS 1 进入第 0 块。代码注释说,这个归一化“不能合并进嵌入矩阵,因为 Dflash 的实现需要做不带归一化的嵌入”。从数学上讲,归一化每次只作用于一行,本可以折叠进嵌入表(推算);之所以单独保留,是因为 DFlash 草稿模型(§8)与目标模型共用嵌入表,需要原始的行。HF 的 DFlash 候选生成器为了拿到原始的行,会临时把 embed_norm 换成 nn.Identity()。
其他模态也落在同一尺度上。来自 Perception Encoder 的图像特征要经过 perception_emb_norm,这是一个独立但完全相同的无权重归一化;Glimmer 报告把这一步描述为“一个不带偏置的线性层,后接无参数的 RMSNorm”(arXiv 2610.24628,“多模态输入与感知编码器”一节)。Spark 的音频特征先经过音频编码器自己带权重的 post_proj_norm 离开编码器,再经过文本模型的 embed_norm。文本、图像和音频位置都从单位 RMS 起步(§6),这正是 §5.2 的论证所需的初始条件。相比之下,HF 的 Gemma 2 把嵌入乘以 $\sqrt{d}$;Muse 则丢掉了行向量的长度,所以(我们的理解)token 嵌入的范数不携带任何信息。
输出层。 最终归一化之后是 lm_head,两个模型中它都不与嵌入共享权重;接着是下面四行代码(# 20.0 注释是我们加的):
logits = logits * self.config.text_config.output_multiplier
logits = logits / self.config.text_config.final_logit_softcapping   # 20.0
logits = torch.tanh(logits)
logits = logits * self.config.text_config.final_logit_softcapping
对 lm_head 的原始输出 $z$,最终 logit 为 $20\tanh(mz/20)$。配置的 docstring 把 $m$ 定义为“对已发布的 checkpoint 等于 1/sqrt(hidden_size / 256)”:Glimmer 为 $1/\sqrt{26} = 0.19612$,Spark 为 $1/\sqrt{32} = 0.17678$,与两份配置中的值完全一致(推算)。软截断来自 Gemma 2,即 $\text{cap} \cdot \tanh(\text{logits}/\text{cap})$,只是上限取 20 而不是 30,而且只用于最终 logit,不用于注意力。
这个截断在零附近几乎是线性的,在 ±20 附近则趋于平坦:$20\tanh(x/20)$ 把 5 映射为 4.90,10 映射为 9.24,20 映射为 15.23,40 映射为 19.28。要得到 19 的最终 logit,需要 $mz = 36.6$,即 Glimmer 中原始输出达到 186.8,Spark 中达到 207.2。任意两个 token 的对数概率之差永远小于 40 nat(均为推算)。
为什么是 $1/\sqrt{d/256}$。 我们的理解:这是 µP 的输出乘子,以 256 为基准宽度来计量。在 Tensor Programs V(arXiv 2203.03466,表 9)中,输出层权重的初始化方差取 $1/\text{fan-in}$,乘子取 $1/\sqrt{\text{fan-in}}$;这是一整套规则的一部分,有了这套规则,在窄模型上调好的超参数就能沿用到宽模型上。$\sqrt{256/d}$ 就是把这个乘子归一化成在宽度 256 时等于 1,而 TorchTitan 从零训练时 lm_head 的初始化标准差为 $d^{-1/2}$。两份公开资料指向同一方向:一是 Llama 4 博客中的 MetaP,它设定逐层的学习率和初始化尺度,目的是让它们能在不同模型宽度之间迁移(§3.2);二是 llama.cpp 的转换脚本,其中一位贡献者的注释写道:“MetaP 归结为两个标量 / 输出乘子落在这里,注意力缩放则附在合成出来的 QK-norm 权重上。”把 MetaP 与 Muse 联系起来,是我们根据这条注释做出的理解。第二个标量就是 qk_scale_factor,它把注意力温度固定在 43.784(§3.2)。
路由器借用了这个乘子。 Spark 的路由器在 sigmoid 之前,把 FP32 logit 乘以同一个 output_multiplier(§4.2)。路由器是另一个从宽度 $d$ 映射到固定大小(256 个专家)的读出层,所以同一条规则也适用(我们的理解)。
实现细节
- Spark 确实是把文本的归一化直接用在音频上:
get_audio_features里写的是self.get_input_embeddings().embed_norm(audio_features)。嵌入归一化用config.rms_norm_eps构建,类里 1e-6 的默认值从未用上。 - HF 和 llama.cpp 中都没有嵌入乘子,TorchTitan 的 816B flavor 也设了
embedding_multiplier=1.0。 - llama.cpp 把 $m$ 存为 GGUF 的
logit_scale。mlx-lm 在 FP32 下施加乘子和软截断。
6. 感知:一个视觉编码器,外加一个不用注意力的音频编码器
像素和声音怎样变成解码器的输入?对于图像和视频,两个模型用的是同样的部件,顺序也一样:先是一个名为 Perception Encoder 的 50 层 ViT;再是一个 2 × 2 的 pixel shuffle,把每块四个相邻的 patch 折叠成一个向量;然后是一个两层适配器、一个把向量投影到文本宽度的线性层,最后是一个无权重 RMSNorm。Spark Open 还多了一个音频塔:一个四级卷积金字塔,直接读取 24 kHz 的原始波形,每秒输出 12.5 个 token,全程不用注意力。感知部分的体量很小,只占 Glimmer checkpoint 的 6.45%、Spark 的 0.249%(推算)。
6.1 两个模型共用的 Perception Encoder
两个模型用的是哪个视觉编码器?是同一种架构。按我们的统计,它是一个 1.85B 参数的 ViT,出自 Meta 的 Perception Encoder 家族;两份配置中的各项尺寸和层的排布都相同。Glimmer 报告用一段话介绍了它(arXiv 2610.24628,“多模态输入与感知编码器”一节):“我们采用 Perception Encoder,它使用 NaViT 风格的视觉主干。该编码器是一个约 1.8B 参数的 ViT-G/14,共 50 层,宽度 1536,patch 大小为 14,以原生分辨率处理图像,并使用 448 px 的参考网格。”Perception Encoder(arXiv 2504.13181)是 Meta 的图像与视频编码器,用 CLIP 式的图文对比学习训练而成;它 G 规模的视觉塔在宽度、深度、MLP 宽度和头数上都与此相同(见该论文表 4)。NaViT(arXiv 2307.06304)“在训练中使用序列打包,以处理任意分辨率和宽高比的输入”。落到 Muse 的代码里,这意味着输入没有固定尺寸:一个批次中所有图像的 patch 拼接成一条序列,注意力只在每一帧自己的片段内进行。
下表是两份配置(Glimmer 的 config.json;Spark 则取 mlx-community 公开的 MLX 转换版本中的 config.json)对这座视觉塔的定义。两个 vision_config 块的每一项尺寸都相同,层的排布也一致。
| 字段 | 取值 |
|---|---|
| 宽度 / 层数 | 1,536 / 50 |
| 注意力 | 16 个头 × 96,双向,普通多头注意力(不用 GQA),投影带偏置 |
| MLP | 1,536 → 8,960 → 1,536,精确 GELU |
| 归一化 | 前置归一化的 LayerNorm,带权重和偏置(eps 1e-5) |
| patch 嵌入 | 14 × 14 px × 3 通道 × 2 帧 = 1,176 个输入 → 1,536,无偏置 |
| 位置 | 可学习的 32 × 32 位置表,外加每一层的 2D RoPE(θ = 10,000) |
| 层的排布 | 37 个窗口注意力层,13 个全注意力层 |
| 参数量(推算) | 1,852,639,744 |
这是一个经典的 ViT,而不是缩小版的解码器:LayerNorm 带偏置,没有 QK-norm,也没有门控。静态图像用同一帧填满一个 patch 的两个时间槽位;视频则用两个相邻帧来填(§6.2)。
两路位置信号。 第一路是一张可学习的位置表,含 32 × 32 个向量,对应 448 px 参考网格上的每个 patch。它按每张图像的 patch 网格做双线性重采样(复现的是零填充的 F.grid_sample),在 patch 嵌入之后加一次。图像为 448 px 时,每个 patch 恰好读到表中的一个向量;超过 448 px 时,最外圈的 patch 读到的不足一个完整向量(896 px 时,边缘一行的权重为 0.75,推算)。第二路是每一层都有的 2D RoPE:每个 96 维的头分成列、行两半,每个轴 24 个频率,分别按 patch 的列号和行号(从 1 开始数)旋转。Perception Encoder 论文解释了为什么两路都保留:“我们在每个注意力层加入 2D RoPE 以改善外推,同时保留原有的位置嵌入。”Glimmer 的配置把这种 RoPE 标为 "default",Spark 的标为 "axial";两者的数学形式相同,而且 Transformers v5.20.0 会把保存下来的 "default" 改写为 "axial"(modeling_rope_utils.py)。
窗口层与全注意力层。 第 3、7、11、…、47 层和第 49 层关注一帧中的所有 patch。其余 37 层只在固定、互不重叠的窗口块(tile)内做注意力,每个窗口块是 32 × 32 个 patch(448 × 448 px),从每帧的左上角开始铺排。这些窗口块不像解码器的局部窗口那样滑动(§3.4),而且没有任何一层的注意力会跨越两张图像,或视频中的两个帧对。规则是从底部开始每数 4 层取一层,再加上最后一层,所以末尾依次是第 47 层全注意力、第 48 层窗口、第 49 层全注意力;解码器的三接一模式则是从顶层往回数(§2.2)。Spark 的模型卡把这一方案描述为“因子为 4 的稀疏注意力(每 4 层中的第 4 层以及最后一层为全注意力)”,所以它说的“稀疏”层就是这些窗口层。
只有当图像某一边超过 448 px 时,窗口块才起作用;更小的图像整个落在一个窗口块里,两类层算的是同一件事。一张 1,920 × 1,080 的截图会被缩放到 1,932 × 1,092 px,横向 138 个 patch、纵向 78 个,由 15 个窗口块覆盖。这时 ViT 的计算量约为 51.2 TFLOP;如果 50 层全是全注意力层,则是 75.4 TFLOP。窗口层省下了 32%(推算)。
两次发布,同一种架构。 Spark Open 的 Hugging Face 发布博客说 Glimmer“使用了相同架构的编码器”。在两份配置里,ViT 和适配器的形状都相同;只有 vision_projection 不同,因为它映射到文本宽度:Glimmer 为 6,656,Spark 为 8,192(推算)。
位置表的 Spark 专用网格顺序。 Spark 的 Transformers 移植按 (t, w, h) 的顺序把 patch 网格交给可学习位置表;TorchTitan 公开的 Spark flavor 同样给视觉编码器设定了 Spark 专用的顺序 pos_emb_grid_order="legacy_spark"。这种布局只在非正方形图像上与 Glimmer 不同;正方形图像读取位置表的方式完全一样,两者的 2D RoPE 也相同。下面的实现细节给出了相关代码和一个算例。
实现细节
MuseGlimmerVisionModel.forward(modeling_muse_glimmer.py,v5.20.0)接收打包好的pixel_values,形状为 (patch 总数, 1,176),外加grid_thw。它构建逐帧的cu_seqlens和窗口块置换,运行 patch 嵌入器和ln_pre,并让每个窗口块在内存中连续排列(hidden_states[window_index, :])。RoPE 位置是position_ids.flip(-1) + 1(注释写着“加1,因为参考实现的位置偏移是1!”)。第 i 层拿到cu_seqlens_mapping[self.config.layer_types[i]];全部层跑完后,torch.argsort(window_index)恢复光栅顺序,再进入ln_post和 pixel shuffle。- 窗口块大小不是配置键:
self.window_size = config.pos_emb_height * config.patch_size= 32 × 14 = 448,这就把窗口块和位置表绑在了一起。 - 在每个头内,列坐标占第 0–23 维和第 48–71 维,行坐标占第 24–47 维和第 72–95 维;
rotate_half把第 i 维与第 i + 48 维配对,所以每个旋转平面只用一个轴。 - FLOP 计数(推算,每次乘加计 2 FLOP):线性层每个 patch 花费 2 × 50 × (4 × 1,536² + 2 × 1,536 × 8,960),每层的注意力再加 4 × 1,536 × (片段长度)²。对截图的 10,764 个 patch,线性层是 39.8 TFLOP,13 个全注意力层的注意力是 9.3 TFLOP,37 个窗口层是 2.1 TFLOP;这 37 层如果是全注意力层,则要 26.3 TFLOP。patch 嵌入不计在内。
- 对静态图像而言,1,176 个输入的 patch 线性层等价于一个 588 个输入的线性层,只需把权重的两个时间半区相加;llama.cpp 的转换脚本正是这样折叠的。
- Spark 对视觉计算的唯一改动是一次索引交换:
MuseSparkVisionPatchEmbedder把grid_thw[:, [0, 2, 1]],也就是 (t, w, h),交给重采样辅助函数,依据是参考代码把meshgrid(pos_h, pos_w, indexing="xy")传给了grid_sample。于是辅助函数在一个 w 行 × h 列的网格上对位置表采样,再按 patch 的 h × w 光栅顺序分配这些采样值。对非正方形网格,这是一次 reshape,而不是转置:在一个 2 × 3 的网格上,Glimmer 右上角的 patch 读的是表中第 7.5 行、第 26.2 列附近的位置,Spark 的则是 (15.5, 7.5) 附近(表坐标范围为 0–31,推算)。 - Glimmer 的视觉配置给 ViT 定了一套张量并行方案(q、k、v 和
fc1按列切分,proj和fc2按行切分);MuseSparkVisionConfig用base_model_tp_plan = {}覆盖了它,所以在张量并行下,Spark 的视觉塔不做切分(我们的理解:每个 rank 都持有一份完整副本)。在两个模型中,适配器和投影都保留各自按列、按行切分的方案。
6.2 从 patch 到 token
一张图像怎样变成解码器 token?它先缩放一次,切成 14 px 的 patch,送进 ViT,再按 2 × 2 折叠,于是缩放后图像中每个 28 × 28 px 的单元格变成一个 token:一张 448 × 448 的图像要花 256 个 token。
只缩放,不切块。 图像处理器(Transformers 把 muse_spark 映射到 MuseGlimmerImageProcessor)用 LANCZOS 把每张图像缩放一次,缩放到整数个 28 × 28 px 的单元格:尺寸大致保持原样,取宽高比最接近原图的单元格网格;如果会超过 4,096 个单元格,就先缩小。像素值缩放到 [−1, 1]。报告说,不同于“带缩略图 / 全局裁剪的动态切块”,“我们只做一次保持宽高比的缩放,缩放到一个合法的 token 网格”。一个单元格变成一个解码器 token,所以一张图像至多花 4,096 个 token,即 16,384 个 patch;正方形图像对应 1,792 × 1,792 px(推算)。
以一张 448 × 448 的图像为例,逐步来看:
- 切 patch: 32 × 32 = 1,024 个 patch,每个 1,176 个数。
- ViT: 经过 50 层和
ln_post,得到 (1,024, 1,536)。 - pixel shuffle: 每个 2 × 2 的相邻 patch 块折叠成一个 4 × 1,536 = 6,144 维的向量,得到 (256, 6,144)。没有任何信息被平均掉。
- 适配器: 无偏置的
fc16,144 → 4,096,GELU,fc24,096 → 4,096,再一次 GELU,得到 (256, 4,096)。 - 投影: 一个无偏置的线性层投影到文本宽度,Spark 为 (256, 8,192),Glimmer 为 (256, 6,656)。
- 无权重 RMSNorm: 每个向量除以自身的 RMS(eps 1e-5),没有可学习的缩放。
- 写入序列: 这 256 个向量覆盖
<|image_start|>与<|image_end|>之间的 256 个<|patch|>占位 token(id 200092)。
14 px 的 patch、2 帧的时间 patch 和 2 × 2 合并,正是我们在 GLM-5.3-Flash 的编码器里见过的配方(GLM-5.3 那篇,§8.8)。Spark 模型卡里的“4096 输出维度”对应的是适配器的输出宽度(projector_hidden_size),而不是重排之后的 6,144,也不是解码器的 8,192。下表给出其他几种尺寸,是我们运行 smart_resize 并套用窗口块规则推算出来的:
| 输入(高 × 宽,px) | 缩放后 | patch 网格 | ViT 窗口块 | 解码器 token |
|---|---|---|---|---|
| 100 × 100 | 112 × 112 | 8 × 8 | 1 | 16 |
| 448 × 448 | 448 × 448 | 32 × 32 | 1 | 256 |
| 1,080 × 1,920 | 1,092 × 1,932 | 78 × 138 | 15 | 2,691 |
| 4,000 × 4,000 | 1,792 × 1,792 | 128 × 128 | 16 | 4,096(上限) |
为什么最后要接一个无权重归一化?我们的理解是,这让图像向量与文本处在同一尺度上。文本嵌入和 Spark 的音频特征经过的也是同样的无权重归一化,所以每个输入位置的 RMS 起点都是 1(§5.4)。在解码器里,图像 token 占用的是普通的、连续的一维位置:局部层用 RoPE,全局层不用位置(§3.4)。二维布局只能通过编码器特征和 2 × 2 块的光栅顺序传进来(我们的理解)。
视频。 默认的 MuseGlimmerVideoProcessor 每秒采样 2 帧,整段至多 96 帧,均匀分布在整个片段上,并把相邻的采样帧两两配对:每个 1,176 个数的 patch 装着两帧中同一个 14 × 14 的方块。每个帧对(按默认采样率对应一秒视频,直到片段超过 48 s 为止)缩放到至多 144 个 token,720p 或 1080p 的画面为 252 × 448 px;在它的 <|video|> 占位 token(id 200091)之前,还会加一个文本时间戳,例如 Time: 3.5s(Hugging Face 博客中的例子)。一段视频最多是 48 个帧对 × 144 = 6,912 个视觉 token,再加上时间戳(推算),与部署文档的说法一致:“从大约 48 秒起,上限约为 6.9K 个 token。”全注意力从不跨越两个帧对,所以帧对之间的信息只在解码器里混合。两个模型共用这个处理器,但只有 Spark 的模型卡把视频列为输入;Glimmer 报告说它可以“以帧序列的形式”读入视频,但“未针对视频做专门优化”。
Spark 模型卡提醒,“非常短或分辨率很低的视频(几秒钟、约 100 px)”可能会失败,并建议“短边不小于 448 px”。算一算就知道,这样的片段留给解码器的信息有多少:一段 100 × 100 的视频会变成 112 × 112 px,每个帧对 16 个 token,所以一段 2 秒的视频只产生 32 个视觉 token(推算)。默认处理器会把短边不小于 448 px 的每个 16:9 视频源都缩小到每帧对 252 × 448。
参数量。 下表按形状清点视觉通路的参数(推算)。加上解码器,对 Spark 再加上音频塔,这些计数与 Hub 上两个 checkpoint 的总数都能对上(§2.3)。
| 组件(推算) | 公式 | Glimmer | Spark |
|---|---|---|---|
| ViT 塔 | patch 1,806,336 + 位置表 1,572,864 + 2 个 LN 6,144 + 50 × 36,985,088 | 1,852,639,744 | 同左 |
| 适配器 | 6,144 × 4,096 + 4,096 × 4,096 | 41,943,040 | 同左 |
| 投影 | 4,096 × 文本宽度 | 27,262,976 | 33,554,432 |
| 视觉通路 | 1,921,845,760 | 1,928,137,216 |
模型卡和报告中的“1.8B”对应的是单独的视觉塔(1.853B;我们的理解)。§2.3 把这些计数放进了整体的参数预算。
实现细节
smart_resize先把图像尺寸换算成 28 px 单元格的个数,必要时缩小到 4,096 个单元格的上限以内,再对两条边分别尝试向下取整和向上取整,保留宽高比最接近输入的候选;除了这一步取整,它不会放大小图。对正方形输入,向下取整和向上取整的网格打成平手,代码保留 Pythonset中排在前面的那个:100 × 100 的图像得到 4 × 4 个单元格(112 px)(推算:实际运行该函数得出)。pixel_shuffle的最后一步是hidden_states.view(-1, factor * factor, dim).permute(0, 2, 1).reshape(-1, dim * factor * factor),其中factor= 2,所以对第 o 块中的第 s 个 patch,有out[o, 4c + s] = x[4o + s, c]:以通道为主序、patch 为次序排列。在视觉塔内部,spatial_merge_size保持为 1;“合并推迟到pixel_shuffle中进行”。MuseGlimmerVisionAdapter.forward就是self.act(self.fc2(self.act(self.fc1(x))));随后get_image_features依次施加vision_projection和perception_emb_norm = MuseGlimmerRMSNorm(..., with_scale=False)。前向传播在查嵌入表之前先把占位 id 置零,然后调用inputs_embeds.masked_scatter(image_mask, image_embeds)。- 本节的图像和视频上限都是 Transformers v5.20.0 中共用处理器的默认值。
6.3 Spark 的音频编码器:只用卷积,从 24 kHz 降到 12.5 Hz
Spark 怎样把声音变成 token?一秒 24 kHz 的音频是 24,000 个数,而解码器只为它拿到 12.5 个向量。Spark 用一条固定的流水线弥合这个差距,代码是这样描述它的:“一个完全因果的卷积金字塔,把原始的单声道 24 kHz 音频映射为每 1920 个采样点一个嵌入(80 ms,即 12.5 Hz),输出直接就是文本模型的隐藏维度。它不用注意力,也没有频谱图前端”(modular_muse_spark.py)。特征提取器“只做批处理、填充和(可选的)截断”:只接受单声道,只接受 24,000 Hz,在右侧补零到 1,920 个采样点的整数倍。
四级结构。 每一级先把 p 个连续帧折叠成一帧(从 (B, T, C) reshape 成 (B, T/p, p·C),再接一个线性层和一个 RMSNorm),然后用两个卷积块细化这条变短的序列。一个卷积块依次是:沿时间方向、核大小为 7 的逐通道因果卷积(每个通道单独滤波),一个 RMSNorm,一个用 GELU、把宽度放大 4× 的 MLP,以及一次残差相加;用我们的话说,这是一个类似 ConvNeXt 的块。第 0 级的“patch”是 16 个原始采样点,所以它的线性层相当于一个可学习的滤波器组(我们的理解)。各级 patch 大小相乘,就是一个 token 背后的采样点数:
\[\text{token 数} = \left\lceil \frac{\text{采样点数}}{16 \times 6 \times 5 \times 4} \right\rceil = \left\lceil \frac{\text{采样点数}}{1{,}920} \right\rceil, \qquad \frac{1{,}920}{24{,}000\ \text{Hz}} = 80\ \text{ms}.\]下表每行对应一级;除 patch 大小和宽度之外,其余各列都是推算值。
| 级 | patch | 宽度 | 帧率 | 帧长 | 每个 token 的帧数 | 参数量 |
|---|---|---|---|---|---|---|
| 0 | 16 个采样点 | 256 | 1,500 Hz | 0.67 ms | 120 | 1,060,352 |
| 1 | 6 帧 | 512 | 250 Hz | 4 ms | 20 | 4,996,096 |
| 2 | 5 帧 | 1,024 | 50 Hz | 20 ms | 4 | 19,429,376 |
| 3 | 4 帧 | 2,048 | 12.5 Hz | 80 ms | 1 | 75,558,912 |
| 输出头 | RMSNorm → 线性层 → RMSNorm | 2,048 → 8,192 | 12.5 Hz | 80 ms | 1 | 16,795,648 |
整个音频塔共有 117,840,384 个参数(推算)。帧率下降得比宽度增长得快,所以每秒音频的计算量在各级之间大致均衡,整个塔约为每秒 9.9 GFLOP(推算)。下面的动画放大一个 80 ms 的 token:看 1,920 个采样点先变成 120 个第 0 级的帧,再变成 20 个、4 个,最后成为一个 2,048 维的帧,由输出头提升到 8,192 维。第三步预演了下文要讲的因果感受野。

一段 60 秒的音频(推算)。 60 s × 24,000 = 1,440,000 个采样点,恰好已是 1,920 的整数倍。形状依次为 (1, 1,440,000, 1) → (1, 90,000, 256) → (1, 15,000, 512) → (1, 3,000, 1,024) → (1, 750, 2,048) → 输出头 (1, 750, 8,192)。这 750 个向量经过文本嵌入的无权重 embed_norm,覆盖 <|soft_audio_start|> 与 <|soft_audio_end|> 之间的 750 个 <|audio|> 占位 token(id 200038)。10 秒得到 125 个 token,与 Hugging Face 博客的说法一致;一小时则是 45,000 个。这一分钟音频在音频塔上约花 0.59 TFLOP,不到解码器块的矩阵乘在 prefill 这 750 个 token 时所花约 64 TFLOP 的 1%(750 × 2 × 42.78B)。音频塔输出的是连续向量,而不是码本条目,也不需要适配器:它自己的投影直接映射到 8,192,配置检查也强制要求这一点,因为“音频编码器的输出直接散布到文本嵌入上”。
因果,所以能流式处理。 每个卷积都在左侧填充 6 帧,右侧不填充;卷积类及其填充缓存原封不动地继承自 Voxtral Realtime(modeling_voxtral_realtime.py)。每级两个卷积,每个往回看 6 帧,由此得到一个 token 的感受野(推算):
整个感受野都落在该 token 自己的 80 ms 之内或之前,没有任何前瞻。有了 padding_cache,每个卷积在相邻两个分块之间保留自己最后 6 个输入帧,每条流共 46,080 个值,BF16 下为 90 KiB(推算)。由于缓存提供了精确的左侧上下文,而且 patch 从不跨越 1,920 个采样点的边界,按 80 ms 分块输入应当能复现离线输出(我们的理解)。
实现细节
MuseSparkAudioModel.forward:先是hidden_states = input_values.unsqueeze(-1),再是四个MuseSparkAudioLayer,最后是self.post_proj_norm(self.proj(self.norm(hidden_states)))。一个层由MuseSparkAudioPatchEmbedding(reshape(batch_size, seq_len // self.patch_size, self.patch_size * channels),然后self.norm(self.proj(...)))和其后的两个MuseSparkAudioConvBlock组成,每个卷积块计算 MLP(RMSNorm(conv(x))) + x。MuseSparkAudioCausalConv1d(VoxtralRealtimeCausalConv1d)使用left_pad = (kernel_size - 1) * dilation + 1 - stride= 6 和groups=hidden_size(逐通道)。音频部分的 RMSNorm 带可学习权重,eps 为 1e-6;post_proj_norm之后接的是无权重的文本embed_norm(eps 1e-5)。get_audio_features用num_tokens = (lengths + samples_per_token - 1) // samples_per_token丢掉只含填充的 token。llama.cpp 的muse-spark-audio.cpp沿用同样的顺序,并且“直接映射到文本隐藏维度,没有适配器”。
7. 长上下文与内存账
百万 token 的上下文要让 Muse Spark Open 付出多少代价?Glimmer 的 32 GB 预算装下权重之后,又还剩多少?大部分功劳要归于 §2.2 的层排布。只有 16 个全局层的缓存随上下文增长,所以一条 1M token 的序列只需 64.4 GiB 的 BF16 KV cache,而不是 248 GiB;位置也完全不需要 RoPE 缩放。真正还在增长的是注意力的计算量:超过约 164K 个 token 之后,Spark 每个 token 花在注意力上的 FLOPs,会超过它全部权重矩阵加起来的总和。除非注明出处,本节的数字都是我们根据两份配置、按单条序列算出来的,不是实测值。
7.1 不做 RoPE 缩放的一百万个位置
Spark 是怎么做到一百万个位置的?配置里直接声明了这个数,而两个模型的配置都没有要求任何 RoPE 缩放。Spark 的 config.json 把 max_position_embeddings 设为 1,048,576,模型卡列出“上下文长度 | 推理时 1M”。Glimmer 的配置设为 131,072,它的模型卡写作“131,072+”,报告则写作“128K+”;报告在第二个中期训练阶段把窗口从 32K 扩展到 128K(§9.1)。两者用的是同一个 RoPE 配置块 {"rope_theta": 500000.0, "rope_type": "default"},没有 YaRN 或其他缩放系数。相比之下,DeepSeek-V4 是用系数为 16 的 YaRN,把一个 65,536 token 的设计拉伸到 1,048,576 个位置(DeepSeek-V4 那篇,§9.1)。
§3.4 解释过 Muse 为什么可以省掉这一步。不管文档多长,局部层比较的两个 token 相距总在 0 到 2,047 个位置之间,所以它的 RoPE 角度从不超出训练时见过的范围。全局层没有位置编码,也就无所谓外推;位置信息是通过因果掩码和残差流传到它那里的。
随长度变化的,是全局层的注意力被摊得有多薄:在 1M 时,一次 softmax 最多要覆盖 1,048,576 个 key。§3.2 说明过,在两个模型里,QK-norm 和固定的缩放系数把每个 logit 都限制在 −43.784 到 +43.784 之间。长上下文要用掉这个区间的多少?
直白地说:设有一个相关的 key,以及 $N$ 个 logit 为 0 的无关 key。相关 key 的 logit 达到 $\ln N$ 时,它就能分到一半的注意力权重:8K 上下文时是 $\ln 8{,}191 \approx 9.0$,1M 时是 $\ln 1{,}048{,}575 \approx 13.9$(推算)。从 8K 到 1M,一个头只需把 logit 再提高 4.85,而 1M 时所需的 13.9 仍不到上限的三分之一。我们的理解:在长上下文中,风险在于注意力被稀释,而不是遇到没见过的位置;这个上限留出了抵抗稀释的余地。
实现细节
- 任何地方都没有缩放。 两份配置都用
rope_type: default,也都没有original_max_position_embeddings;默认的 RoPE 初始化返回attention_factor = 1.0 # Unused in this type of RoPE(modeling_muse_spark.py)。§3.4 引用了只把 RoPE 交给局部层的那行代码。 - 用满整个窗口。 Meta 的部署页面在 NVIDIA 上用
--max-model-len 1048576启动 vLLM。对于 llama.cpp,同一页面提醒,上下文会在-np个槽位之间平分,“所以长上下文智能体应该用 -np 1”。 - Glimmer: Meta 的 Glimmer 部署页面用
-c 131072 -np 1启动 GGUF,预期每个槽位分到 131,072 个 token。如果文件里的context_length元数据是过时的,llama.cpp 会把槽位钳制在那个更小的值上:“没有任何服务参数能覆盖这一点。”页面给出了一个脚本,把这个键改写为 131072。
7.2 逐层算 KV cache
一条序列的缓存有多大?只有全局层那一份会随上下文增长。§3.1 算过一个 token 在一层里存什么:每个 KV 头的 K 和 V,Spark 是 $2 \times 16 \times 64 = 2{,}048$ 个数(BF16 下 4 KiB),Glimmer 是 $2 \times 2 \times 128 = 512$ 个数(1 KiB)。局部层最多保留 2,048 个 token,只有全局层要把每 token 的条目乘以完整的上下文长度 $c$。记每 token 每层的字节数为 $b$:
\[\mathrm{KV}(c) \;=\; \underbrace{n_{\text{global}}\, b\, c}_{\text{随上下文增长}} \;+\; \underbrace{n_{\text{local}}\, b\, \min(c,\, 2{,}048)}_{\text{封顶}}\]直白地说(§2.2 预告过这些数字):每来一个新 token,Spark 的缓存增加 $16 \times 4$ KiB = 64 KiB,Glimmer 的增加 $13 \times 1$ KiB = 13 KiB;如果每层都是全局层,则分别要增加 248 KiB 和 52 KiB。封顶的部分,Spark 是 $46 \times 2{,}048 \times 4$ KiB = 368 MiB,Glimmer 是 $39 \times 2{,}048 \times 1$ KiB = 78 MiB。增长的部分分别在 5,888 和 6,144 个 token 处超过封顶部分(均为推算)。Meta 的设置页面也是这么说的:“只有全注意力层为整个上下文保留 KV cache,所以 KV 内存在这 16 层上随上下文长度增长,在其余层上保持不变。”
下面的动画分四步搭出 Spark 的这笔账:每 token 每层 4 KiB;46 个封顶的局部层;16 个不断增长的全局层;最后是总量,旁边是“全部为全局层”的虚线轮廓。请留意局部部分:8K 时它还占很大一块,到 1M 时只剩薄薄一条。

下表把一条序列的缓存拆成增长的全局部分和封顶的局部部分(均为推算)。“全部为全局层”几列是假想对照,不是真实模型。Glimmer 带括号的数值已超出它 131,072 token 的窗口。
| 上下文(token) | Spark 全局 + 局部,BF16 | Spark 合计,BF16 / FP8 | Spark 若全部为全局层 | Glimmer 全局 + 局部,BF16 | Glimmer 合计,BF16 / FP8 | Glimmer 若全部为全局层 |
|---|---|---|---|---|---|---|
| 8,192 | 0.500 GiB + 368 MiB | 0.859 / 0.430 GiB | 1.938 GiB | 0.102 GiB + 78 MiB | 0.178 / 0.089 GiB | 0.406 GiB |
| 32,768 | 2.000 GiB + 368 MiB | 2.359 / 1.180 GiB | 7.750 GiB | 0.406 GiB + 78 MiB | 0.482 / 0.241 GiB | 1.625 GiB |
| 131,072 | 8.000 GiB + 368 MiB | 8.359 / 4.180 GiB | 31.000 GiB | 1.625 GiB + 78 MiB | 1.701 / 0.851 GiB | 6.500 GiB |
| 262,144 | 16.000 GiB + 368 MiB | 16.359 / 8.180 GiB | 62.000 GiB | (3.250 GiB + 78 MiB) | (3.326 / 1.663 GiB) | (13.000 GiB) |
| 1,048,576 | 64.000 GiB + 368 MiB | 64.359 / 32.180 GiB | 248.000 GiB | (13.000 GiB + 78 MiB) | (13.076 / 6.538 GiB) | (52.000 GiB) |
有三点值得注意:
- 封顶只在短上下文时才要紧。 8K 时,局部层约占 Spark 缓存的 42%;到 1M 时只占 0.56%。
- 与“全部为全局层”之比逐渐趋近层数之比:Spark 为 16/62 = 0.258,Glimmer 为 13/52 = 0.25。1M 时 Spark 的比值是 0.260,vLLM 博客称之为“略高于全注意力所需的 ¼”。
- 在 GB300 上用 TensorRT-LLM 时,适用的是 FP8 那一列。 只要开启分块 prefill(chunked prefill)或 KV 复用,TensorRT-LLM 的部署指南就要求在 GB300 上使用 FP8 缓存,因为“在
SM103上,头维度为 64 时,融合的分页上下文 FMHA kernel 只有 FP8 KV-cache 数据类型的版本”。(SM103是 GB300 的 GPU 架构。)
Glimmer 的 131,072 那一行可以和实测值对照。Meta 的量化页面报告,在 llama.cpp 中用满 131,072 token 的上下文时,“KV cache 与计算缓冲区 | 2.1 GiB”,与我们算出的 1.70 GiB 加上约 0.4 GiB 的计算缓冲区相符(我们的理解)。该页面给出的理由也和我们一样:“只有四分之一的层持有全长缓存。”
下面的 3D 图表把两个模型放在同一条轴上,从 1K 到 1M token,Spark 在后排,Glimmer 在前排。蓝色代表全局层,青绿色代表局部层(滑动窗口层),轮廓线是“全部为全局层”的假想对照。坐标轴一开始是对数刻度:每个上下文长度上,局部层与全局层两部分并排,各自按对数轴绘制,所以青绿色柱子从 2,048 个 token 起不再升高,蓝色柱子则一直增长。切换到“线性”后,两部分按实际比例堆叠成一根柱子。先一步步走一遍,再切换到 FP8,每根柱子都减半。“每 token 计算量”视图画的是 §7.3 接下来要推导的注意力 FLOPs。把鼠标悬停在任意柱子上,可以看到它的精确值。Glimmer 那一排止于 131,072。
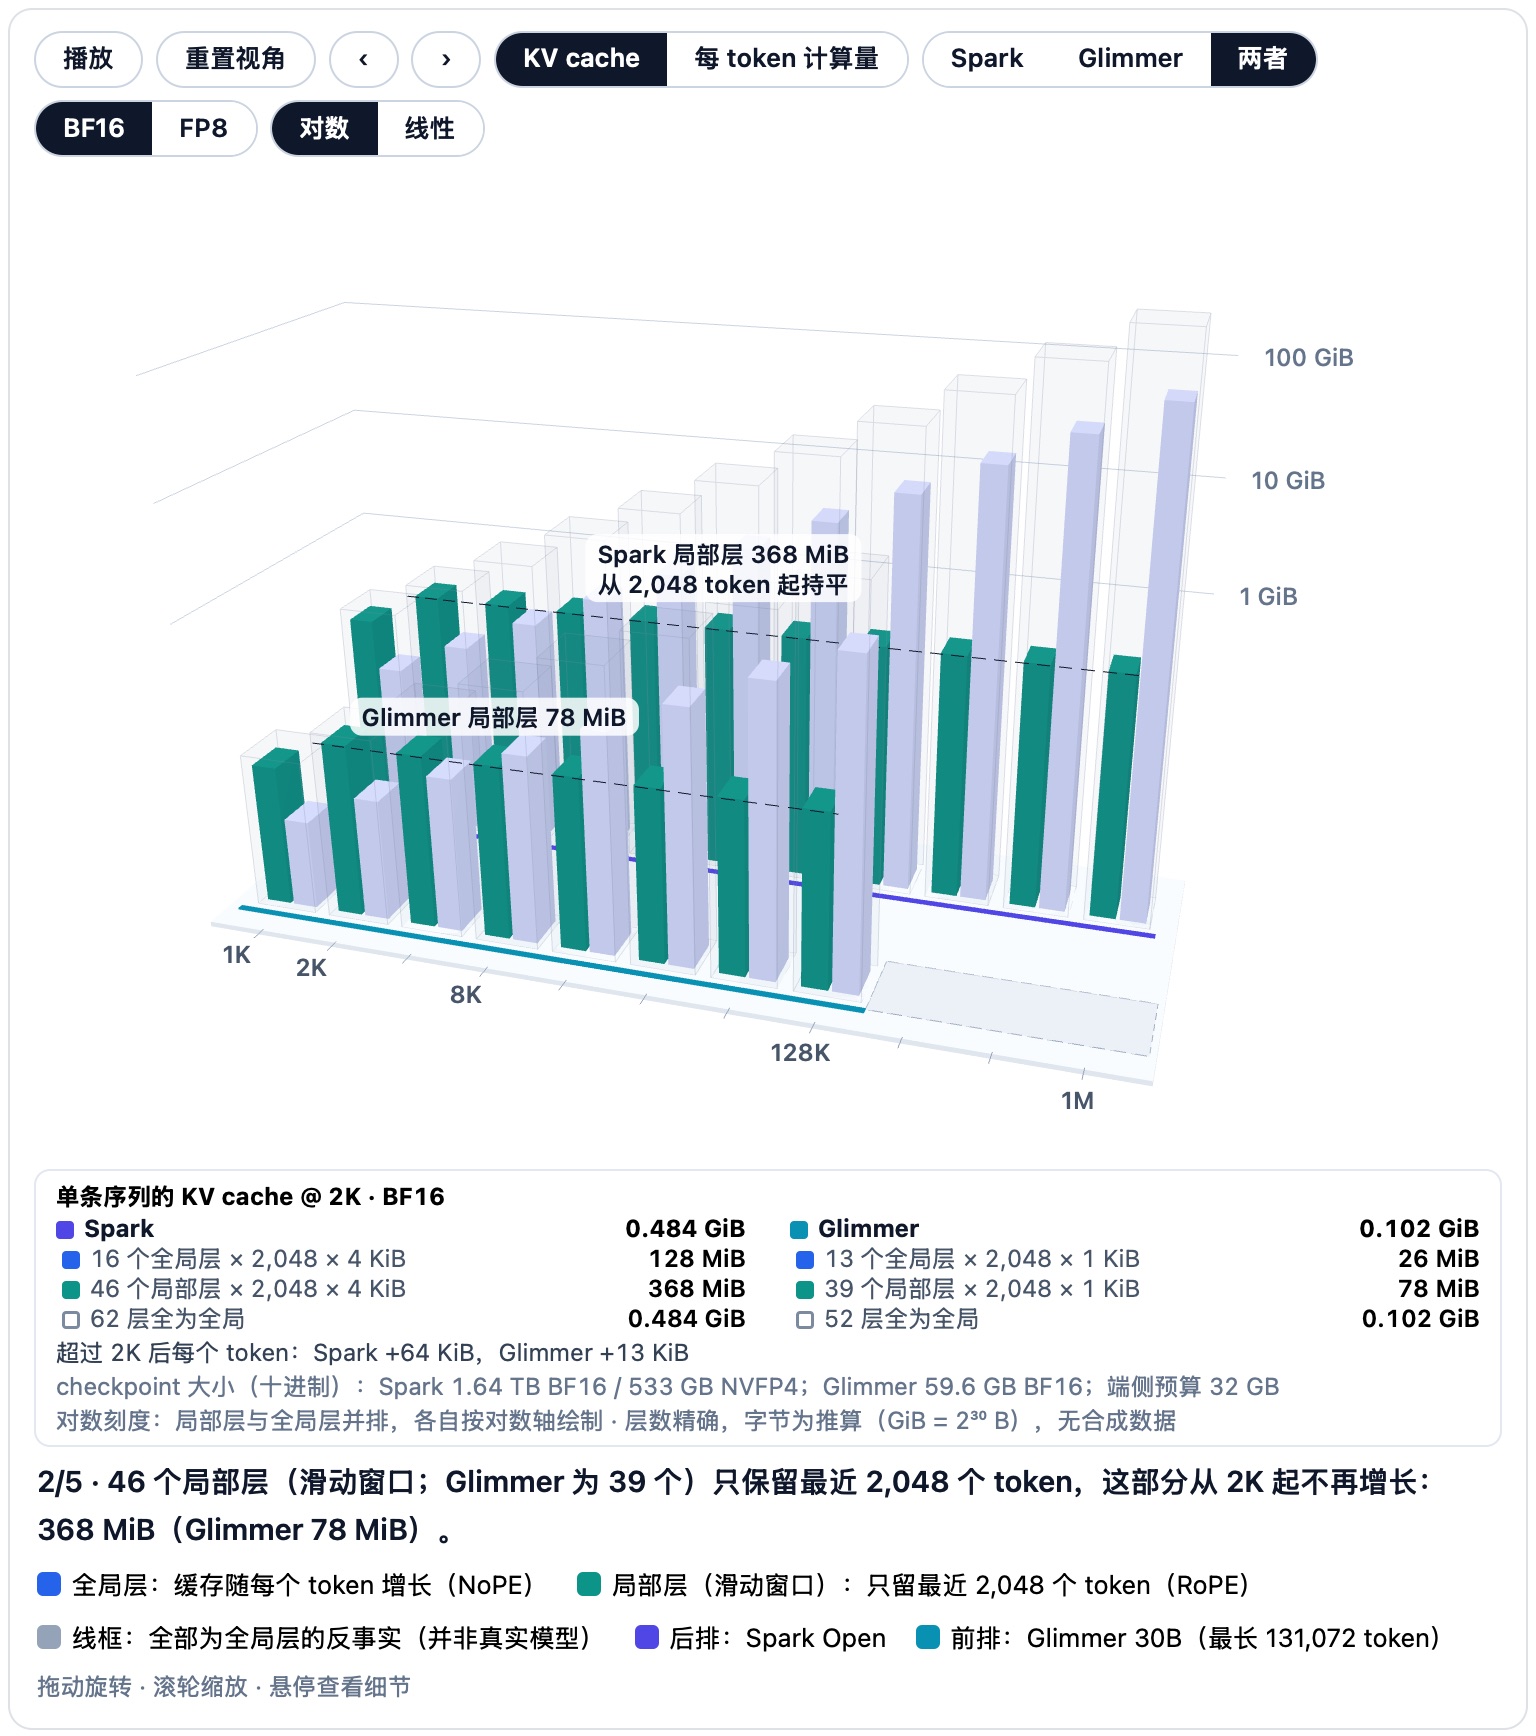
数字从哪来
- 配置键:
num_key_value_heads为 16 / 2,head_dim为 64 / 128,sliding_window为 2048,layer_types中分别有 16 / 13 个full_attention条目。字节数:BF16 每个数 2 字节,FP8 每个数 1 字节,忽略缩放因子。 - 窗口: Transformers 给每个局部层一个
DynamicSlidingWindowLayer,它保留“最近self.sliding_window - 1个 token”(self.keys = full_key_states[:, :, -self.sliding_window + 1 :, :],cache_utils.py)。加上新进来的 token,局部层看到的是当前 token 加上之前的 2,047 个。缓存 2,047 个而不是 2,048 个 token,Spark 的局部部分就是 367.8 MiB 而不是 368.0 MiB,差别可以忽略。 - 没有计入: 激活值、分页开销,以及草稿模型自己的缓存(约 40 MiB,§8.2)。GiB = $2^{30}$ 字节,GB = $10^9$ 字节。
- 用来对比量级的假想对照: 如果 Spark 的 16 个全局层改用 DeepSeek-V2 式的 MLA 条目,每个 token 576 个数(512 维潜向量加 64 维 RoPE key,arXiv 2405.04434),1M 时的缓存会降到 18.4 GiB(推算)。对 Glimmer 而言,这个潜向量反而比它 512 个数的 GQA 条目还大。§3.5 介绍了 Glimmer 试过又放弃的 MLA 变体。
7.3 每个 token 的计算量
解码一个 token 要做多少运算?权重矩阵是一笔固定开销,注意力则是一笔随上下文增长的开销。固定开销按惯例计为每个用到的权重 2 次 FLOP,作用于激活的解码器参数(§2.3)加上 lm_head:
注意力部分,每个 query 头都要给每个可见的 key 打分,再把这个 key 的 value 加进输出:两次长度为 $d$ 的点积,所以每层每个 key 要 $4 \times n_q \times d$ 次 FLOP,Spark 为 32,768,Glimmer 为 16,384。GQA 并不降低这项开销:共享 KV 头省的是字节,每个 query 头仍要给每个 key 打分。对 Spark,当 $c \ge 2{,}048$ 时:
\[A(c) \;=\; 32{,}768 \times \big(16\,c + 46 \times 2{,}048\big) \;=\; 524{,}288\,c \;+\; 3.087 \times 10^{9}\ \text{FLOP}\]下表给出每个解码 token 的注意力 FLOPs 及其占总量的比例(推算)。softmax、各个归一化和门控的逐元素乘法没有计入;门控的投影算在固定开销里。
| 上下文(token) | Spark 注意力 | Spark 占比 | Spark 若全部为全局层 | Glimmer 注意力 | Glimmer 占比 |
|---|---|---|---|---|---|
| 8,192 | 7.4 GFLOP | 7.7% | 16.6 GFLOP | 3.1 GFLOP | 5.4% |
| 32,768 | 20.3 GFLOP | 18.6% | 66.6 GFLOP | 8.3 GFLOP | 13.5% |
| 131,072 | 71.8 GFLOP | 44.7% | 266.3 GFLOP | 29.2 GFLOP | 35.5% |
| 1,048,576 | 552.8 GFLOP | 86.2% | 2,130.3 GFLOP | — | — |
当 $A(c) = 88.87 \times 10^9$ 时,注意力追上权重矩阵:
\[c^{*} \;=\; \frac{88.87 \times 10^{9} - 3.087 \times 10^{9}}{524{,}288} \;\approx\; 163{,}600 \ \text{个 token} \;\approx\; 164\text{K}\]对 Glimmer,由 $212{,}992\,c + 1.309 \times 10^{9} = 53.02 \times 10^{9}$ 解得约 242,800 个 token,超出了它的窗口,所以在 Glimmer 训练过的整个长度范围内,权重矩阵始终占大头(推算)。
直白地说:在 1M 时,Spark 每个 token 在注意力上花 552.8 GFLOP,其中 549.8 GFLOP 落在 16 个全局层里,而其余所有部分加起来只有 88.9 GFLOP。对一个 1M token 的提示词做 prefill 约需 $3.85 \times 10^{17}$ FLOP,其中四分之三是注意力(推算)。
FLOPs 不等于时间。解码通常受限于内存流量,而缓存在这里第二次起作用。用 NVFP4 权重、batch 为 1 时,一个解码步要读约 54 GB 权重,其中一半是 BF16 的注意力投影(推算)。这些读取中约 39 GB(注意力、降维与升维投影、路由器和输出层)由一个 batch 中的所有序列共享;专家部分则会随着不同 token 挑选不同专家而增长。每条 1M token 的序列还要另外读取它自己的 FP8 缓存,每步 34.6 GB,在 batch 为 1 时就已是权重字节数的 0.64×(推算)。我们的理解:长上下文的 batch 受限于缓存带宽,所以“62 层中只有 16 层”这个比例既决定容量,也决定吞吐。
我们怎么算的
- 线性部分: 42.78B 激活解码器参数包括注意力、路由器、降维与升维投影,以及每层 8 个专家(§4)。
lm_head另加 $202{,}048 \times d$。注意力只计 $QK^\top$ 和 $AV$;$c \ge 2{,}048$ 之后,每个局部层按 2,048 个 key 计。 - prefill: 全局层每个(query,key)对花 524,288 FLOP,共 $c(c+1)/2$ 个因果对,≈ $2.88 \times 10^{17}$;线性层为 $88.87\ \text{GFLOP} \times c \approx 9.3 \times 10^{16}$;局部层 ≈ $3.2 \times 10^{15}$。
- 每个解码步的字节数(NVFP4,batch 为 1):第 1–60 层的激活专家,每个权重 0.5625 B(4 bit,外加每 16 个权重一个 FP8 缩放因子),13.6 GB;第 0 层和第 61 层的 BF16 专家,1.6 GB;注意力,27.0 GB;降维与升维投影,8.3 GB;FP32 路由器,0.5 GB;
lm_head,3.3 GB。合计 ≈ 54.4 GB,尚未计入 KV 读取和通信。共享的非专家部分为 27.0 + 8.3 + 0.5 + 3.3 ≈ 39.2 GB。
7.4 装下权重
权重需要多少内存,又能装在哪里?即便量化到 4 bit,Spark 也需要一台多 GPU 节点或两台大内存的 Mac;只有社区做的 2 bit 版本能降到一台 256 GB 的机器上。Glimmer 较小的那个量化版本,连同视觉投影器和满 131,072 token 的缓存,实测为 19 GiB。
BF16 的 Spark。 Hugging Face API 统计出完整 checkpoint 中有 821,906,490,368 个 BF16 参数和 130,039,296 个 FP32 参数,各编码器也包括在内:共 1,644.3 GB,即 1.496 TiB(推算)。文档给出的是“约 1.65 TB”。
NVFP4 的 Spark。 NVFP4 仓库中有 533.0 GB 权重。§4.5 根据 Hub 上的 dtype 计数和仓库的 modules_to_not_convert 列表,说明了哪些部分被量化:第 1–60 层的路由专家,以 4 bit 数值存储,每 16 个权重配一个 FP8 缩放因子(E4M3,即 4 位指数、3 位尾数的 8 bit 浮点数)。第 0 层和第 61 层的专家保持 BF16(SGLang 团队的 LMSYS 博客也这么说),除 FP32 路由器之外的其余部分同样是 BF16。下表按这条界线拆分这 533 GB。
| NVFP4 checkpoint 的组成(由 HF dtype 计数推算) | 大小 |
|---|---|
| 第 1–60 层的 4 bit 专家权重,加上 FP8 块缩放因子 | 386.55 + 48.32 GB |
| 第 0 层和第 61 层的 BF16 专家 | 51.54 GB |
BF16 注意力(q、k、v、o、gate) |
27.04 GB |
| BF16 降维与升维投影 | 8.32 GB |
BF16 嵌入、lm_head、各编码器、归一化 |
10.72 GB |
| FP32 路由器与逐专家数值 | 0.52 GB |
| 合计 | 533.01 GB |
简而言之,只有专家做了量化,而且只限第 1–60 层。在这些专家内部,格式是 W4A4,即 4 bit 权重加 4 bit 激活;LMSYS 的描述是“60 层中的专家权重和激活均为 NVFP4”。
在哪里运行。 Meta 的文档把 BF16 版本“部署在八张 GPU 上,例如 8 × B300”,把 NVFP4 版本“部署在单个 4-GPU 的 NVIDIA Blackwell 节点上”;研究博客则用“两台 Apple M5 Ultra Mac Studio、配合最新的 MLX 框架”运行这个模型。AMD MI355X/MI350X 和 Intel Xeon 6 的配置见硬件平台页面。
关于两台 Mac,研究博客给出“每台 Mac Studio 最多 512 GB”和“1.2 TB/s 的内存带宽”;开发者博客说,MLX 运行的是 NVFP4 checkpoint,它的张量并行“把模型的每一层都切分到两台机器上”。NVFP4 权重占去 1,024 GB 中的 52%,剩下的 491 GB 甚至装得下 1M token 的 BF16 缓存(64.4 GiB,即 69.1 GB)。每台 Mac 每个解码步读约 27 GB 权重(§7.3 中 54 GB 的一半),因此在不计缓存读取和通信的情况下,解码速度的上限约为 44 tokens/s(推算的上界)。
合作方格式。 下表列出其他公开版本;大小是各 Hugging Face 仓库权重文件之和(推算)。从 dtype 计数和配置来看,AMD 的 MXFP4(一种微缩放(microscaling)4 bit 浮点格式,每 32 个数共用一个缩放因子)、Intel 的 INT4 和 MLX 3-bit 版本都沿用了 NVFP4 的划分:第 1–60 层的专家做量化,其余部分保持 16 bit(推算)。
| 格式 | 发布方 | 大小 |
|---|---|---|
| MXFP4(Quark),W4A4 | AMD | 508.86 GB |
| PTPC-FP8(Quark),全部专家和注意力均为 FP8 | AMD | 832.75 GB |
| INT4(AutoRound),面向 Xeon 6 | Intel | 499.81 GB |
| MLX 3-bit | mlx-community | 436.14 GB |
| GGUF Q2_K / Q4_K_S / Q8_0 | ggml-org | 304.08 / 470.07 / 871.65 GB |
| 动态 GGUF,UD-IQ1_S 到 UD-Q4_K_XL | Unsloth | 175.64–505.50 GB |
开发者博客还列出了一个面向即将推出的 Crescent Island GPU 的 Intel MXFP4 版本(“四张 160 GB 的卡就能装下模型”)。在最小的一端,Unsloth 的指南说它的 2 bit UD-IQ2_XXS(一个 225.57 GB 的文件)“装得进 256GB 内存”。
32 GB 以内的 Glimmer。 让 Glimmer 选择稠密结构的 32 GB 上限(§4.6),也决定了它的量化目标。按报告“量化”一节的说法,权重“在 BF16 下占 55.7 GB”,而部署时还要给“未量化的 KV cache、草稿模型、感知编码器”留出空间,因此需要“低于 20 GB 的语言模型权重”。
报告先按留出集(held-out)上负对数似然的变化给训练后量化方案排序,再在 15 个下游任务上检验。最终保留两种,都由 llama.cpp 的 4、5、6 bit K-quant 块格式(Q4_K、Q5_K 和 Q6_K)组合而成。Q4KM 是固定的配置:主体用 Q4_K,部分层的 value 投影和 FFN down 投影上调到 Q6_K,输出层用 Q5_K。EvoPress 在 418 个权重单元(按我们的统计,52 层 × 8 个张量,再加嵌入和输出层)上做进化搜索,把“51、130 和 237 个单元分别分配给 Q4_K、Q5_K 和 Q6_K,分组大小都是 32”,总计 19.65 GB。Greedy-KL 是报告在同一组格式上做的另一种搜索:它从 Q6_K 出发,按“每节省一个字节所增加的校准 KL 散度”逐个降低张量精度,再用剩下的空间把最敏感的 Q4_K 张量升到 Q5_K。NVFP4/MXFP8 是一种浮点方案:每一层的 value、FFN down 和输出投影都上调精度,其余部分用“16 个权重一块”的 NVFP4,上调的张量用“32 个权重一块”的 MXFP8(一种微缩放 8 bit 浮点格式)。EvoPress 的验证损失最低,Q4KM 的占用最小,所以报告分别选它们用于 32 GB 和 24 GB 的显卡。
下表把报告中的各个变体与实际发布的文件并列。标有 ≈ 的大小,是我们从报告的内存图上读出的近似值。
| 变体 | 语言模型权重 | 15 项任务平均准确率(报告) | 发布形式 |
|---|---|---|---|
| BF16 | 55.7 GB | 75.7 | safetensors,含视觉塔共 59.55 GB |
| EvoPress | 19.65 GB | 75.6 | KQuant-Dynamic-Q4_K_XL.gguf,19.7 GB,“适用于 32 GB 显存” |
| Greedy-KL | ≈ 19.4 GB | 75.3 | — |
| Q4KM | ≈ 16.6 GB | 74.8 | KQuant-17GB-Q4_K_M.gguf,16.8 GB,“可装进 24 GB 显存” |
| NVFP4/MXFP8 | ≈ 19.6 GB | 74.4 | Meta 未发布;RadixArk 的第三方版本 Muse-Glimmer-NVFP4,19.67 GB |
量化页面对 K-Quant-17GB 的描述(“主体为分组大小 32 的 Q4_K,attn_v 和 ffn_down 投影用分组大小 128 的 Q6_K,输出层用分组大小 128 的 Q5_K”)与报告中的 Q4KM 一致。把 EvoPress 对应到 K-Quant-Dynamic 文件、把 NVFP4/MXFP8 对应到 RadixArk 的版本,是我们根据格式和大小做出的理解。以 27.855B 个语言模型权重计,两个 GGUF 文件平均每个权重 4.81 和 5.64 bit(推算)。
实测的预算让这笔账闭合。量化页面报告:“K-Quant-17GB 加上视觉投影器、用满 131,072 token 上下文时,实测占用 19 GiB 显存”,其中文本模型 15.6 GiB,投影器 1.3 GiB,KV cache 与计算缓冲区 2.1 GiB。“DFlash 草稿模型另需约 1.5 GiB。”在 Apple 芯片和 CUDA 上,Glimmer 还可以通过 ExecuTorch 运行。据部署页面介绍,“随后由 torch.export 提前把整个计算图向下编译(lowering):在 CUDA 上编译为 Triton,在 Apple 芯片上编译为 MLX 原生或自定义的 Metal kernel。”它的 16 个预构建导出版本使用上述两种 GGUF 量化,大小为 17.9–31.5 GB,上下文限制在 128K。DFlash 变体把 §8.2 的草稿模型打包进同一个文件,与目标模型共用嵌入和输出层。
数字从哪来
- checkpoint 字节数: 由 HF API 的 dtype 计数,按 BF16 × 2 B、FP32 × 4 B、打包的 4 bit(U8)× 1 B、FP8 缩放因子 × 1 B 算出。两个总数与 API 给出的
usedStorage相差都在 0.03 GB 以内。Hub API 列出的 NVFP4 仓库quantization_config中带有modules_to_not_convert列表;AMD 公开的 MXFP4 配置也排除了同样两层的专家。 - Glimmer 标有 ≈ 的大小,是我们从报告的内存–质量图上读出的近似值;EvoPress 的 19.65 GB 取自报告正文。准确率取自报告的“量化后的下游准确率”表。文件大小取自 GGUF 仓库。
- 两台 Mac 的余量数字没有考虑激活值、运行时开销和通信。
8. 投机解码:用 DFlash 草稿模型,而不是 MTP 头
Muse 模型的草稿 token 从哪里来?GLM-5.3 和 DeepSeek-V4 都在 checkpoint 里带着一个 MTP 层,两个 Muse 模型都没有。它们的投机解码依靠独立的草稿模型 checkpoint,这些草稿模型基于 DFlash 或与之相近的方法:Glimmer 有一个官方草稿模型,Spark 有三个第三方草稿模型。它们都是 5 层的滑动窗口模型,读取目标模型的隐藏状态,一次前向传播就提出 7 到 15 个 token。
8.1 一段话讲清块扩散(block diffusion)起草
逐个 token 解码会让大模型卡在显存带宽上。投机解码让一个便宜的草稿模型先往后猜几个 token,目标模型用一次前向传播检查整段猜测,保留猜对的前缀(DeepSeek-V4 那篇,§12.1)。DFlash 把每个 token 的延迟写成 $L = (T_\text{draft} + T_\text{verify})/\tau$,其中 $\tau$ 是每轮期望被接受的 token 数,“包括目标模型产生的 bonus token”。
DFlash 的草稿模型是一个小型的块扩散模型。扩散语言模型靠去噪来生成:一块位置一开始全是掩码 token,模型并行地把它们全部填出来,通常要迭代好几步。DFlash 的草稿模型在最后一个已验证 token 后面接上一整块掩码 token,只用一次双向前向就把整块填满;自回归草稿模型则每起草一个 token 就要走一步。省下来的预算可以花在深度上:“一个生成 16 个 token 的五层 DFlash 草稿模型”,在延迟和接受率上都胜过起草 8 个 token 的 EAGLE-3。EAGLE-3 是论文用作对照的自回归草稿模型,只有一个 Transformer 层。
草稿模型以目标模型若干层的隐藏状态为条件,这些层“从浅到深均匀采样”,它们的隐藏状态经拼接、投影之后,注入“每个草稿模型层的 Key 和 Value 投影”。EAGLE-3 也读取目标模型的隐藏状态,但只是把它们与自己的 token 嵌入混合后作为输入。嵌入层和输出层与目标模型共用,并保持冻结。训练时,每个块从一个随机采样的锚点 token 开始,其余位置全部掩码,块内第 $k$ 个位置的损失乘以权重 $w_k = e^{-(k-1)/\gamma}$,$\gamma$ 决定权重衰减的快慢(论文中 16 token 的块取 7)。
直白地说:Glimmer 的草稿模型收到最后一个已验证 token 加 15 个掩码,一次返回 15 个猜测。目标模型用一次前向给这 15 个打分。如果前四个都对,这一轮就产出五个 token:四个被接受的,加上目标模型自己给出的下一个 token,也就是 bonus token。$\tau$ 就是这个数在多轮上的平均值。
为什么没有 MTP 头?我们在两份配置里都没找到 MTP 相关的键,在 Glimmer 的权重索引和 Spark MLX 转换版本的索引里没找到 MTP 张量,在 Transformers 和 llama.cpp 的计算图里也没找到 MTP 代码。Glimmer 报告(“投机解码”一节)说它采用 DFlash,“与当前开源领域的领先标准保持一致”。DFlash 论文在自带 MTP 头的目标模型上做了 SGLang 测试,报告说它“在两者都可用时,始终优于原生 MTP”。我们的理解是,实际的好处在于解耦:放在 checkpoint 之外的草稿模型,可以等目标模型冻结之后再训练,可以单独量化,可以替换,也可以干脆不用。Spark 发布时就有来自 SGLang 和 vLLM 两方(RadixArk 和 Inferact)的草稿模型;按仓库的创建日期,Glimmer 发布后两到四天,第一批社区草稿模型就出现在了 Hugging Face 上。相比之下,GLM-5.3 把 MTP 层作为 checkpoint 的第 78 层一起发布(GLM-5.3 那篇,§6.2)。
8.2 Glimmer 的 assistant 草稿模型
Meta 的草稿模型是 Muse-Glimmer-30B-assistant。它的配置有 5 个 sliding_attention 层,窗口 2,048,宽度与目标模型相同(隐藏维度 6,656,FFN 19,968)。它用 32 个 query 头和 8 个 KV 头,头维度 128,而目标模型只有 2 个 KV 头。块大小为 16,掩码 token 是 201818;按我们对分词器 ID 顺序的理解,它是 <|reserved_special_token_1818|>。抽取隐藏状态的层(tap layer)是 target_layer_ids: [1, 13, 25, 37, 49],用报告的话说是“在目标模型上均匀分布”。一轮起草的过程如下:
- 收集。 目标模型在新接受的 token 上运行,保留五个抽取层的隐藏状态:每个 token $5 \times 6{,}656 = 33{,}280$ 个数。
- 投影。
fc把 33,280 维映射到 6,656 维,再过一个 RMSNorm,每个已接受的 token 得到一个上下文向量。 - 构建块。 最后一个已验证 token 加上 15 个 token 201818 的副本,用目标模型的嵌入表做嵌入,得到 16 个向量。生成器跳过了目标模型的无权重嵌入归一化,这正是代码把这个归一化放在嵌入表之外的原因(§5.4)。
- 运行 5 层。 query 只来自块内的 16 个位置;key 和 value 来自上下文向量,后面接上块本身,在 2,048 的窗口内不加因果掩码。
- 读出。 第 1–15 个位置经过目标模型的
lm_head,得到 15 个相互独立的分布,由目标模型用一次前向验证。
按我们的统计,每层有 466,892,032 个参数:$q$ 27.26M,$k$ 和 $v$ 各 6.82M,$o$ 27.26M,SwiGLU 398.72M,再加上归一化。五层、fc($33{,}280 \times 6{,}656 = 221{,}511{,}680$)和两个归一化合计 2,555,985,152,与 safetensors 的计数完全一致。BF16 下为 5.11 GB,GGUF 格式为 1.63 GB,约为目标模型 26.5B 解码器块与输出层参数的十分之一。它的缓存在任何上下文长度下都是每条序列 $5 \times 4$ KiB $\times 2{,}048$ = 40 MiB(推算)。
按报告的说法,它是“利用目标模型的 on-policy rollout,以监督方式离线训练”的,锚点“以 1/16 的比例采样”,目标函数为 D-PACE(Dynamic Position-Aware Cross-Entropy,动态位置感知交叉熵)。模型卡报告了用 K-Quant-17GB 目标模型和量化后的草稿模型、在 batch 为 1、贪心解码下测得的速度:
| 设备(运行时) | 不用草稿模型 | 使用 DFlash | 加速比(模型卡) |
|---|---|---|---|
| RTX 5090(llama.cpp) | 74.9 tok/s | 233.4 tok/s | 3.1× |
| Apple M4 Max(ExecuTorch) | 23.7 tok/s | 37.8 tok/s | 1.5× |
| Apple M5 Max(ExecuTorch) | 26.6 tok/s | 50.2 tok/s | 1.8× |
DFlash 的速度是“在一组多样化提示词上”的平均值。实际部署时,Meta 的部署页面为 SGLang 设定的块大小是 5,llama.cpp 最多起草 4 个 token,CUDA 上的 ExecuTorch 最多 3 个。
实现细节
DFlashTokenCandidateGenerator(candidate_generator.py)用torch.cat([model_outputs.hidden_states[i][:, :num_last_main_model_tokens] ... for i in self.target_layer_ids], dim=-1)收集隐藏状态,用noise_ids = torch.cat([input_ids[:, -1:], self.noise_ids_mask...])构建块。它用self.cache.crop(-self.block_size)丢掉上一个块,再通过self.main_model_output_embeddings(outputs.last_hidden_state[:, 1:]...)读出。modeling_muse_glimmer_assistant.py:MuseGlimmerAssistantContextProjection持有self.fc = nn.Linear(encoder_input_size, config.hidden_size, bias=False)。注意力设置self.is_causal = False,使用kv_hidden_states = torch.cat([context_hidden_states, hidden_states], dim=1),并用create_bidirectional_sliding_window_mask构建掩码。
8.3 Spark 的 DFlash2 及其他路线
Meta 的 Hugging Face 组织下没有 Spark 的草稿模型。开发者博客点了两个名字,“由 SGLang(DFlash V2)和 vLLM(DSpark)构建”,NVIDIA 还发布了第三个。我们把这些资料中的“DFlash V2”“DFlash 2”和“DFlash2”理解为同一个 DFlash 后继版本;下面的配置字段与它的描述吻合。下表根据各自的配置和模型卡,把这三个草稿模型与 Glimmer 的放在一起比较。“参数量”一列中,Glimmer、RadixArk 和 NVIDIA 草稿模型的计数不含与目标模型共用的嵌入层和输出层;DSpark 的 5.30B 则包含它自带的 1.655B lm_head 和 0.21B 的 Markov 头,括号里的 3.44B 是去掉这两部分之后的数(推算)。
| 草稿模型(发布方) | 注意力 | 头数,Q / KV × 维度 | 块大小 | 目标抽取层 | 额外部件 | 参数量 |
|---|---|---|---|---|---|---|
| Glimmer assistant(Meta) | 5 层,非因果,窗口 2,048 | 32 / 8 × 128 | 16 | 1, 13, 25, 37, 49 | — | 2.556B |
| RadixArk DFlash2(SGLang) | 5 个 Qwen3 式层,非因果,2,048 | 64 / 8 × 128 | 8 | 1, 16, 30, 44, 59 | 选择器(秩 256,top-16),双抽头卷积 | 4.887B |
| NVIDIA DFlash2(TensorRT-LLM) | 5 层,非因果,2,048 | 128 / 16 × 64 | 8 | 3, 19, 31, 47, 59 | 选择器,卷积 | 4.38B |
| Inferact DSpark(vLLM) | 5 层,因果,2,048 | 128 / 16 × 64 | 7 | 13, 29, 45, 57, 61 + 最终输出 | Markov 头(秩 512),置信度头 | 5.30B(3.44B) |
DFlash 2。 Inco AI 的博客介绍了 RadixArk 草稿模型新增的两个部件。第一个是路径选择器。DFlash 对每个位置单独采样,会浪费好的候选:在 GSM8K 上,一个五层 Qwen3-4B 草稿模型第一个位置的首选只有 85.4% 的时候是对的,但正确的 token 有 99.5% 的时候落在前 16 名之内。DFlash 2 为每个位置保留 16 个候选,并用 $S_t(a,b) = U_t(b) + \langle A(a) \odot H(h_t),\, B(b) \rangle$ 给相邻位置的候选对打分。其中 $U$ 是 DFlash 自己的 logit,$A$ 和 $B$ 给“每个 token 一个紧凑的 256 维嵌入”,$H(h_t)$ 是一个上下文门控,“决定匹配中的哪些部分起作用”。在预先算好的分数上走一遍,就选出了路径,而“拒绝采样恢复了精确的目标分布”。第二个部件是包在每个子层周围的双抽头动态卷积 $k_{t,0} \odot x_t + k_{t,1} \odot x_{t-1}$,它把每个位置与前一个位置混合起来。
RadixArk 的 dflash_config 逐字段对得上:selector_top_k 为 16,selector_rank 为 256,conv_kernel_size 为 2,conv_group_size 为 16。按我们的统计,选择器增加 105.5M 参数,主要是两个 202,048 × 256 的码本;卷积增加 168.1M。块大小 8 的意思是“1 个当前 token + 7 个草稿 token”。这个草稿模型照搬了目标模型的输出乘子(0.1768)和软截断(20)。它配置的上下文是 1,048,576 个 token,但模型卡提醒:“配置上的对齐并不能证明草稿在完整 1M 上下文中的接受质量。”
RadixArk 报告的接受长度为:GSM8K 5.37,AIME26 4.19,GPQA Diamond 3.88,Video-MME short 3.74,MindCube 3.25。每个数都是每个验证步产出的补全 token 数,因此包含目标模型的 bonus token。测量在两个 GB300 副本上进行,使用块验证(block verification),温度 1.0,top-k 64;LMSYS 博客把块验证描述为对草稿前缀做整体判断,而不是逐个 token 判断。对这个草稿模型,开发者博客报告“在 AMD MI355X 上,单请求吞吐提升 3.7×,16 个并发请求时提升 2.9×,准确率不变”。
vLLM 上的 DSpark。 开发者博客说它“由 Inferact 基于 DSpark 训练,DSpark 是 NVIDIA 与 vLLM 团队共同开发的方法”。它“一次前向最多提出七个 token,并用一个轻量的头来刻画这些 token 之间的依赖关系”。vLLM 博客把它描述为采用“基于置信度的调度”的块扩散。这个 checkpoint 与 DFlash 有几处不同:注意力是因果的(dflash_config.causal: true),增加了 Markov 头和置信度头,而且它的层照搬了 Spark 自己的块结构,连输出门控和残差门也包括在内。它的配置里还有一个 metap 配置块(use_metap 为 true,base_width 为 256)。五个抽取层在 Spark 的排布中全都是全局层(这是我们的观察)。对 NVFP4 目标模型实测的接受长度,在 README 的标准测试集(从 MT-Bench 到 SWE-bench Pro)上为每轮 2.66–3.94 个 token。在 BEAM 100K、500K 和 1M 上,生成长度为 96 个 token 时分别是 3.03、3.09 和 3.00,一直到 1M 都很平稳。BEAM 是一个长上下文记忆基准,Glimmer 报告用的是它的 128K 版本,并称之为“纯文本、非智能体的长上下文记忆评测”。在 4 块 TPU v7 芯片上,vLLM 报告使用 DSpark 投机解码时超过 650 tokens/s,不用时超过 270 tokens/s。
每个 Muse 草稿模型的所有层都用 2,048 token 的窗口,所以即使在 1M 上下文下,每条序列的缓存也保持在 40 MiB 左右(8 × 128 和 16 × 64 两种布局都是如此,推算)。
9. 训练
两个模型是怎么训练出来的?Glimmer 的报告把整条流水线从头讲到尾,Muse Spark 在其中三处担任教师:预训练、监督数据和 on-policy 蒸馏。对于 Spark Open,Meta 说明了权重从何而来(§1.1),模型卡里有一段训练数据说明,对话模板(chat template)中还有一个推理强度控制项。继续训练它的开源代码则来自 TorchTitan 和 RadixArk 的 Miles。本节按这个顺序讲这三部分。
9.1 Glimmer:从 Muse Spark 协同蒸馏
简而言之:Glimmer 的预训练目标是拟合闭源 Muse Spark 记录下来的下一个 token 分布;之后改用普通的下一个 token 标签,把上下文扩展到 128K;后训练则用上了 Muse Spark 生成的数据、Muse Spark 的逐 token 反馈,以及强化学习。本小节中的“Muse Spark”一律指这个闭源教师模型,而不是 Spark Open。
教师与学生共用一份词表。 如 §1.1 所述,Glimmer 和 Spark Open 共用 Llama 4 的 BPE 分词器,词表有 202,048 个条目(200,000 个基础 token 和 2,048 个特殊 token)。报告的“Tokenizer”小节补充说,基础词表的训练语料由“35% 的代码、35% 的多语言文本、15% 的数学和 15% 的英语”组成。有了这份共用词表,本小节其余的做法才变得简单直接。logit 蒸馏训练学生去拟合教师的下一个 token 分布,逐个 token 比较两个模型给出的概率,所以两者必须对同样的 202,048 个条目编号。
训练阶段。 报告描述的是“一个预训练阶段,随后是两个中期训练阶段”,再接三个后训练阶段:监督微调(SFT)、on-policy 蒸馏(OPD)和多目标强化学习。下表概括了每个阶段。
| 阶段 | 数据 | 目标与调度 |
|---|---|---|
| 预训练 | 网页、代码、数学、多语言文本、图像;知识截止日期 2026-01-04 | 对 Muse Spark 前 256 个 logit 的 KL(Kullback–Leibler)散度(前 95%),之后只用交叉熵(最后 5%) |
| 中期训练 1,“领域注入” | 自然数据(organic data)加合成的推理轨迹 | 学习率低于预训练的峰值 |
| 中期训练 2,“智能体能力” | 再加入工具使用和智能体轨迹 | 交叉熵;学习率低于峰值;上下文 32K → 128K |
| SFT | 合成数据与人工数据,“每个数据集大约训练一个 epoch” | 只对助手轮次计算损失(附录样例) |
| On-policy 蒸馏 | 学生的 rollout | Muse Spark 给出的逐 token 分布目标 |
| 多目标 RL | 学生的 rollout,按推理强度分组 | “奖励模型、验证器和任务成功信号”,外加长度惩罚 |
用记录下来的教师 logit 做预训练。 关键的一段是:“我们采用协同蒸馏,在 Muse Spark 预训练期间记录它的前 256 个 logit。以往的做法持续混合软目标与硬目标 [Llama 4];与之不同,在预训练的前 95%,我们的目标函数只有 KL 散度。在最后 5%,我们改用基于真实目标的纯交叉熵(CE)损失,以应对 top-k logit 蒸馏固有的截断偏差。”
教师信号的保存成本很低:每个位置只存 256 个(token, logit)对,而完整的 logit 有 202,048 个,相当于每 789 个取 1 个;即使每个 logit 旁边再存一个 token id,数据量也比完整的一行少几百倍(推算)。Glimmer 的发布博客还提到,Glimmer 的训练“采用与教师相似的数据配比”。
用一个玩具例子(我们构造的示例)来看截断偏差。假设词表只有 5 个 token,教师给下一个 token 的分布是 (0.50, 0.20, 0.10, 0.10, 0.10),只记录其中最大的 2 个。如果像常见做法那样,对保留下来的 logit 重新归一化,目标分布就变成 (0.714, 0.286, 0, 0, 0)。学生于是学得比教师更自信,并且给原本占 30% 概率质量的那些 token 分配零概率。在真实的下一个 token 上算交叉熵可以纠正这一点:如果数据服从教师分布,约 30% 的标签会落在这条尾部里。保留 202,048 个 token 中的 256 个时,尾部通常要轻得多,但学生始终看不到它。报告就这个问题引用了 Anshumann et al. 2025(arXiv 2503.16870)。
Checkpoint 平均与中期训练。 预训练以 checkpoint 平均(“souping”,即“模型汤”)收尾。报告“在训练的最后 5% 每 200 步保存一个 checkpoint(共 84 个)”,然后把“最后一个 checkpoint 与之前三个间隔 600 步的 checkpoint”取平均。由此可知,最后 5% 共 84 × 200 = 16,800 步,整个训练约 336,000 步,1,800 步的平均窗口完全落在交叉熵阶段之内(均为推算)。中期训练第 2 阶段“把上下文窗口从 32K 扩展到 128K token”(4×),并且用交叉熵而不用教师 logit,理由是“长上下文和智能体数据带来的分布偏移,使教师 logit 在这一阶段不那么可靠”。按我们的理解,这次扩展不需要任何位置缩放,因为 RoPE 只存在于 2,048 token 的局部层(§3.4、§7.1)。
合成的智能体数据。 智能体数据来自一个运行在 Docker 容器里的智能体 harness,它与一组模拟应用交互(邮件、日历、文档、WhatsApp、代码仓库和命令行工具)。其设计遵循 Agents Research Environments(ARE,arXiv 2509.17158)的原则:每个“宇宙”(universe)都是“一个由 10–14 个联系人组成的关系网所支撑的人设”。失败的轨迹和缺乏依据(ungrounded)的轨迹会被丢弃,“不良”步骤(例如“错误的工具调用”)则从损失中屏蔽掉。
后训练。 后训练依次是 SFT、OPD、多目标 RL,报告给出了设置中间这一阶段的理由:“与从 SFT 直接进入 RL 相比,这个中间阶段始终能改善下游 RL 的结果。”Glimmer 的发布博客把后面两个阶段描述为“on-policy 蒸馏与强化学习的混合”。SFT 与 OPD 之间还夹着一个小节“Rollouts extraction”(rollout 提取),描述从“多次不同的 RL 和 RLHF 运行”(RLHF:基于人类反馈的强化学习)中收集 Muse Spark 的轨迹,只保留“奖励高于某个阈值”的那些。在 OPD 中,“学生生成 rollout,教师在学生访问过的前缀上提供逐 token 的分布目标”,这里引用的是 Agarwal et al.,即提出广义知识蒸馏(GKD,arXiv 2306.13649)的论文;我们的 Miles 文章 §8.1 展示了具体机制。
推理模式。 Glimmer 在 RL 阶段学会了四档推理强度,做法是“把每个 prompt 的样本分成若干子组,每个子组按其分配到的推理强度施加相应的长度惩罚”。由于高强度样本“是能力习得的主要驱动力”,“有一定比例的 prompt 只分给较高的强度”。报告在多语言知识基准 MMLU-ProX 上的表格展示了效果:从 low 到 xhigh,每个 rollout 分别用 557、1,180、2,453 和 3,397 个 token(含推理部分),pass@1(单次采样回答的准确率)分别为 76.9、79.3、80.1 和 80.0。可见 xhigh 花的 token 是 high 的 1.38×,pass@1 与 high 基本持平(推算)。报告把 high 设为智能体场景的默认值,xhigh 则留给“离线或评测场景”。
可信的本地智能体工作流。 隐私保护和抵御提示注入这两项能力,SFT 和 RL 阶段都有专门训练。隐私方面,Muse Spark 在系统提示词的指令下生成 SFT 轨迹,训练前再把这些指令删掉(“提示蒸馏”);RL 则惩罚“过度分享”。抗注入方面,Muse Spark 的智能体安全轨迹经过拒绝采样,RL 惩罚任何“智能体执行了攻击者植入的操作”的轨迹。在附录给出的数据格式里,工具输出被包上一个 SECURITY NOTICE 标头和 <<<EXTERNAL_UNTRUSTED_CONTENT>>> 哨兵标记,“使模型把其中的内容视为不可信”。
ATEM。 工具调用采用 Agent Tool Calling Format(ATEM),即“用于工具调用的、基于 XML 的格式”。每条助手消息都带一个接收方:to=self 表示推理,to=namespace.function 表示一次调用,to=user 表示结束本轮的回答。报告给出的例子是:
to=bash.exec <atem:function_calls> <atem:invoke name="bash.exec"> <atem:parameter name="cmd">ls /workspace</atem:parameter> </atem:invoke>
</atem:function_calls>
在附录的训练样例中,系统、用户和工具轮次都带 "keep_loss": false,而每个助手轮次(推理、调用和回答)都带 "keep_loss": true, "loss_weights": 1.0。
9.2 Spark Open:来历、数据与推理强度控制
§1.1 引用过 Meta 对 Spark Open 来历的描述:它的模型页面说,Spark Open 源自 8 月发布的 Muse Spark 模型,并“额外做了安全后训练,使它作为没有系统护栏的独立模型时更能抵御滥用”。PyTorch 博客介绍了它被训练来做的工作:真实的开发者工作流、网页浏览、子智能体、操作计算机(computer use),以及“长周期、跨多个站点的任务”。模型卡补充说,训练数据包括“文本、图像、音频和视频”,来源有公开数据、网络爬取数据、第三方数据、Meta 产品数据和合成数据,涵盖“100 多种语言”。对话模板默认的知识截止日期是 2026-01-04。
2026 年 5 月提交的《Muse Spark Safety & Preparedness Report》(arXiv 2606.12429)讨论的是部署在 Meta AI 中的原版 Muse Spark,而不是 Spark Open。它对 Muse Spark 训练的描述包括:拒答可以“由模型层面的缓解措施触发,例如 Muse Spark 和开放权重模型的安全微调”;Meta 做了“结合自适应和自动化红队方法的对抗训练”;流水线中包括“中期训练和 SFT 数据生成”。
推理强度控制。 已发布的对话模板把 reasoning_effort 转换成一个数字:
{%- set reasoning_effort = reasoning_effort | default('xhigh', true) -%}
{%- set reasoning_effort_map = {'low': 8, 'medium': 32, 'high': 256, 'xhigh': 512} -%}
传入其他任何值都会报错,提示词指南也说“推理无法关闭”。默认情况下,模型会在工具定义之后读到 Reasoning strength: 512.;如果调用方在系统提示词里写了一行“Reasoning strength”,它“优先于 reasoning_effort”。相邻两档之间的倍数依次是 ×4、×8 和 ×2,所以 xhigh 是 low 的 64×(推算)。设置文档和 TorchTitan 的渲染器使用同一套映射。下表把两个模型的控制方式并排列出。
| Muse Spark Open | Muse Glimmer 30B | |
|---|---|---|
| 模板参数及默认值 | reasoning_effort,xhigh |
reasoning_strength,high |
| 渲染出的那一行 | Reasoning strength: 512.(数字) |
Reasoning strength: high.(单词) |
| 未知取值 | 报错 | 原样传入 |
| 推荐的采样参数 | 温度 1.0,top_p 1.0,不用 top_k | 温度 1.0,top_p 0.95,top_k 64 |
根据设置文档,Spark 模型卡中的评测都在 xhigh、温度 1.0、top_p 1.0 下运行。
9.3 自己动手训练:TorchTitan 与 Miles
公开的代码展示了如何继续训练 Spark Open,以及要付出多大代价。Meta 的后训练文档列出了七种继续训练这个 checkpoint 的方式,这里按类别归组(LoRA 即低秩适配;DAPO 和 GRPO 是两种 RL 算法,下文会解释):
| 方式 | 类型 | 方法(据文档) |
|---|---|---|
| TorchTitan | 开源 | LoRA 或全参数 SFT(文本、图像、音频);用 DAPO 做 RL |
| Miles | 开源 | 在 64 张 GPU 上做 GRPO,用 SGLang 生成 rollout |
| NeMo AutoModel、Megatron Bridge | 开源(NVIDIA) | 全参数 SFT 和 LoRA;Megatron 训练 |
| TRL | 开源 | LoRA SFT |
| Together AI、Fireworks AI | 托管服务 | SFT、RL;Fireworks 另外提供直接偏好优化(DPO)、比值比偏好优化(ORPO)和蒸馏 |
TorchTitan。 PyTorch 博客说:“TorchTitan 已经开箱即用地支持以开源方式对 Muse Spark 做监督微调和 RL。”torchtitan_recipes/models/muse_spark.py 和 rl/dapo_math.py 中的训练配方如下:
- 全参数训练:在 C4 网页语料上做“从 Muse Spark Open checkpoint 出发的文本续写”;AdamW,学习率 5e-5(路由器为其 0.125×,即 6.25e-6),余弦衰减,共 120 步,每步 32 × 32,768 = 1,048,576 个 token,总计约 126M token,默认用 128 张 GPU(推算)。
- Dist-MoE 规模(Dist-MoE 是 TorchTitan 的分布式专家后端):256 张 GPU 上 96K 上下文,512 张 GPU 上 192K,每步 128 条序列,即每步约 12.6M 和 25.2M token(推算)。
- LoRA SFT:rank 8,作用于
wqkv, wo, output_gate, w13, w2(TorchTitan 的模块名),上下文 131,072 token,16 张 GB300,在openbmb/UltraData-SFT-Agent-2609上训练 1,000 步。 - TitanRL DAPO(Decoupled Clip and Dynamic sAmpling Policy Optimization,解耦裁剪与动态采样策略优化,arXiv 2503.14476):“五个单轮、on-policy 的步骤,每步 8 个 prompt,每个 prompt 采样 8 次”,使用
reasoning_effort="low";按文档,它运行在 256 张训练 GPU 加 16 张生成 GPU 上。
如果你希望训练时的计算与发布的模型完全一致,有两个细节要注意。第一,两个 Dist-MoE 规模配方(256 张 GPU 上 96K、512 张 GPU 上 192K)把专家的激活函数换成了 ClampedSwiGLU(swiglu_alpha=1.702, swiglu_limit=7.0),它计算的是带钳位的 $g\,\sigma(1.702\,g)\,(u+1)$,而不是发布模型中的 $\mathrm{silu}(g)\,u$(§4.3)。全参数、LoRA 和 DAPO 配方保留了发布模型的激活函数,尽管后两者同样运行在 Dist-MoE 上。第二,路由偏置会一直变化。816B 的 flavor 设置了 load_balance_coeff=1e-3,因此在每次优化器更新之前,TorchTitan 都会把每个专家的偏置朝负载均衡的方向推动 ±0.001,再减去均值;§4.2 写出了这条规则,代码的注释也指出它与 arXiv 2408.15664“并不完全相同”。我们的理解是,e_score_correction_bias 正是这条规则所学习的那类偏置,所以全参数微调会不断改变发布的偏置,除非设置 freeze_expert_bias:这样路由时仍使用偏置,但从不更新它。
Miles。 RadixArk 的 Muse Spark Open 页面是一份“在 64 张 H200 或 32 张 B300 GPU 上做全参数 GRPO”的配方(启动脚本在 muse-spark-open 分支上);框架本身见我们的 Miles v0.1 深度解析。该页面在 H200 和 B300 上验证了数学推理。GRPO(Group Relative Policy Optimization,组相对策略优化)不用学出来的价值模型,而是拿每个回答与同一 prompt 的其他回答作比较来打分。与 PPO(Proximal Policy Optimization,近端策略优化)一样,它把每个 token 的优势值乘以新旧策略概率之比,并对这个比率做裁剪,这里裁剪到 [0.8, 1.28](即表中的下 0.2、上 0.28)。下表列出这份配方的设置,取自该页面及其共用脚本;“布局”一行给出 TP、EP 和流水线并行(PP)的并行度。
| 设置 | 取值 |
|---|---|
| 数据、奖励 | DAPO-Math-17k(加 --vlm 时用 Geometry3K);最终 \boxed{} 中的答案正确记 1,否则记 0 |
| batch、长度 | 32 个 prompt × 16 个样本 = 512 个 rollout,每步一次更新;回答 ≤ 4,096 token;reasoning_effort 为 xhigh(页面上的 --vlm 示例用 medium) |
| 损失 | GRPO,裁剪范围下 0.2 / 上 0.28,无 KL 项和熵项,逐 token 损失,rollout 路由重放(R3) |
| 优化器 | Adam,学习率恒为 1e-6,权重衰减 0.1,不做梯度裁剪;优化器状态流式写到节点本地的 NVMe |
| 布局(64 × H200) | TP 8 × PP 8 × EP 8;4 个 SGLang 引擎,每个 16 张 GPU,BF16 KV cache |
算一次更新(我们构造的示例):如果某个 prompt 的 16 个回答中有 12 个正确,平均奖励就是 0.75,于是正确回答的优势值为 +0.25,错误回答为 −0.75(未做任何缩放)。512 个 rollout 恰好构成一次优化器更新,而旧的对数概率就是“训练前向过程中 detach 掉的对数概率”(common.py)。页面报告,在 H200 上跑数学任务时,SGLang 采样器与 Megatron 训练器之间的对数概率差异为 0.007(train/train_rollout_logprob_abs_diff)。R3 重放一个记录所选专家的 int32 张量,形状为 (seq_len − 1, layers, top_k),让路由翻转不会混进这个差异;每个样本最多 8,191 × 62 × 8 × 4 B ≈ 16.25 MB(推算)。没有 R3 时路由为什么会翻转,见我们的 Miles 文章 §4.1。
这份配方冻结视觉塔和音频塔:它们“留在 checkpoint 里,但不参与训练”。页面给出的磁盘数字来自语言模型的优化器状态:FP32 主权重加上两个 FP32 的 Adam 矩估计,每个参数共 12 B,所以约 820.0B 个语言模型参数需要 9.84 TB,分到 8 个节点上每节点 1.23 TB,分到 4 个节点上每节点 2.46 TB,页面写作“约 1.2 TB”和“B300 上 2.5 TB”(推算)。RadixArk 报告,在数学任务上,奖励在 10 步之内从 0.65–0.75 升到 0.8–0.95。
实现细节
- 只对助手轮次计算损失。 Spark 的模板用
{% generation %} … {% endgeneration %}包住助手轮次,这正是 Transformers 为return_assistant_tokens_mask使用的标记,与 Glimmer 的keep_loss是同一种约定。模板中列出工具的那个宏上方有一条注释,写的是“每个函数占一行,与训练渲染器打印的格式一致”。TorchTitan 的MuseSparkRendererConfig使用相同的强度映射和知识截止日期,但默认reasoning_effort="medium"。 - 其他章节已有交代。 训练移植必须复现的嵌入路径(无权重 RMSNorm,Transformers、llama.cpp 和 TorchTitan 都没有乘子)见 §5.4 及其实现细节;TorchTitan 从零训练时的残差门初始化,以及 Hugging Face 的随机初始化,见 §5.2 的实现细节。
参考资料
本文的每个数字都能追溯到下列资料;我们自己的计算、理解以及从图上读出的数值,正文中都有相应标注。所有资料均于 2026 年 10 月 27 日查阅。指向 llama.cpp、mlx-lm、TorchTitan、Miles 和 TensorRT-LLM 的链接指向的是会继续变动的分支,之后的提交可能改动我们引用的代码;文中的引用与当天的代码一致。
模型卡与配置
- meta-models/Muse-Spark-Open-816B-A42B-NVFP4:Spark Open 的官方模型卡以及 NVFP4 checkpoint;还有 Hub API 列出的它的
quantization_config(§4.5、§7.4)。 - meta-models/Muse-Spark-Open-816B-A42B:BF16 checkpoint;它的 Hub API 记录给出参数总数和各数据类型的计数,§2.3 对这些数字逐一核对。
- mlx-community/Muse-Spark-Open-816B-A42B-3bit:一个公开的 MLX 转换版本,按 Muse Model License 再分发模型,只增加了量化相关的键;本文通篇引用的是它的
config.json和对话模板。 - meta-models/Muse-Glimmer-30B:Glimmer 的模型卡、
config.json和权重索引(Apache 2.0,直接下载);Hub API 记录。 - meta-models/Muse-Glimmer-30B-assistant:Meta 为 Glimmer 提供的 DFlash 草稿模型(§8.2);Glimmer 的 GGUF 和 ExecuTorch 导出版本(§7.4)。
- 第三方为 Spark Open 提供的草稿模型:RadixArk DFlash2、NVIDIA DFlash2 和 Inferact DSpark;Glimmer 方面有 z-lab 的 DFlash2。
- 合作伙伴为 Spark Open 制作的量化版本:AMD MXFP4、AMD PTPC-FP8、Intel INT4、ggml-org GGUF 和 Unsloth GGUF,以及按位宽列出内存需求的 Unsloth 指南(§7.4)。
代码
- Transformers
models/muse_spark(v5.20.0):参考实现。其中 modular 文件是相对 Glimmer 的差异部分,建模、配置和音频特征提取文件才是实际运行的代码。经由 PR #49644 加入;模型文档。 - Transformers
models/muse_glimmer:首次发布于 v5.15.0,我们读的是 v5.20.0 的代码(建模文件、modular 文件,以及图像和视频处理器),另有草稿模型的实现。 - Transformers v5.20.0 中的共用代码:掩码与缓存工具(滑动窗口,§3.4、§7.2)、DFlash 候选生成器(§8.2)、MoE 集成(§4.3)和 RoPE 工具(§6.1);来自 Gemma 2 和 Voxtral Realtime 的父类,以及作为对照的 Llama 4。发布说明:v5.15.0 和 v5.20.0。
- llama.cpp:Spark 和 Glimmer 的计算图;Spark 和 Glimmer 的 GGUF 转换脚本,它们把归一化、门控和缩放折叠进权重;以及音频编码器的计算图。
- mlx-lm
muse_spark.py:MLX 移植版,残差流用 FP32,门控系数预先算好(§4.4、§5.2)。 - TorchTitan
models/muse_spark:Spark Open 的一个公开训练实现。它的 flavors 文件里有 43.7840518911 这个常数(§3.2),model 文件里是注意力和残差模块,共用的 MoE 代码里是专家偏置的更新(§4.2)。训练配方:微调和 DAPO RL(§9.3)。 - Miles:Muse Spark Open 训练配方:在 64 张 H200 或 32 张 B300 GPU 上做全参数 GRPO;另有它的共用启动脚本和 rollout 路由重放(R3)文档(§9.3)。
- Megatron-LM
transformer_config.py:其中潜空间 MoE 和 MoE 归一化的相关选项,§4.3–4.4 拿它们与 Muse 作比较。
论文
Muse
- Muse Glimmer 30B: An On-Device Agentic Model(arXiv:2610.24628):Glimmer 的技术报告,涵盖架构、稠密与 MoE 的模型阶梯对比、MLA 实验、训练、量化和草稿模型。论文页面。
- Muse Spark Safety & Preparedness Report(arXiv:2606.12429):对部署在 Meta AI 中的闭源 Muse Spark 所做的安全评估,评估对象不是 Spark Open(§9.2)。
注意力与位置(§3)
- GQA(Ainslie et al., arXiv:2305.13245):分组查询注意力。
- Gated Attention for Large Language Models(Qiu et al., arXiv:2505.06708):与 Muse 的输出门控和逐头输出归一化最接近的公开研究。
- QKNorm(arXiv:2010.04245)、ViT-22B(arXiv:2302.05442)、Gemma 2(arXiv:2408.00118) 和 Gemma 3(arXiv:2503.19786):query-key 归一化、logit 增长,以及被它取代的软截断;Gemma 2 也是三明治归一化的出处(§5.1)。
- RoFormer(arXiv:2104.09864)、Transformer language models without positional encodings(Haviv et al., arXiv:2203.16634) 和 Kazemnejad et al. 关于长度泛化的研究(arXiv:2305.19466):RoPE,以及不带位置的层为什么仍能学到顺序。
- Rope to Nope and Back Again(Cohere, arXiv:2501.18795):与 Muse 最接近的 RNoPE-SWA 布局,以及 QK-norm 在检索上的权衡。
- Mistral 7B(arXiv:2310.06825)、StreamingLLM(arXiv:2309.17453) 和 RetNet(arXiv:2307.08621):层层堆叠的滑动窗口、注意力汇点,以及门控之前的逐头归一化。
- DeepSeek-V2(arXiv:2405.04434) 和 RULER(arXiv:2404.06654):MLA,以及让 Glimmer 的 MLA 变体落败的那个基准(§3.5)。
混合专家(§4)
- DeepSeek-V3 Technical Report(arXiv:2412.19437) 和 Auxiliary-Loss-Free Load Balancing(Wang et al., arXiv:2408.15664):256 个专家、top-8,以及基于偏置的负载均衡。
- LatentMoE(arXiv:2601.18089):在完整的 token 上做路由,专家在压缩后的潜空间里运行,Spark 的 MoE 正是这种设计;Nemotron 3(arXiv:2512.20856) 和 Nemotron 3 Super(arXiv:2604.12374) 也采用了它。
残差流与缩放规则(§5)
- DeepNet(arXiv:2203.00555)、CogView(arXiv:2105.13290)、Peri-LN(arXiv:2502.02732) 和 CaiT / LayerScale(arXiv:2103.17239):前置归一化、后置归一化、三明治归一化,以及逐通道的分支缩放。
- Tensor Programs V / µP(arXiv:2203.03466)、u-µP(arXiv:2407.17465) 和 Unit Scaling(arXiv:2303.11257):输出乘子的宽度迁移规则,以及 $a^2 + b^2 = 1$ 这一残差条件。
- nGPT(arXiv:2410.01131):一种带可学习逐通道步长的归一化 Transformer,本文拿它与 Spark 的残差门作比较。
感知(§6)
- Perception Encoder(arXiv:2504.13181):两个模型共用的视觉塔。
- NaViT(arXiv:2307.06304):原生分辨率下的 patch 打包。
- ConvNeXt(arXiv:2201.03545):音频编码器的卷积块所近似的块结构。
投机解码与训练(§8–9)
- DFlash: Block Diffusion for Flash Speculative Decoding(arXiv:2602.06036):所有 Muse 草稿模型背后的草拟方法。
- Sparse Logit Sampling: Accelerating Knowledge Distillation in LLMs(Anshumann et al., arXiv:2503.16870):Glimmer 报告引用的 top-k logit 蒸馏的截断偏差。
- On-policy distillation / GKD(Agarwal et al., arXiv:2306.13649)、Agents Research Environments(arXiv:2509.17158) 和 DAPO(arXiv:2503.14476):§9 提到的后训练、智能体数据和 RL 方法。
博客与文档
- Meta 的发布文章:Muse Spark Open(2026 年 10 月 15 日)、Muse Glimmer(8 月 10 日),以及闭源产品线的 Muse Spark(4 月 8 日)、Muse Spark 1.1 与 Meta Model API(7 月 9 日)、Muse Code 与 Muse Spark 1.2(8 月 5 日)和 Muse Spark 1.3(9 月 2 日)(§1.1)。
- Meta 的 Spark Open 模型页面(含那句谱系说明),以及开发者文档:概览、设置、提示词、部署、硬件平台和后训练;还有一篇介绍格式、硬件和草稿模型的开发者博客。
- Meta 的 Glimmer 文档:获取模型、量化(含实测的 131,072 token 预算)和部署。
- PyTorch 博客:Muse Spark Open:Spark Open 被训练来做的工作,以及 TorchTitan 的支持(§9.2、§9.3)。
- Llama 4 博客:交错的 NoPE 层、MetaP 和 Maverick 的 MoE 布局,用作对照。
- Hugging Face:Muse Spark Open:发布时的详细导读,包括残差门和各个编码器。
- vLLM 首日支持博客和 SGLang / LMSYS 首日支持博客:推理服务、KV cache 和草稿模型的相关细节(§4.4、§7、§8)。
- TensorRT-LLM 的 Spark Open 部署指南:在 GB300 上对 FP8 KV cache 的要求(§7.2)。
- DFlash 2: Keep Drafting Parallel(Inco AI):DFlash2 草稿模型中的路径选择器和双抽头卷积(§8.3)。
本站相关文章
- 逐层拆解 Muse Spark Open 与 Muse Glimmer(Google Slides):本文的配套幻灯片。
- 逐层拆解 GLM-5.3 与 GLM-5.3-Flash:从零讲解 MLA、带偏置均衡的 MoE 路由、NoPE 注意力和 mHC。
- 逐层拆解 DeepSeek-V4 与 V4-Flash:带注意力汇点的滑动窗口、用 YaRN 扩展到 1M 个位置、mHC 和 DSpark 草稿模型,即 §3、§4、§5、§7 和 §8 所用的对照。
- Miles v0.1 深度解析:rollout 路由重放(R3)与 on-policy 蒸馏,即 §9.3 背后的 RL 框架。